








3 10月 2023 | リサーチ
GAIA-1のスケーリング:自動運転のための90億パラメータ生成世界モデル
2023年6月、当社はGAIA-1を発表し、自動運転のための最先端生成モデルの最初の概念実証を行いました。この数ヶ月間、GAIA-1を最適化し、高解像度でのビデオ生成を効率的に可能にするとともに、より大規模なトレーニングによって世界モデルの品質を向上させてきました。本ブログ記事では、GAIA-1のテクニカルレポートと、GAIA-1を90億以上のパラメータにスケーリングした結果を公開できることを嬉しく思います。
GAIA-1によって生成された運転シナリオ画像のモンタージュ
概要
GAIA-1は、自動運転のために構築された最先端の生成世界モデルです。世界モデルは環境とその将来のダイナミクスの表現を学習し、周囲の状況を構造的に理解することで、運転時の情報に基づいた意思決定に活用できます。将来の出来事を予測することは、自律走行システムにおいて基本的かつ極めて重要な側面です。正確な将来予測により、自動運転車両は自身の行動を予測・計画することが可能になり、道路上の安全性と効率性が向上します。世界モデルを運転モデルに組み込むことで、人間の意思決定をより深く理解し、最終的にはより多くの現実世界の状況に一般化できる可能性が生まれます。
GAIA-1は、ビデオ、テキスト、アクションの入力を活用して現実的な運転ビデオを生成するモデルであり、自車行動やシーンの特徴をきめ細かく制御できます。マルチモーダルな性質により、GAIA-1は多くのプロンプトモダリティやその組み合わせからビデオを生成することが可能です。
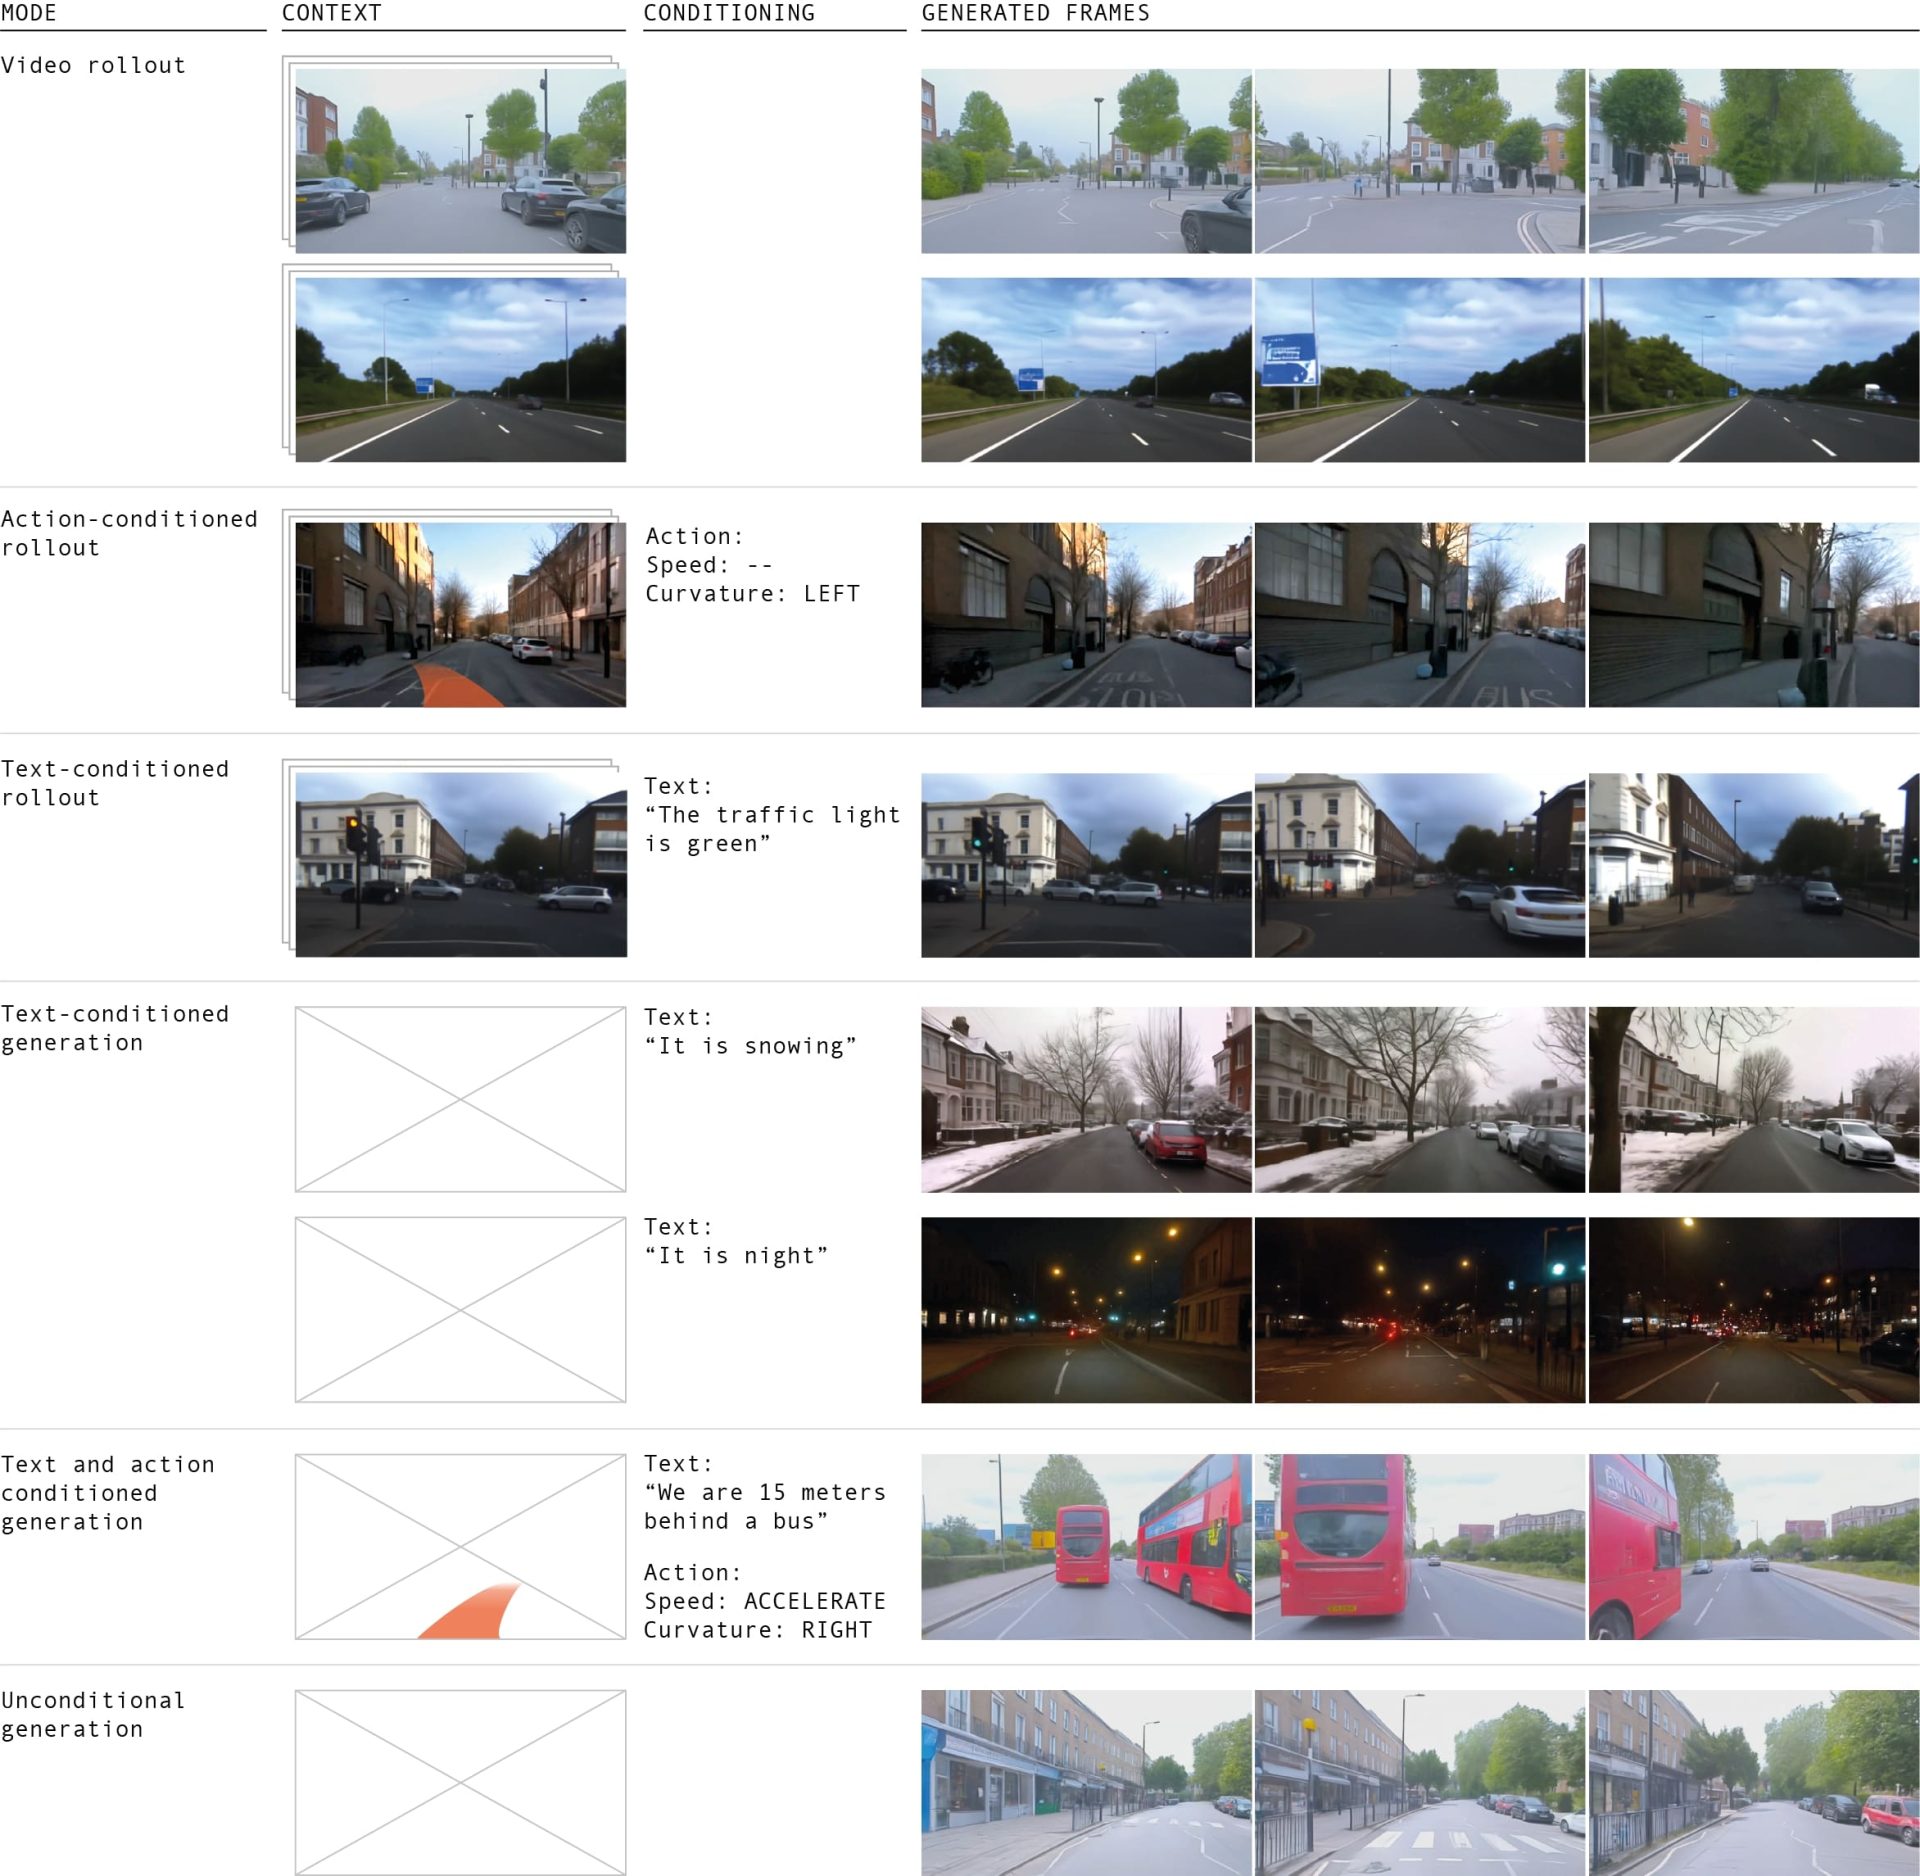 GAIA-1がビデオ生成に使用できるプロンプトの種類の例。GAIA-1は、ビデオプロンプトから開始して将来の展開を実行することでビデオを生成できます。これらの将来の展開は、自車の特定の行動(例:左にハンドルを切る)に影響を与えるアクションや、シーンのいくつかの側面(例:信号の色を変える)の変化を促すテキストによってさらに条件付けられます。
速度と曲率については、将来の速度や曲率の値のシーケンスを渡すことでGAIA-1を条件付けます。GAIA-1は、テキストプロンプトから、あるいは単に事前分布からサンプルを抽出することによっても、現実的なビデオを生成できます(完全な無条件生成)。
GAIA-1は、高い制御性を持って運転シーンの現実的なビデオを生成できます。以下の例では、GAIA-1によって生成された短いビデオをご覧いただけます。このモデルは、路面に雪がある夜間の運転データを生成しています。
モデルアーキテクチャとトレーニング
下の図は、GAIA-1の一般的なアーキテクチャを示しています。
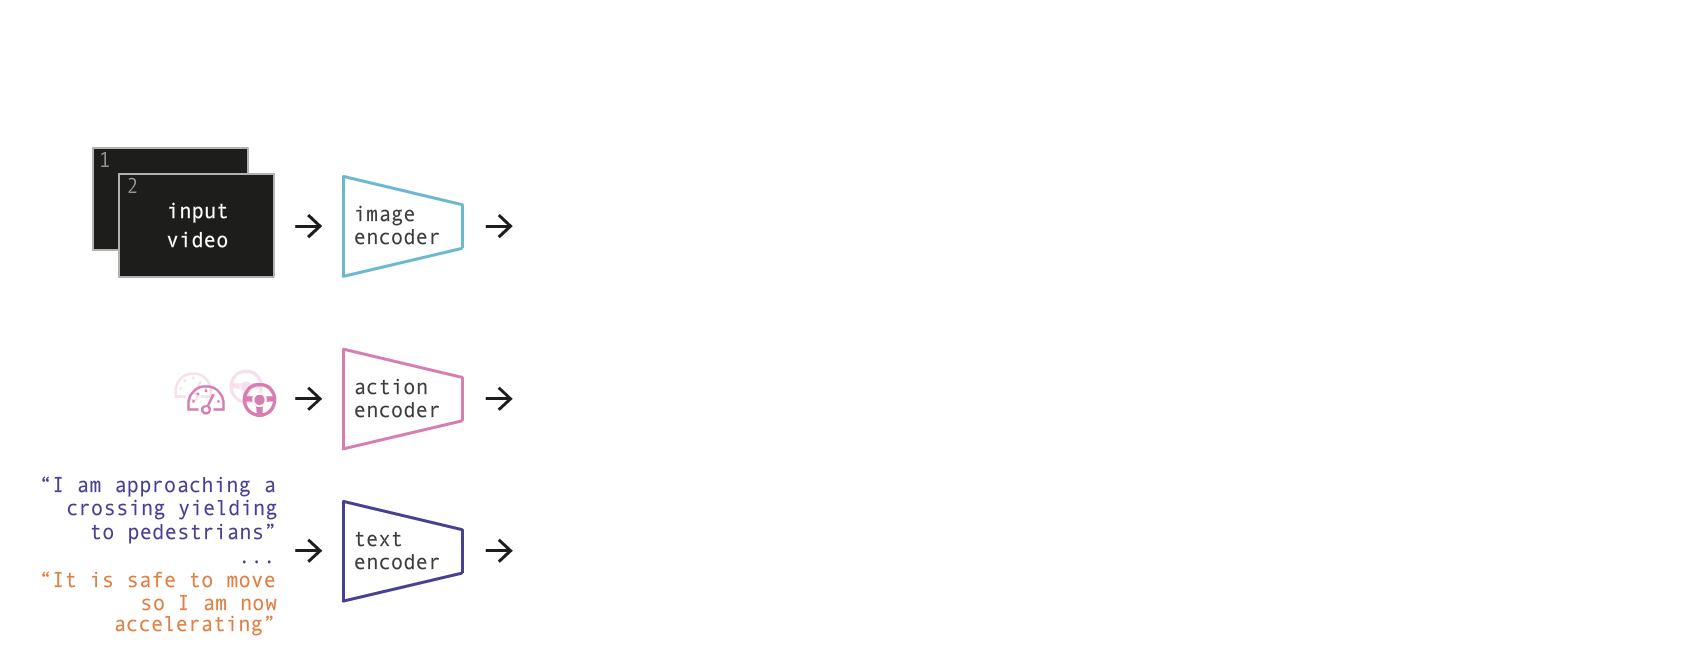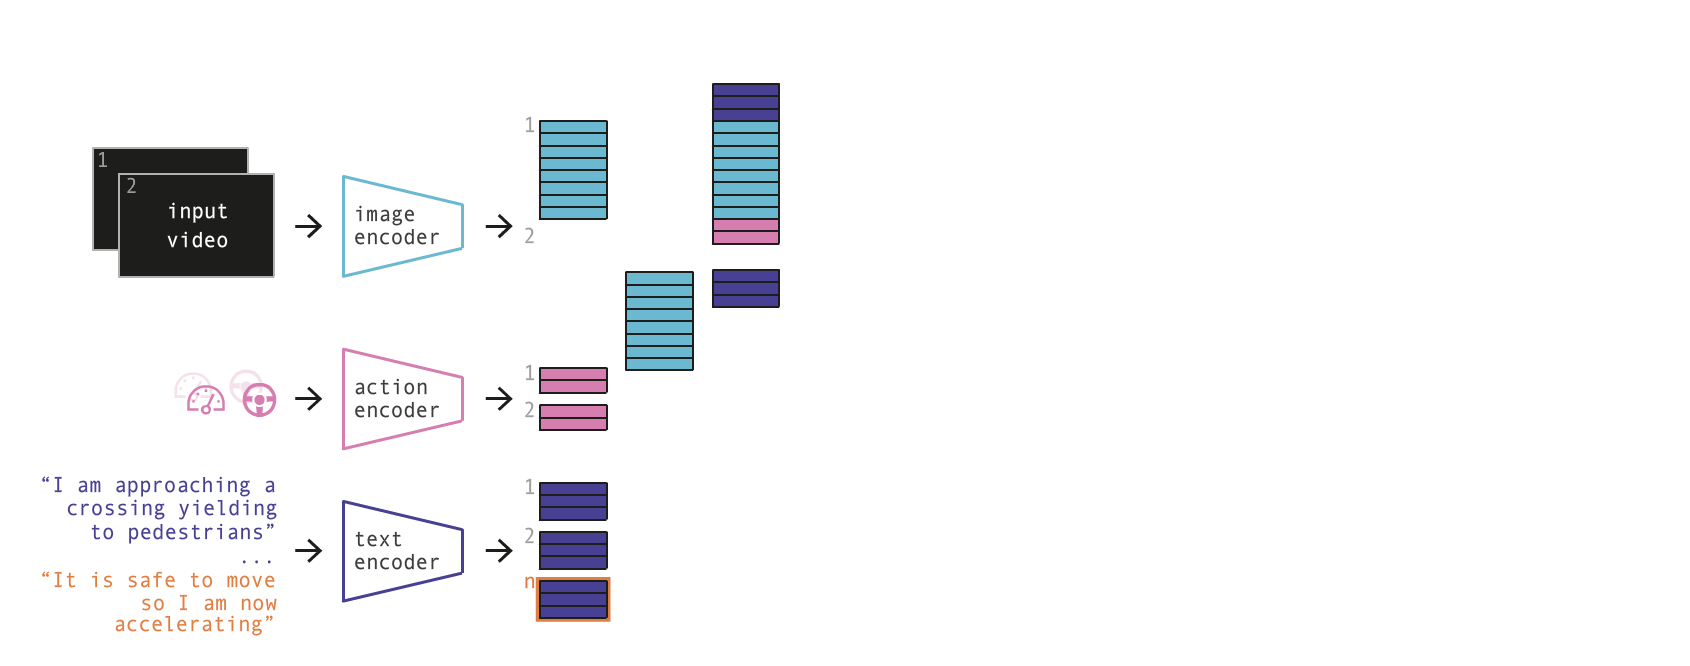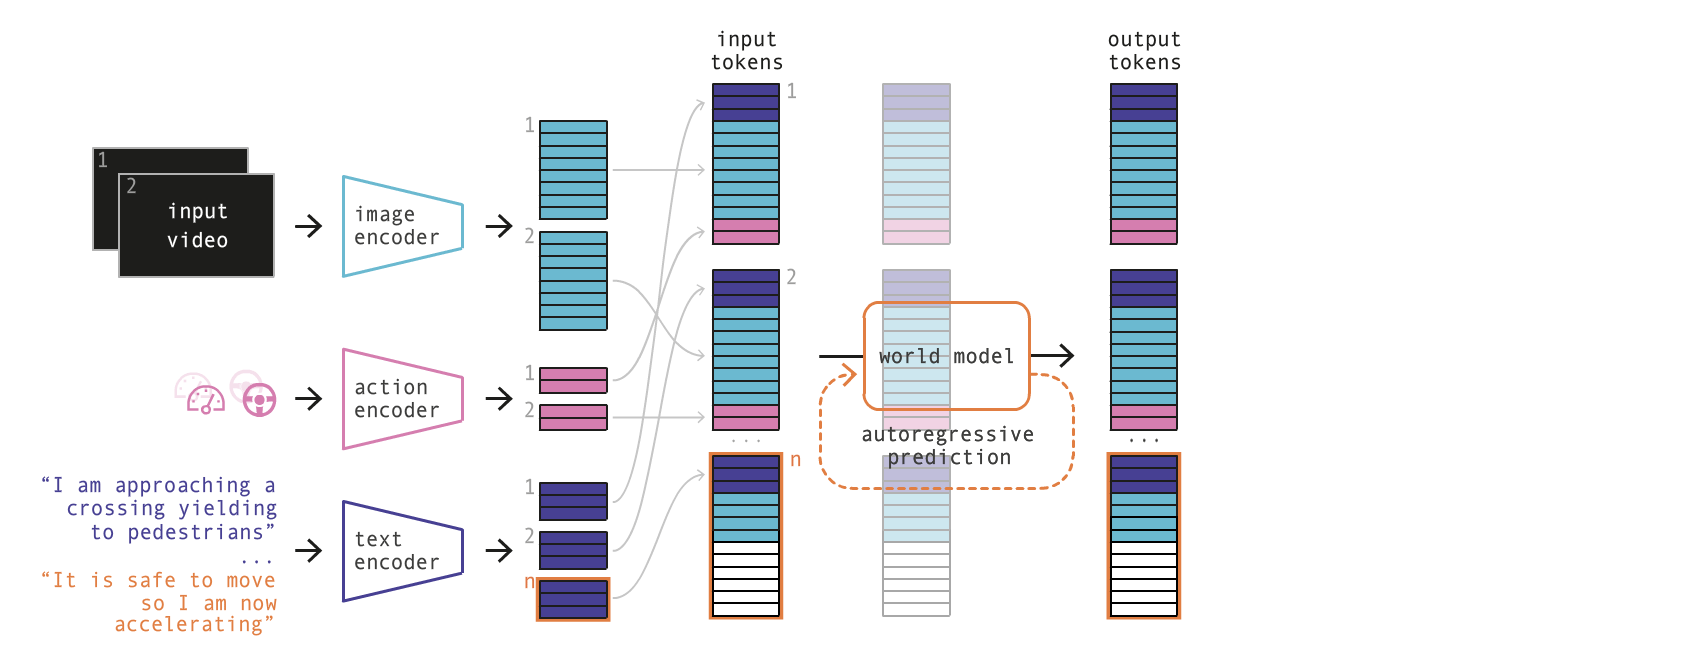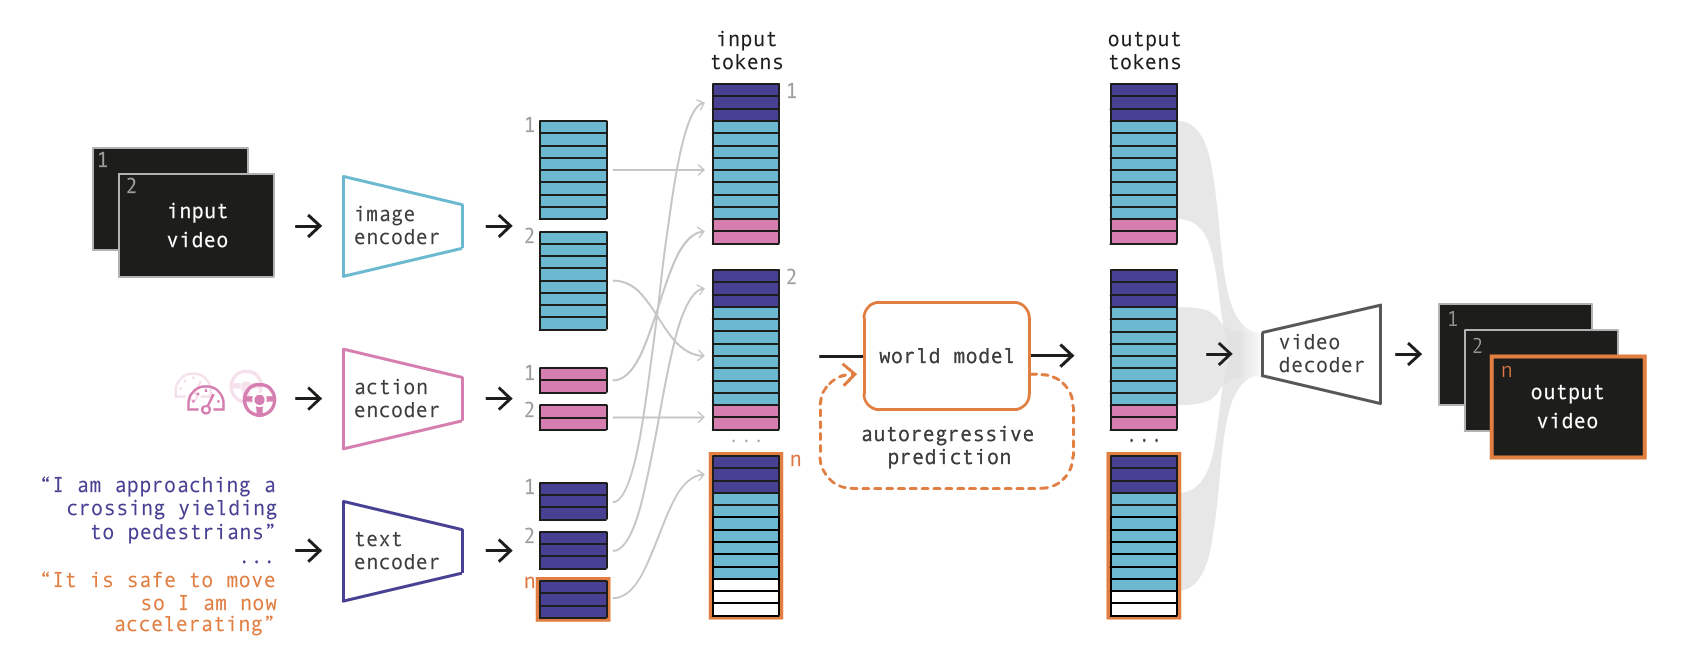 GAIA-1のモデルアーキテクチャ
まず、GAIA-1は各モダリティ(ビデオ、テキスト、アクション)専用のエンコーダーを介してすべての入力をエンコードします。これらのエンコーダーは、多様な入力ソースを共有表現に投影します。テキストとビデオのエンコーダーは入力を離散化して埋め込み、アクションを表すスカラーは独立して共有表現に投影されます。これらのエンコードされた表現は、一貫したタイムラインを共有するように時間的に整列されます。
このアライメントに続いて、モデルのコアコンポーネントである世界モデルが登場します。世界モデルは自己回帰トランスフォーマーです。このトランスフォーマーは、シーケンス内の次の画像トークンセットを予測します。これは、過去の画像トークンだけでなく、テキストやアクションのトークンによって提供されるコンテキスト情報も考慮することで実現されます。この包括的なアプローチにより、モデルは視覚的に一貫しているだけでなく、意図したテキストおよびアクションベースのガイダンスとも一致する画像トークンを生成できます。GAIA-1の世界モデルは65億のパラメータを持ち、64台のNVIDIA A100で15日間トレーニングされました。
最後に、ビデオデコーダーであるビデオ拡散モデルを使用して、これらの予測された画像トークンをピクセル空間に変換します。ビデオ拡散モデルは、生成されたビデオが意味的に有意義で、視覚的に正確で、時間的に一貫していることを保証する重要な役割を果たし、生成されたコンテンツの全体的な品質を向上させます。GAIA-1のビデオデコーダーは26億のパラメータを持ち、32台のNVIDIA A100で15日間トレーニングされました。
GAIA-1には90億以上の学習可能なパラメータがあります(6月バージョンのGAIA-1の10億パラメータと比較)。GAIA-1のトレーニングデータセットは、2019年から2023年の間に英国ロンドンで収集された4,700時間の独自運転データで構成されています。
スケーリング則
GAIA-1における世界モデリングタスクの定式化は、大規模言語モデル(LLM)で一般的に採用されている手法と密接に似ています。どちらの場合も、タスクは次のトークンの予測に簡略化されています。この手法はGAIA-1では言語ではなくビデオモデリングに適用されていますが、LLMで観察されるものと同様のスケーリング則がGAIA-1にも適用されることは注目に値します。
下のプロットは、GAIA-1の世界モデルのパフォーマンスのスケーリング曲線を示しています。青い点は、より小さなバリアントで測定された検証クロスエントロピーです。モデルの総計算量はFLOPsで測定されます。データ点にべき乗則曲線を当てはめることで、より大きな計算予算に対する検証パフォーマンスを推定することができました。オレンジ色の点は、GAIA-1世界モデルの最終的な検証クロスエントロピーを表しています。比較として、2023年6月のGAIA-1の小型バージョンは、外挿に使用された最後の2つの青い点の間に位置します。興味深いことに、当社の推定からは、データと計算量をスケーリングすることで得られる改善の余地がまだ十分にあると結論付けられます。
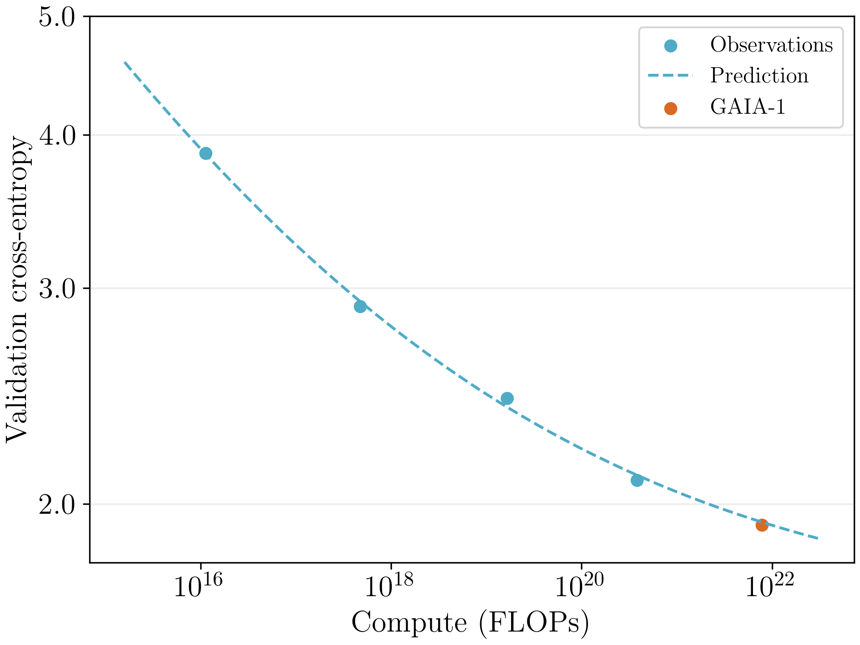
これらのスケーリング則は、大規模言語モデルのパフォーマンスと能力における特徴的なパターンとして特定されています。ドメインがテキストベースの言語タスクからビデオモデリングへとシフトしているにもかかわらず、GAIA-1は類似の傾向を示しています。これは、GAIA-1のモデルサイズとトレーニングデータがスケールアップするにつれて、ビデオ生成タスクにおける習熟度とパフォーマンスが向上し続け、それぞれのドメインに適用された際の大規模言語モデルで見られるスケーラビリティの傾向を反映していることを示唆しています。
本質的に、ビデオの文脈における次のトークン予測に焦点を当てたGAIA-1の世界モデリングタスクは、テキストや言語タスクの領域で大規模言語モデルの象徴となったスケーリング挙動を共有しています。これは、自動運転を含む多様なドメインにわたる現代のAIモデルにおけるスケーリング原理の広範な適用可能性を強調するものです。
向上したビデオ生成
画像解像度の向上、パラメータ数の増加、トレーニング期間の延長、およびデータセットサイズの拡大を含む包括的なスケーリング戦略を通じてGAIA-1の能力を高めた結果、ビデオ生成の品質において実質的かつ印象的な向上がもたらされました。
以下の例は、2023年6月時点と現在のGAIA-1で生成されたビデオの違いを示しています。これらのビデオは、同じビデオコンテキストから将来のビデオ展開を実行するようにモデルにプロンプトを出すことで生成されました。
(i) コンディショニングフレームで信号機が見えるようになったこと、(ii) 車両や樹木などの予測されたシーン要素の詳細がはるかに鮮明になったこと、(iii) 時間的な一貫性が向上したことが確認できます。
創発的行動
多様な未来の予測
複数の自車行動
世界モデルは、過去のコンテキストビデオフレームから異なる妥当な未来を予測できます。このシーンでは、ラウンドアバウトに近づいています。世界モデルによって予測された最初の未来は、直進することです。
サンプリングによって得られたこの2番目の代替の未来では、モデルは右折を予測しています。
多様な交通
世界モデルは、歩行者、自転車、オートバイ、対向車など、異なる交通レベルを予測することもできます。
他の動的エージェントとの相互作用
次の例は、世界モデルが他の道路利用者との相互作用について推論できることを示しています。最初の未来(左のビデオ)では、白い車両が後退してこちらに道を譲ります。2番目の未来(右のビデオ)では、こちらがその車両に道を譲り、右折を実行させます。
アクションによる世界モデルの条件付け
世界モデルは、実行されるアクションに応じて環境と相互作用できます。次のビデオは、異なる自車軌道で条件付けられた異なる可能性のある未来を示しています。
左側には、軽度から強度の左ステアリングとそれに続く復帰が含まれています。右側には、軽度から強度の右ステアリングとそれに続く復帰が含まれています。これらの軌道はトレーニングデータには含まれておらず、世界モデルの一般化能力を際立たせています。
反応的行動
この例では、右ステアリングとその後の復帰を行うことで、自車を車線から逸脱させます。興味深いことに、対向車が反応し、衝突を避けるための操作を行う様子が観察されます。
テキストによる生成の制御
テキストで世界モデルにプロンプトを出すことで、環境の側面を制御できます。
天候
次の例では、「It is」に続いて「sunny(晴れ)」、「rainy(雨)」、「foggy(霧)」、または「snowy(雪)」というテキストプロンプトを使用して、運転シーンを生成するように世界モデルに指示しています。
時刻/照明
次のビデオでは、異なる照明のシーンを生成するようにモデルに指示しています。プロンプトは「昼間、直射日光の下にいる」、「空が灰色である」、「薄明かりである」、「夜である」です。これらの例は、GAIA-1が生成できるシーンの多様性を示しています。
テキストとアクションで条件付けられた生成
テキストでシーンを指定し、その特定のシーンをナビゲートするためのアクションを入力することも可能です。次の例では、赤いバスの後ろを走行し、それを追い越すアクションを実行することを想定しています。
長尺で多様な運転シーンの生成
以下のビデオに示すように、GAIA-1は想像力だけで長尺かつ多様な運転シーンを生成できます。
結論
GAIA-1は、自動運転の文脈における生成世界モデルへの斬新なアプローチを導入します。当社の研究は、ビデオ、テキスト、アクションの入力を統合して多様な運転シナリオを作成するマルチモーダル学習の可能性を示しています。GAIA-1は、自車行動やシーン要素をきめ細かく制御できる能力で際立っており、自律走行システム開発における汎用性を高めています。GAIA-1はベクトル量子化表現を使用して、将来予測タスクを言語モデル(LLM)で一般的に採用されている手法である次トークン予測問題に再構成します。GAIA-1は、乗用車、トラック、バス、歩行者、自転車、道路レイアウト、建物、信号機などのオブジェクトを区別するなど、世界のさまざまな側面を理解する能力において有望な結果を示しています。さらに、GAIA-1はビデオ拡散モデルを利用して、より視覚的に現実的な運転シーンを生成します。
GAIA-1の自動運転への適用は、自律走行システムの構築方法を改善する可能性を秘めていますが、現在の限界を認識しておくことも重要です。まず、当社の自己回帰生成プロセスは非常に効果的である一方、かなりの処理時間を必要とするため、長尺ビデオの生成には計算負荷がかかります。この手法は並列化に適しており、複数のサンプルを生成することで全体のパフォーマンス効率を同時に高めることができる点は注目に値します。さらに、現在のモデルは主に単一カメラの出力予測を中心としていますが、当然ながら、自動運転には周囲のあらゆる角度からの包括的な視界が不可欠です。今後の取り組みでは、このより広い視点を網羅するようにモデルの能力を拡張し、推論効率を最適化する予定です。この進化により、当社のテクノロジーはさらに適用可能で効果的なものになることが期待されます。
世界モデルを運転モデルに組み込むことで、モデルが自身の意思決定をより良く理解し、最終的にはより多くの現実世界の状況に一般化できるようになります。さらに、GAIA-1は貴重なニューラルシミュレーターとしても機能し、自動運転システムのトレーニングや検証のための無制限のデータを生成することを可能にします。
先行研究との定性的比較
以下に、GAIA-1と、GAN、拡散モデル、またはトランスフォーマーアーキテクチャに基づいた他の一連の手法との定性的比較を示します。
参考文献
DriveGAN
S. W. Kim, J. Philion, A. Torralba, and S. Fidler. “DriveGAN: Towards a Controllable High-Quality Neural Simulation”, CVPR 2021.
Video Diffusion Models
J. Ho, T. Salimans, A. Gritsenko, W. Chan, M. Norouzi, and D. J. Fleet. “Video Diffusion Models”, arXiv preprint 2022.
Flexible Diffusion Models
W. Harvey, S. Naderiparizi, V. Masrani, C. Weilbach, and F. Wood. “Flexible Diffusion Modeling of Long Videos”, NeurIPS 2022.
Imagen Video
J. Ho, W. Chan, C. Saharia, J. Whang, R. Gao, A. Gritsenko, D. P. Kingma, B. Poole, M. Norouzi, D. J. Fleet, and T. Salimans. “Imagen Video: High Definition Video Generation with Diffusion Models”, arXiv preprint 2022.
MAGVIT
L. Yu, Y. Cheng, K. Sohn, J. Lezama, H. Zhang, H. Chang, A. G. Hauptmann, M.-H. Yang, Y. Hao, I. Essa, and L. Jiang. “MAGVIT: Masked Generative Video Transformer”, CVPR 2023.
Phenaki
R. Villegas, M. Babaeizadeh, P.-J. Kindermans, H. Moraldo, H. Zhang, M. T. Saffar, S. Castro, J. Kunze, and D. Erhan. “Phenaki: Variable Length Video Generation From Open Domain Textual Description”, ICLR 2023.
Align your latents
A. Blattmann, R. Rombach, H. Ling, T. Dockhorn, S. W. Kim, S. Fidler, and K. Kreis. “Align your Latents: High-Resolution Video Synthesis with Latent Diffusion Models”, CVPR 2023.
DriveDreamer
X. Wang, Z. Zhu, G. Huang, X. Chen, and J. Lu. “DriveDreamer: Towards Real-world-driven World Models for Autonomous Driving”, arXiv preprint 2023.
Gen2
Runway. “Gen-2: The Next Step Forward for Generative AI”, 2023. https://research.runwayml.com/gen2.
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む