








20 4月 2021 | リサーチ
単眼カメラによる俯瞰映像からの未来予測
運転中、世界の単一のスナップショットを見るだけでは、即座の判断が容易ではない状況に直面することがよくあります。例えば、以下のような状況でドライバーはどうすべきでしょうか?
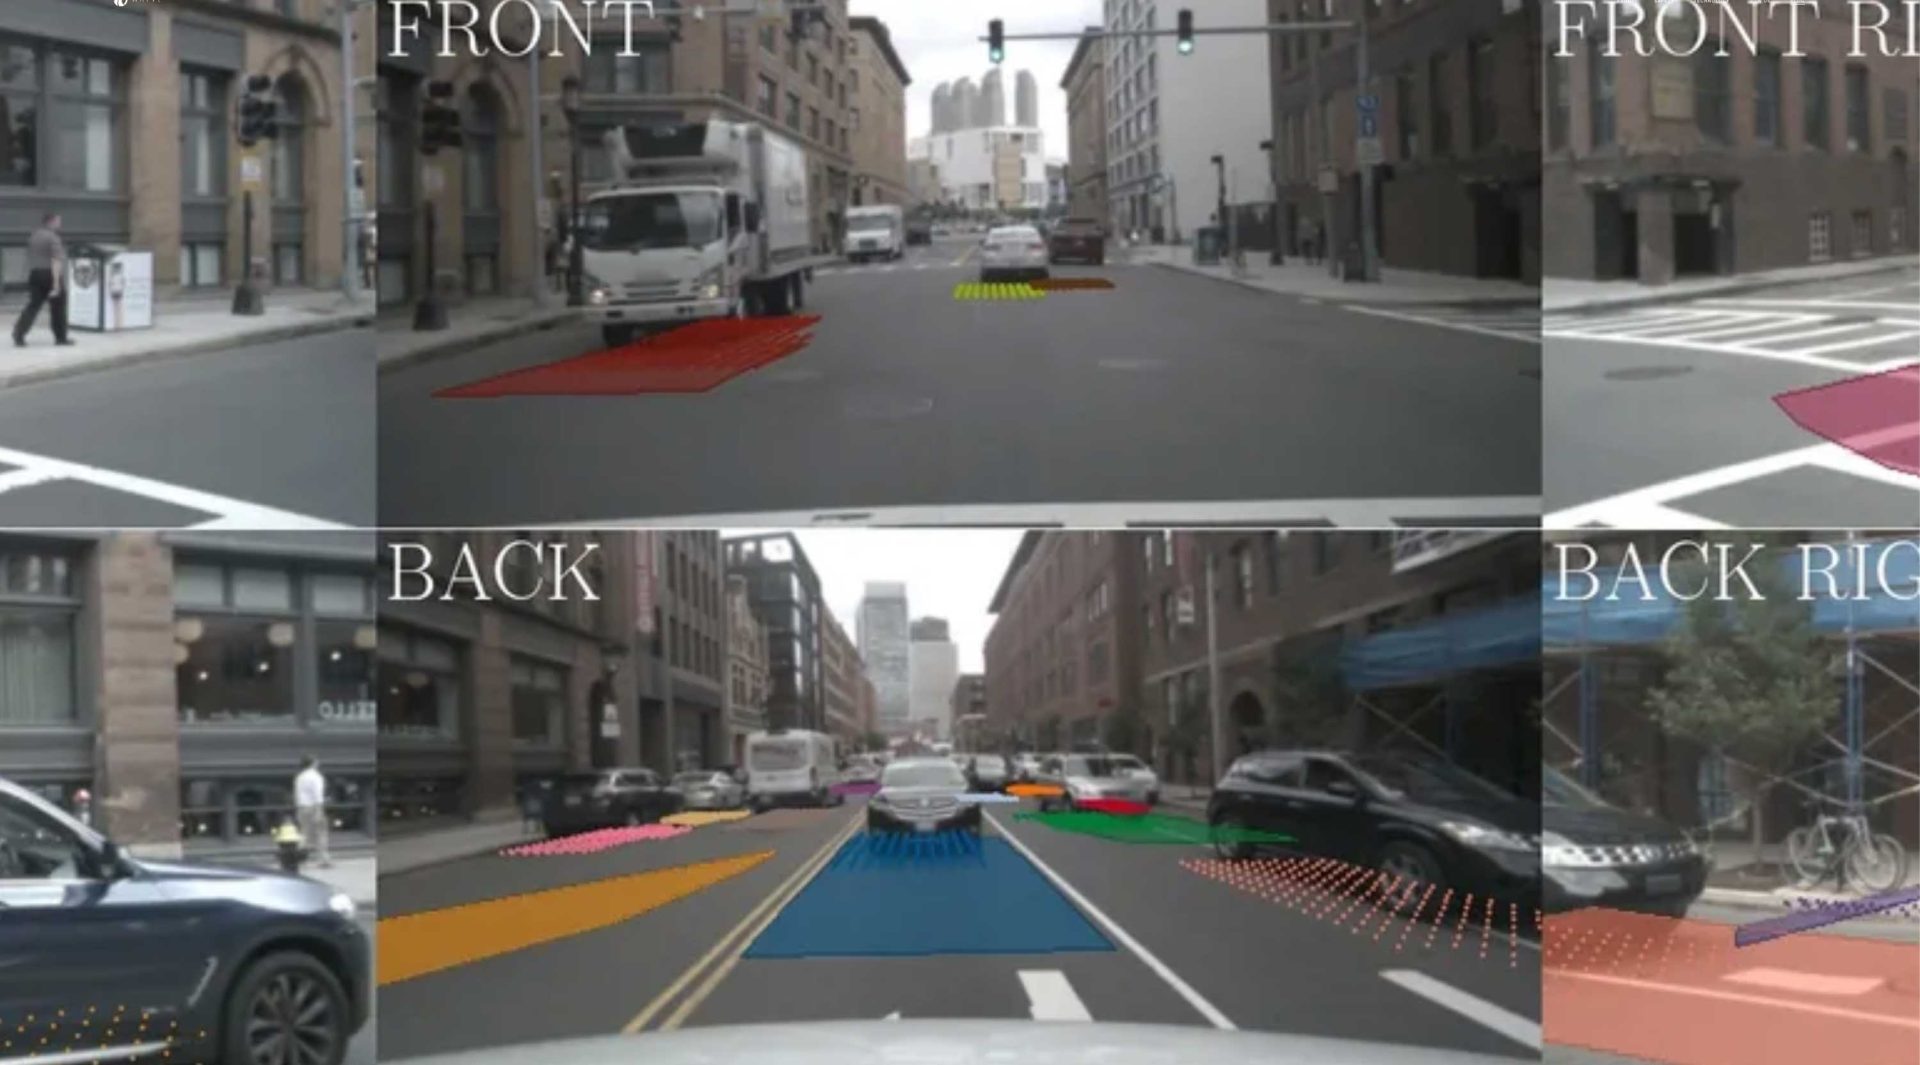
左側の車両は譲っていますか?
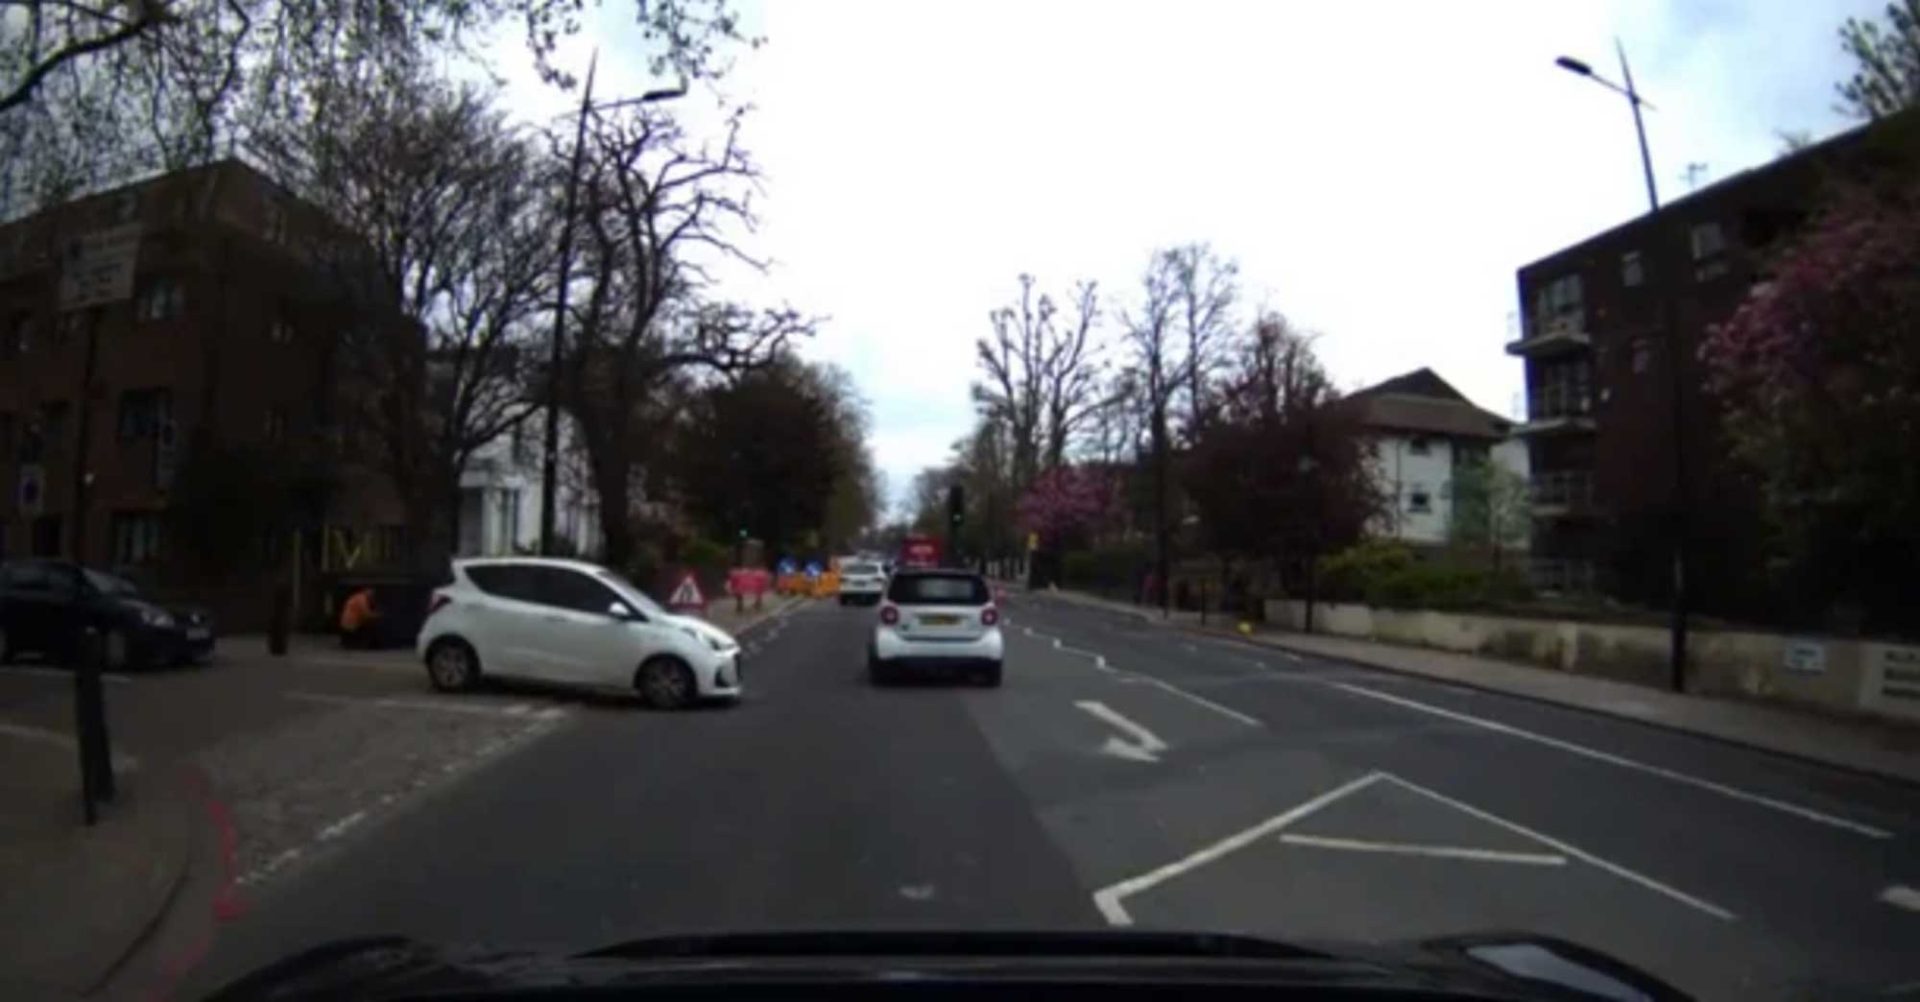 こちらに優先権がある場合でも、道を譲らずに交差点に進入してくる人が定期的にいるため、この状況は曖昧です。
交差点を直進できますか?

この2番目のシナリオでは、本来そうすべきであるように、バンとサイクリストに道を譲るべきでしょうか?
彼らの動きから、道路を曲がろうとしていることが自信を持って予測できるため、私たちは右左折が可能です。
道路上の他の車両と安全に走行するためには、現在の位置を特定するだけでなく、これまでの動きに基づいて将来どこにいるかを予測することも必要です。このような予測を行うことは人間にとっては直感的ですが、自律走行システムにとっては依然として非常に困難な課題です。予測は、他の道路利用者とともに安全かつ効果的に走行するための重要な要素です。
このブログ記事では、予測に関する当社の最近の開発成果を紹介し、単眼ビデオカメラからの俯瞰映像(BEV)で未来を予測できるアルゴリズムを初めて実証します。予測というタスク自体は新しいものではなく、自動運転の追求において10年以上にわたって取り組まれてきました。しかし、行動計画に大きな影響を与えるため、依然として自律走行システムにおける最も困難な側面の一つと見なされています。私たちは、完全に学習されたドライバーこそが最終的に自動運転の現実をもたらすと信じており、エンドツーエンドの学習による予測はその一部です。Wayveでは、入力されたセンサーデータに基づいてどこを走行すべきかを推定する学習済みアルゴリズムを中心に走行システムを構築しており、予測は走行を効果的かつ効率的に学習するために使用する誘導バイアスの一つです。
論文を公開し、ソースコードをリリースしました。このブログ記事は、当社の以前の研究に続くものです。
私たちのアプローチ
自動運転における目標は、3D空間を通じて車両を安全かつ正確にナビゲートすることです。そのため、LiDARセンサーに基づく動作計画や予測には、正投影の俯瞰(BEV)パースペクティブが一般的に使用されます。
近年、カメラベースの認識技術の進歩がLiDARベースの認識に匹敵するようになり、予測を含むより広範な単眼視覚タスクでもこれが可能になると期待しています。カメラに基づく認識・予測システムを構築することで、LiDARセンサーよりもスリムで安価、かつ高解像度な視覚認識システムが実現可能になります。
私たちはFIERYを提案します。これは、単眼カメラのみからの俯瞰映像による未来のインスタンス予測モデルです。当社のモデルは、動的エージェントの将来のインスタンスセグメンテーションと動きを予測し、それを非パラメトリックな将来の軌道に変換することができます。
当社の手法は、周囲のRGB単眼カメラ入力から俯瞰予測を直接推定することで、従来の自律走行スタックの認識、センサーフュージョン、予測コンポーネントをエンドツーエンドで統合します。私たちはエンドツーエンドのアプローチを支持しています。なぜなら、エラーの連鎖や高レイテンシが発生しやすい多段階の離散的なタスクパイプラインでモジュールを分離するのではなく、表現を直接最適化できるからです。
さらに、従来の自律走行スタックは、起こりうる相互作用を考慮せずに動的エージェントの現在の行動を外挿することで未来予測に対処しています。これらは高精度(HD)マップに依存し、道路の接続性を使用して将来の軌道セットを生成します。対照的に、FIERYはHDマップやLiDARセンサーに頼ることなく、カメラの走行データから直接エンドツーエンドで動的エージェントの将来の動きを学習します。未来に内在する確率的な性質を推論することができ、以下のビデオに示すようにマルチモーダルな将来の軌道を予測します。
未来予測
交差点
当社のモデルは、さまざまな妥当な未来(直進、左折、右折、車線変更)に対応する道路エージェントのマルチモーダルな将来軌道を予測します。自車とマルチエージェントの将来軌道が、可能性のある未来の分布を表す複数の経路とともに、包括的に予測される様子をご覧ください。
停車車両の追い越し
シーケンスの開始時、当社のモデルは前方の車両が左車線に戻る(左側通行の場合)か、右側に回避するかのいずれかを予測します。その後の瞬間、この車両が実際には左車線に停車している車両を追い越さなければならないことを理解します。
Uターン
当社のモデルは、前方の車両のUターンなど、都市環境における複雑な行動を予測できます。
モデルアーキテクチャ
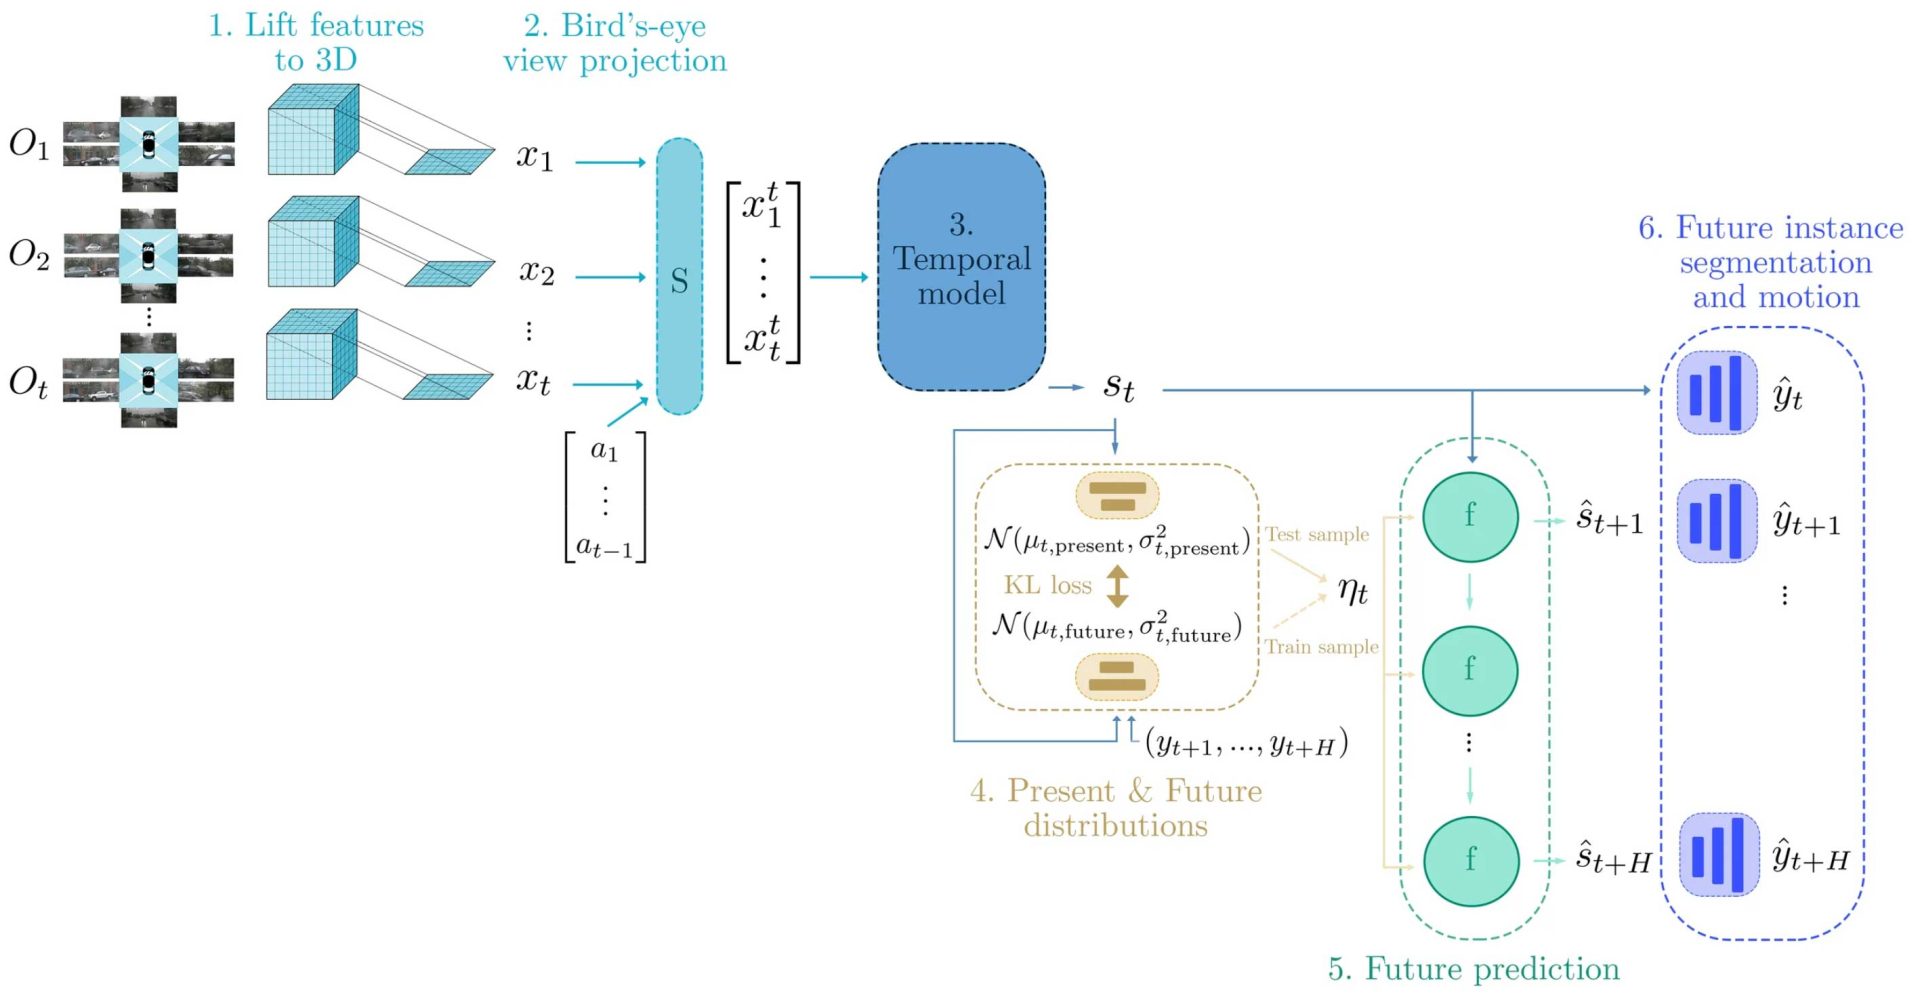 FIERYの6つの構成要素。
- 過去の各タイムステップ {1,…,t} において、ピクセルごとの深度確率分布を予測し、既知のカメラの内部パラメータおよび外部パラメータを使用することで、カメラ入力を3Dにリフトアップします。
- これらの特徴は俯瞰(BEV)に投影されます。過去の自己運動を用いて、空間トランスフォーマーモジュールSにより、俯瞰特徴を現在の参照フレーム(時刻t)に変換します。
- 3D畳み込み時間モデルが時空間状態 s_t を学習します。
- 現在分布と未来分布という2つの確率分布をパラメータ化します。現在分布は現在の状態 s_t に条件付けられ、未来分布は現在の状態 s_t と未来のラベルの両方に条件付けられます。
- 学習時には未来分布から、推論時には現在分布から潜在コードをサンプリングします。現在の状態 s_t と潜在コードは、未来の状態を再帰的に予測する未来予測モデルへの入力となります。
- 状態は、俯瞰映像における将来のインスタンスセグメンテーションと将来の動きへとデコードされます。
秘伝のレシピ
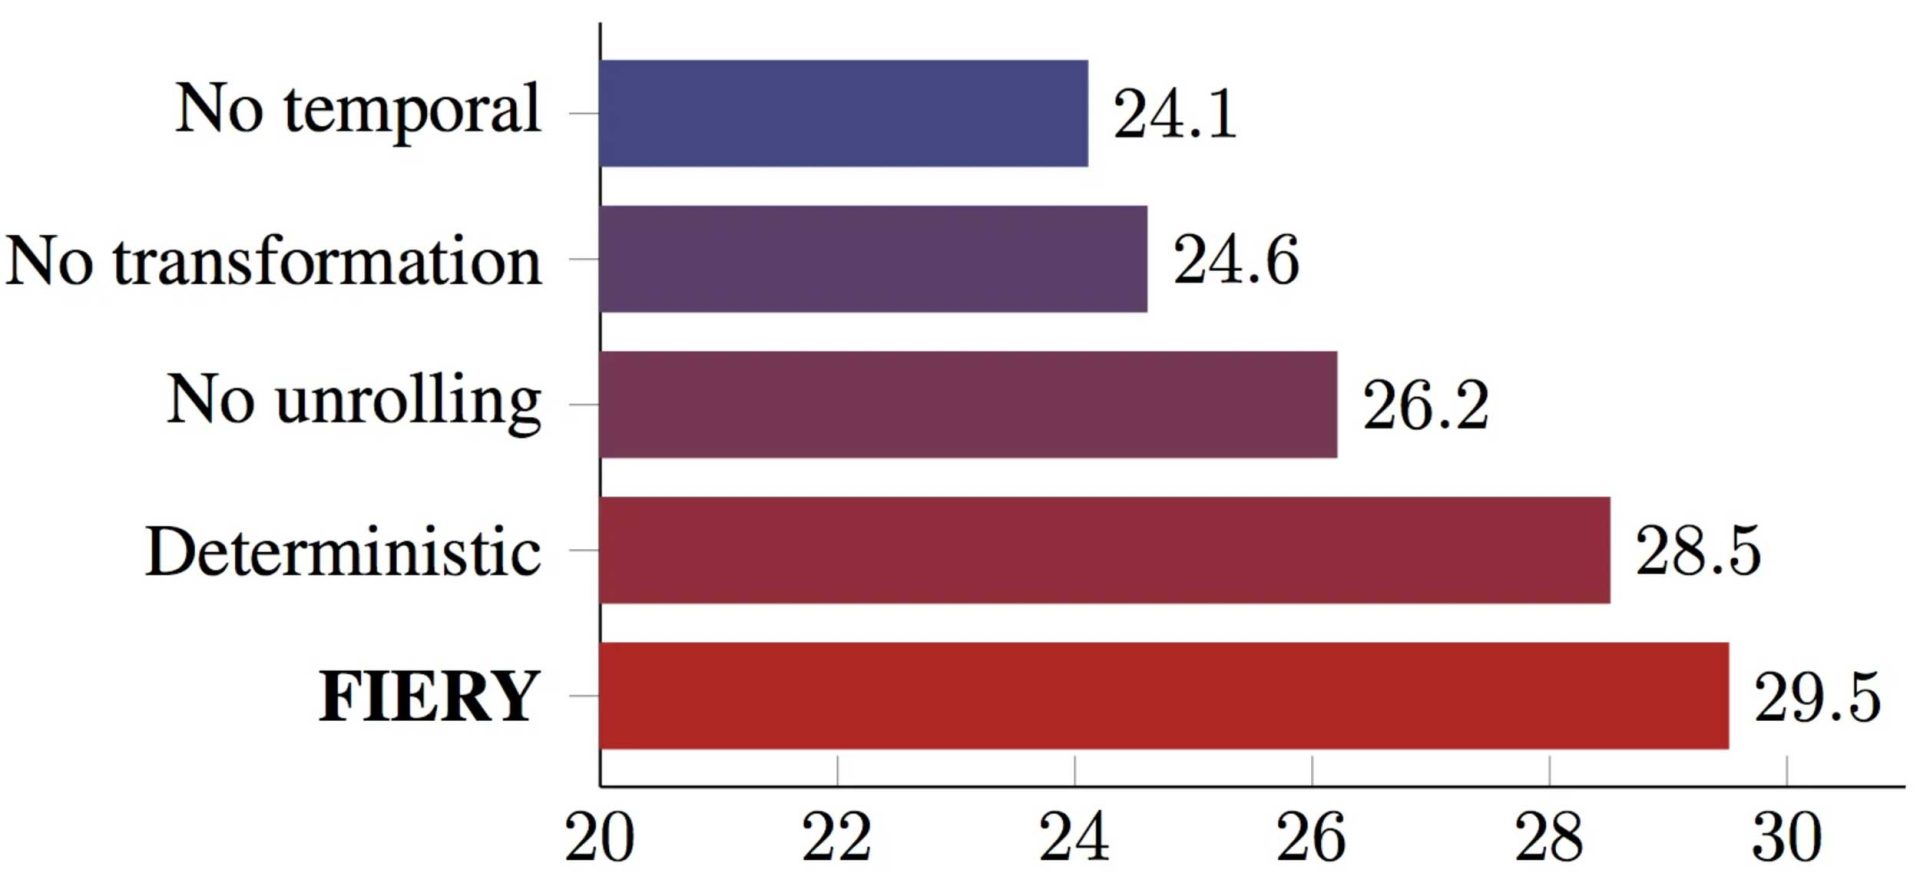 当社のモデルの異なるアブレーションにおける未来予測パフォーマンス(Future Video Panoptic Quality指標を報告)。
時空間状態の学習
未来を予測するには過去を理解する必要があります。しかし、自車も動いているため、過去のカメラ入力から対応関係や動きを学習するのは困難な場合があります。上の図に示すように、パフォーマンスの向上に最も寄与しているのは、(i) 過去のコンテキストを組み込むための時間モデルを持つこと、および (ii) 過去の特徴を現在の共通参照フレームにリフトアップすることの2点です。過去の特徴が共通の参照フレームにある(したがって自己運動が除外されている)場合、動的エージェントの対応関係や動きを学習するタスクははるかに単純になります。
未来状態の予測
未来を予測する際、その連続的な性質をモデル化することが重要です。つまり、時刻 t+1 での予測は時刻 t での予測に条件付けられるべきです。
現在の状態 s_t から将来のすべてのインスタンスセグメンテーションと動きを直接予測する「アンローリングなし」のバリアントでは、パフォーマンスが大幅に低下します。これは、未来の状態を再帰的に予測する当社の手法とは対照的に、逐次的な制約が強制されなくなるためです。
確率的モデリング
未来は本質的に不確実であり、一意的で決定論的な過去が与えられても、異なる結果が起こり得ます。可能性のある未来の一つに過ぎない正解(グラウンドトゥルース)の未来ラベルで盲目的にモデルを罰するだけでは、モデルが未来の異なるモードを学習することは促進されません。
私たちは2つの確率分布を導入します:
- 未来分布は学習中に使用され、現在の状態 s_t と未来のラベルに条件付けられます。未来分布から潜在コードをサンプリングして、未来予測モジュールを学習シーケンスの観測された未来へと導きます。未来分布は情報を低次元ベクトルに大幅に絞り込むため、未来予測モジュールが未来のラベルを単にコピーして不正をすることはできません。
- 現在分布は現在の状態 s_t のみに条件付けられます。現在分布に対する未来分布のモードカバーKullback-Leiblerダイバージェンス損失により、未来の異なるモードを捉えることが促進されます。推論中、現在分布からの異なる潜在コードのサンプルは、それぞれ異なる妥当な未来に対応します。
今後の展望
自律走行には、世界の現状だけでは正しく推論するのに不十分なマルチモーダルなシナリオでの意思決定が必要です。したがって、世界の将来の状態、特に他の動的エージェントを推定する予測モデルは、堅牢な走行のための主要なコンポーネントです。FIERYは、単眼カメラからの俯瞰映像による確率的未来予測モデルであり、道路エージェントのマルチモーダルな将来軌道をエンドツーエンドで予測します。
今後の研究では、未来のアクションに未来予測モデルを条件付けるために、走行ポリシーを共同で学習させる予定です。このようなフレームワークは、モデルベースの強化学習設定において効果的な動作計画を可能にします。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む