








14 9月 2023 | リサーチ
LINGO-1:自動運転のための自然言語の探求
Wayveでは、自然言語を使用して、基盤運転モデルの学習と説明可能性を強化しています。本ブログでは、ビジョン、言語、アクションを組み合わせて、基盤運転モデルの解釈、説明、トレーニング方法を強化するオープンループ・ドライビング・コメンテーター「LINGO-1」を紹介します。
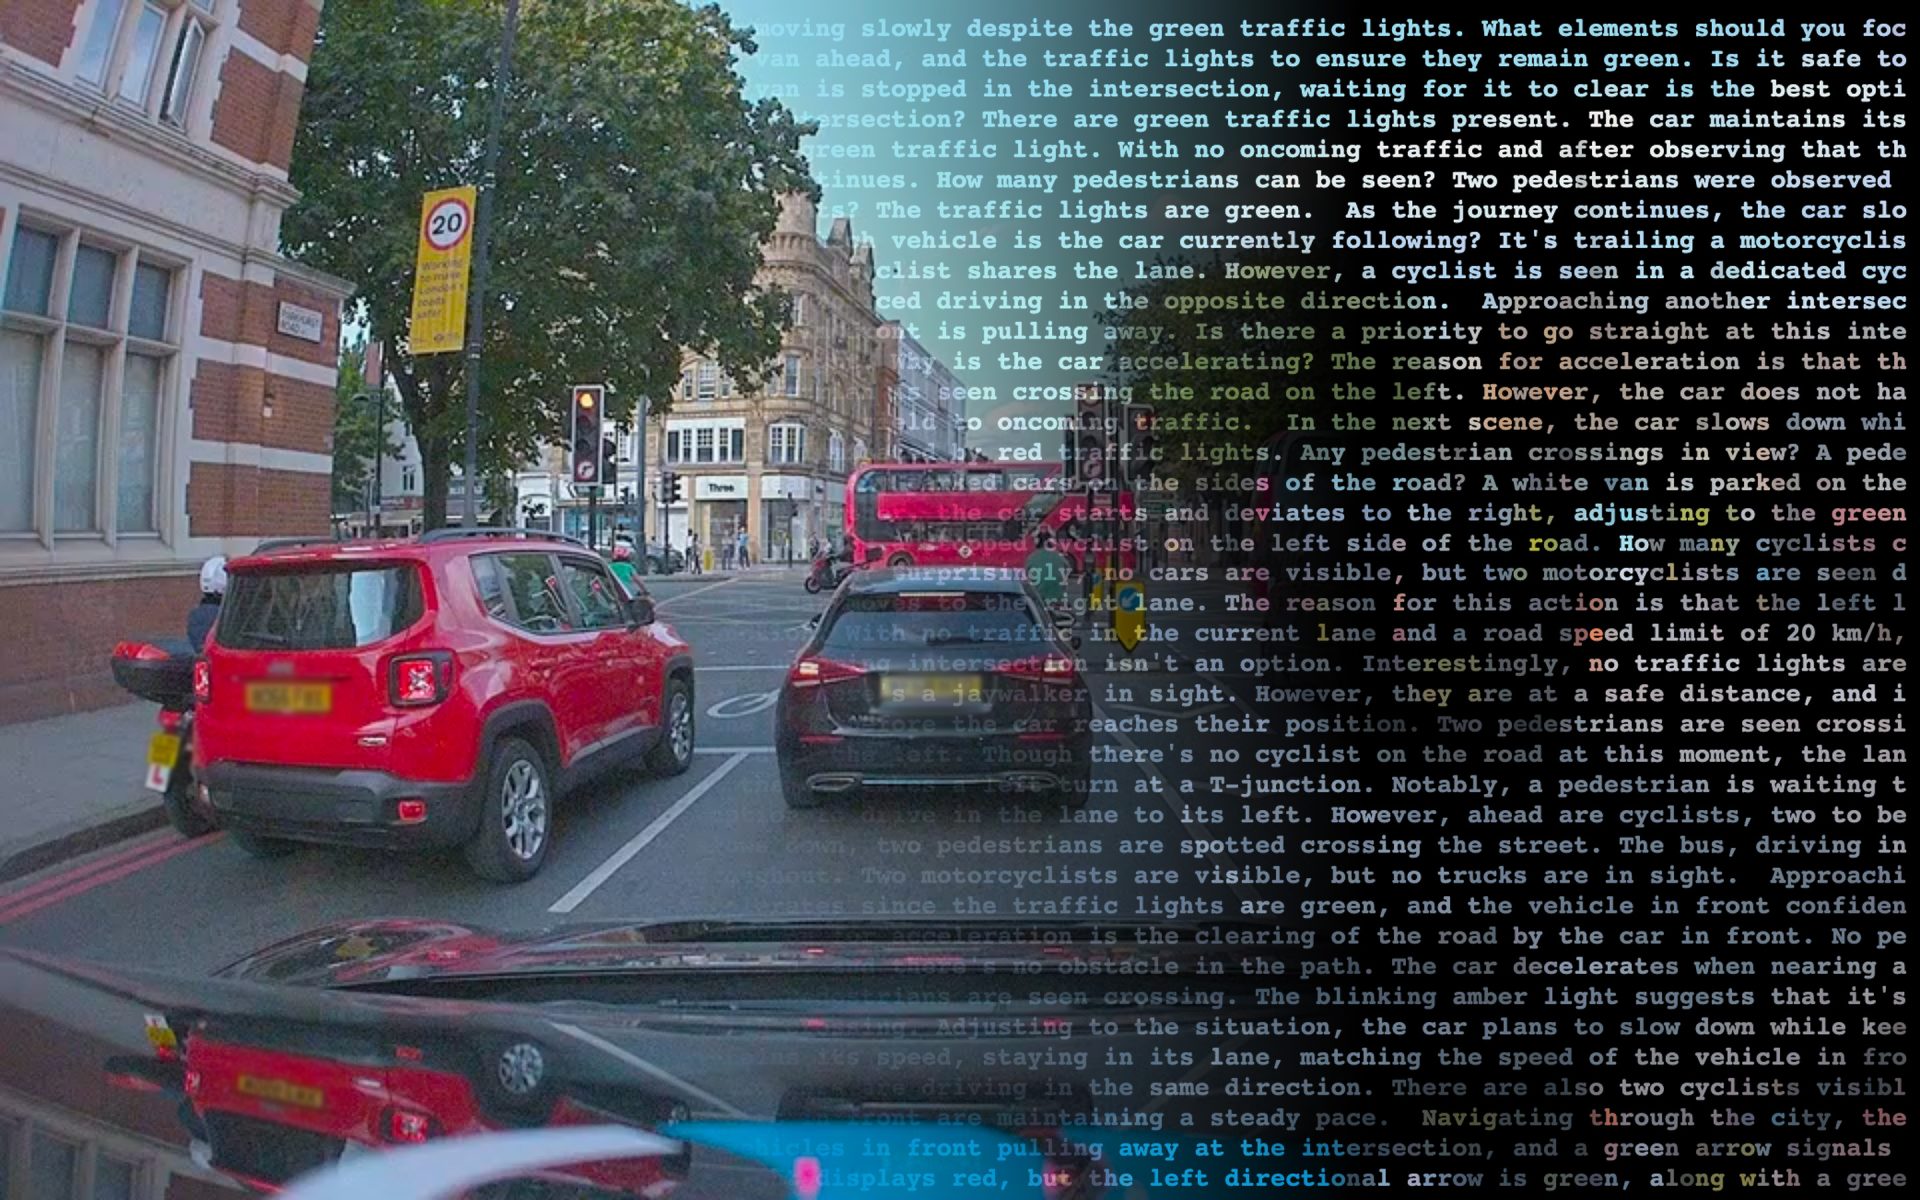
ビジョン・ランゲージ・アクション・モデル(VLAM)の紹介
人工知能の時代において、大規模言語モデル(LLM)の影響は私たちの身の回りに溢れています。近年、インターネット規模の膨大なデータセットを用いた自己教師あり学習により、自然言語のクエリに対して人間のような回答を生成するLLMが台頭してきました。これらのモデルはディープラーニングと生成AIに変革をもたらし、現在では数多くのタスクの自動化に使用されています。また、LLMの推論能力と画像や動画を融合させ、画像分類、テキストからの画像検索、視覚的質疑応答(すなわち、自然言語を使用して画像に関する質問に答えること)などの様々なタスクを驚異的な精度で実行するビジョン・ランゲージ・モデル(VLM)への関心も高まっています。Wayveでは、画像、運転データ、そして新たに言語という3種類の情報を組み込んだビジョン・ランゲージ・アクション・モデル(VLAM)を探索することで、これをさらに一歩進めています。
ロボットのトレーニングにおける自然言語の使用は、特に自動運転の分野ではまだ初期段階にあります。ビジョンやアクションとともに言語を取り入れることは、基盤運転モデルの解釈、説明、トレーニング方法を強化する新しいモダリティとして、多大な影響を与える可能性があります。基盤運転モデルとは、知覚(周囲の世界の認識)、因果関係および反事実的推論(見ているものの意味理解)、プランニング(適切な行動シーケンスの決定)を含む、複数の運転タスクを実行できるモデルを指します。言語を使用して運転シーンにおける因果要因を説明することで、トレーニングの高速化や新しい環境への汎化が可能になるかもしれません。
また、言語を使用して運転シーンに関する質問をモデルに投げかけ、モデルが何を理解しているかをより直感的に把握することもできます。この機能は、運転モデルの推論能力や意思決定能力の向上に役立つ洞察を提供します。同様に刺激的なのは、VLAMによって対話を通じた運転モデルとのインタラクションが可能になることです。ユーザーは自動運転車両に対し、何をしているのか、なぜそうしているのかを尋ねることができます。これは、この技術に対する一般の認識に大きな影響を与え、その能力に対する自信と信頼を築くことにつながるでしょう。
幅広い能力を持つ基盤運転モデルを持つことに加え、新しいタスクを効率的に学習し、トレーニングサンプルが少ない新しいドメインやシナリオに迅速に適応できることも非常に望ましいことです。ここで、自然言語は学習の高速化をサポートするという価値を付加できます。例えば、修正のための運転操作に、その状況における不適切な行動と適切な行動の自然言語による説明が添えられるシナリオが考えられます。この追加の教師信号により、基盤モデルの少数のデータによる適応(フューショット・アダプテーション)を強化できます。これらのアイデアを念頭に置き、当社のサイエンスチームは自然言語を使用して、エンドツーエンドの自動運転のための基盤モデルの構築を模索しています。
エンボディドAI(身体性AI)で可能なことの限界に挑む中で、言語は基盤運転モデルの解釈、説明、トレーニング方法を強化する新しいモダリティを提供するため、ビジョン・ランゲージ・アクション・モデルは多大な影響を与える可能性があります。
オープンループ・ドライビング・コメンテーター「LINGO-1」の紹介
VLAMに関するこの最初のブログでは、当社の車両フリートを使用して自然言語の運転データセットをどのように構築しているか、そしてこのデータセットを使用してトレーニングした結果である オープンループ・ドライビング・コメンテーター「LINGO-1」を紹介します。
LINGO-1の開発における主要な特徴は、英国中を走行しながら実況解説を行う熟練ドライバーから収集した画像、言語、アクションのデータを組み込んだ、スケーラブルで多様なデータセットの作成です。この解説手法は、プロのドライビングインストラクターがレッスンで使用するロードクラフト(高度な運転技術)を彷彿とさせます。インストラクターはシーンの興味深い側面を声に出し、短いフレーズを使って自分の運転操作を正当化することで、生徒が手本から学べるように支援します。以下は、熟練ドライバーが説明する可能性のある、操作に影響を与えたり安全運転への注意を促したりする例です。
- 先行車や信号の変化に合わせた減速
- ルートに従うための車線変更
- 制限速度までの加速
- 道路に進入してくる車や交差点で停止している車への注意
- ラウンドアバウトや一時停止(Give Way)の標識などの危険箇所への接近
- 路上駐車、信号機、学校などの存在
- 車線変更や駐車車両の追い越しなど、他の道路利用者が行っている行動
- 横断歩道で待機している、あるいは自転車レーンで車の後ろから近づいてくる自転車や歩行者
これらのフレーズがセンサー画像や低レベルの運転操作と時間的に同期されることで、多様なタスクに向けてモデルをトレーニングするための豊かなビジョン・ランゲージ・アクション・データセットが得られます。
当社の運転解説データは、熟練ドライバーの運転データ収集のペースを落とすことなく、標準的なデータ収集を強化します。これにより、自然言語を通じたもう一つの教師レイヤーを収集するための費用対効果の高いアプローチが可能になります。データセットの品質を維持するため、各熟練ドライバーには解説プロトコルに従うようトレーニングを行っています。このプロトコルには、話される言葉の関連性と密度、解説と運転操作の間の時間的同期、および事象を説明するために使用される用語への注意が含まれます。
LINGO-1のアーキテクチャ
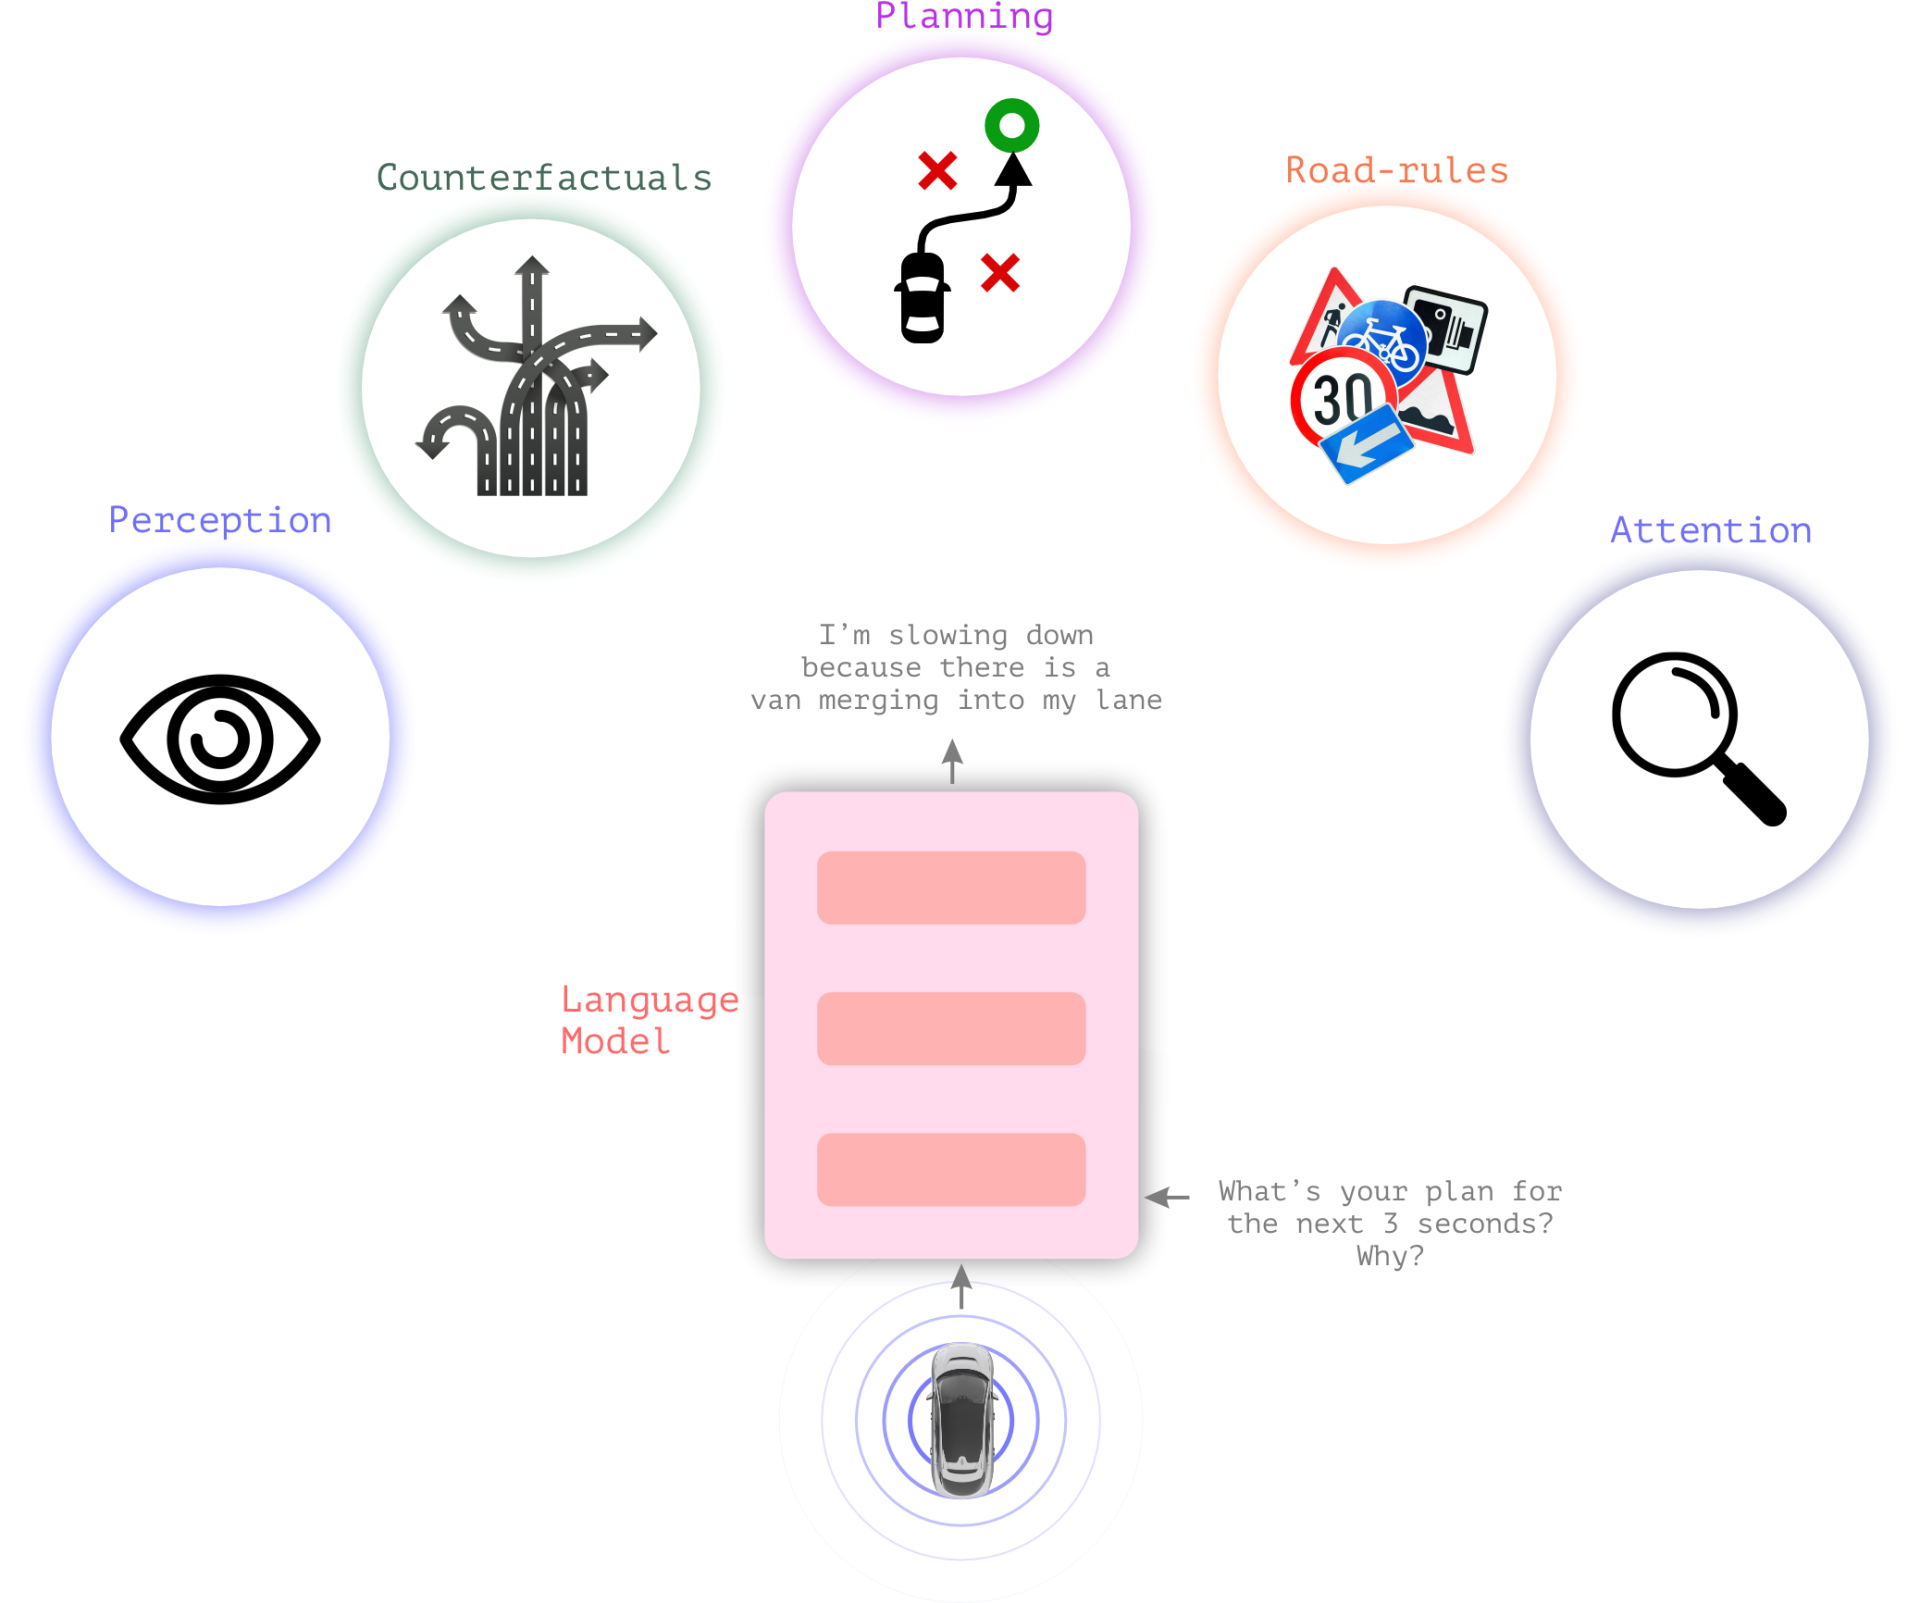
下の図に示すように、当社のオープンループ運転モデルであるLINGO-1を様々なビジョンおよび言語データソースでトレーニングし、知覚、反事実、プランニング、推論、アテンションなどのタスクに関する視覚的質疑応答(VQA)を実行させます。LINGO-1は、単純なプロンプトの変更を通じて多くのタスクを実行できます。これにより、シーンの理解や、運転の意思決定に影響を与えるシーン内の主要な因果要因に関する推論について、LINGO-1に質問を投げかけることができます。言い換えれば、LINGO-1は運転操作とその理由についての説明を提供できるのです。
運転解説
LINGO-1は、運転操作の背後にある理由を説明する継続的な解説を生成できます。これにより、モデルが何に注目し、何をしているのかを自然言語で理解するのに役立ちます。以下にいくつかの例を挙げます。
この最初のビデオでは、LINGO-1が路上駐車している車を追い越す際にとる行動を説明しています。
LINGO-1:渋滞のため、ゆっくりと進んでいます。
LINGO-1:路肩に停車している車両を追い越しています。
LINGO-1:前方の道路が開けたので、加速しています。
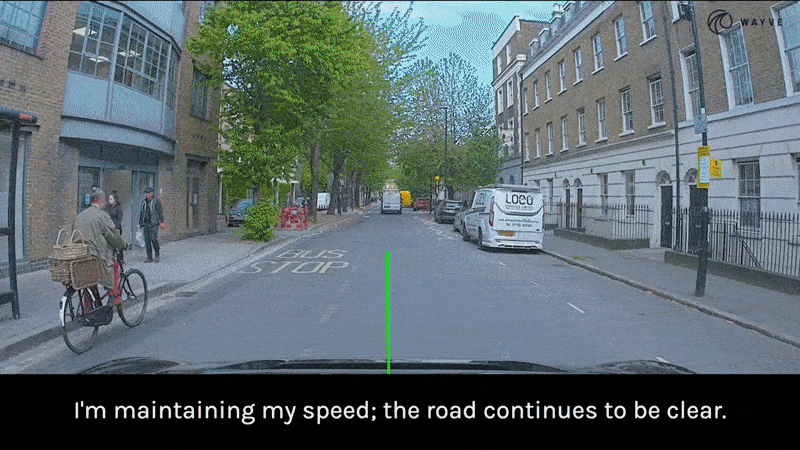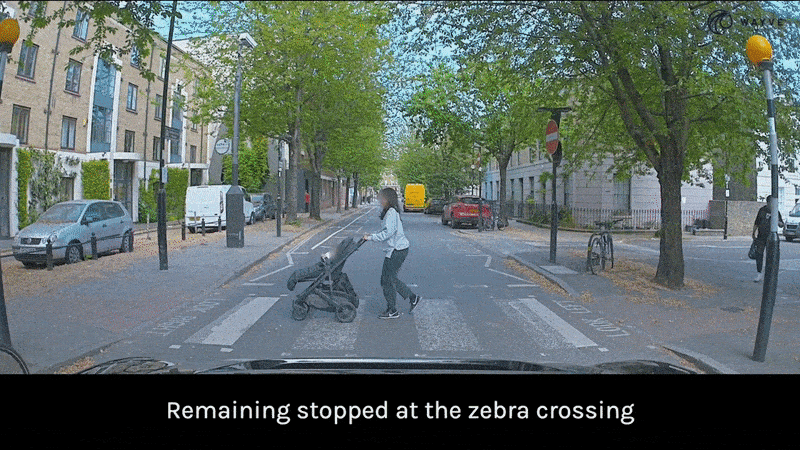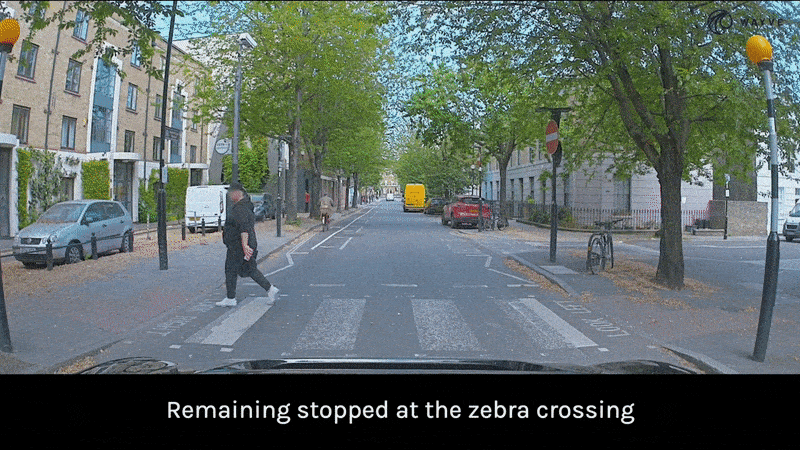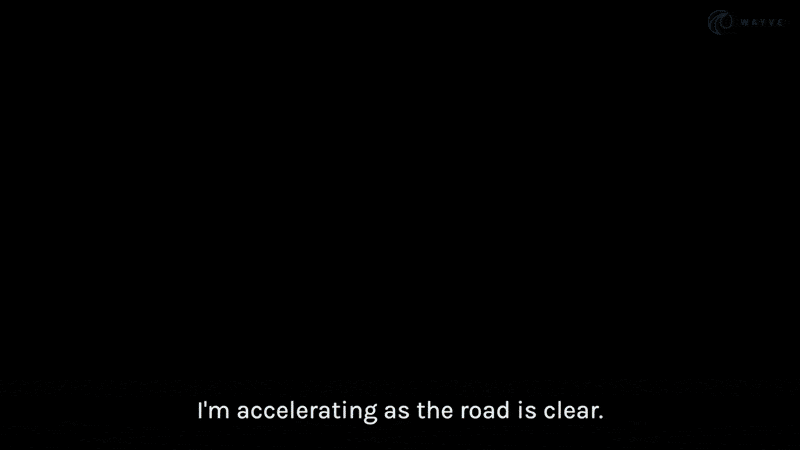
以下は、車が横断歩道に近づく際のLINGO-1の説明です。
LINGO-1:速度を維持しています。前方の道路は引き続きクリアです。
LINGO-1:減速し、ブレーキをかけて停止します。
LINGO-1:横断歩道で停止したまま待機しています。
LINGO-1:停止状態から加速しています。
LINGO-1:道路がクリアなので加速しています。
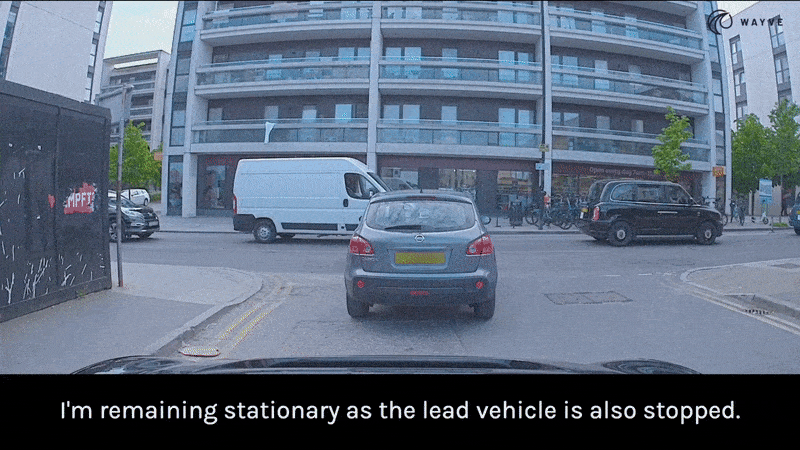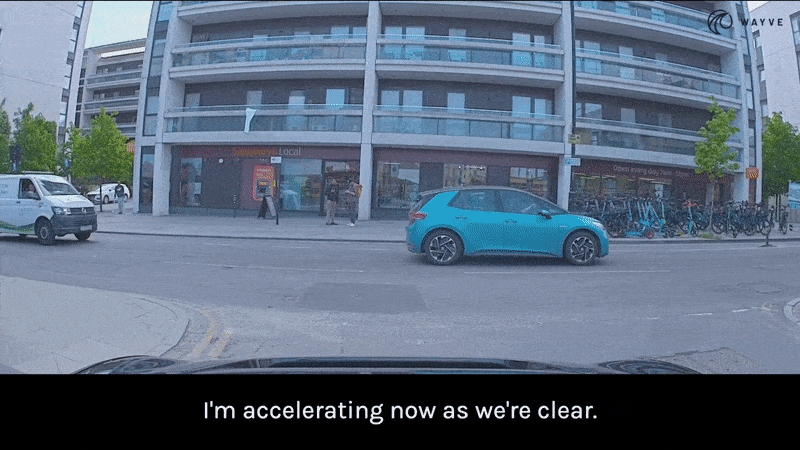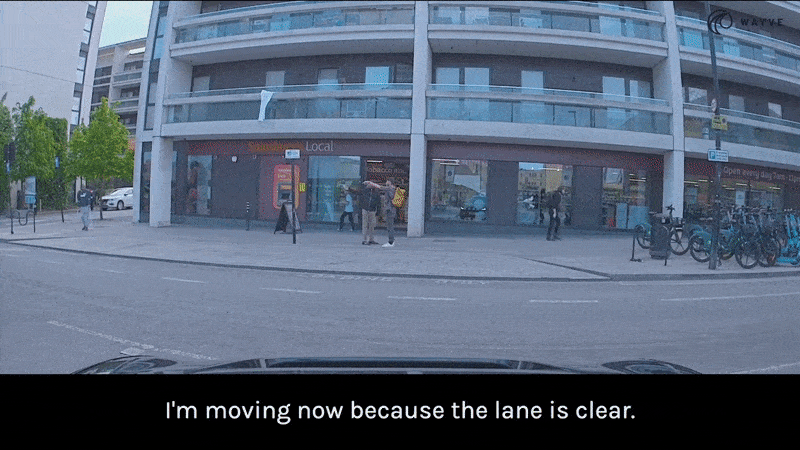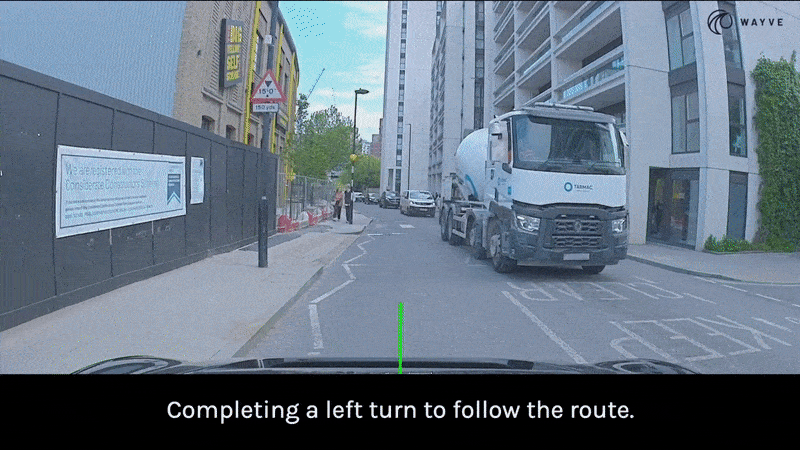
最後に、交差点を左折する際のLINGO-1の説明です。
LINGO-1:先行車も停止しているため、停車したままです。
LINGO-1:クリアになったので、加速しています。
LINGO-1:交差点で止まるためにブレーキをかけています。
LINGO-1:車線がクリアになったので、動き出します。
LINGO-1:ルートに従って左折を完了します。
視覚的質疑応答(VQA)
解説に加えて、様々な運転シーンについてLINGO-1に質問し、モデルのシーン理解を評価し、その推論を理解することもできます。以下のビデオクリップでは、様々な状況で何をすべきかをモデルがどのように説明しているかをご覧いただけます。
この最初の例では、この交差点で何に注目しているかをLINGO-1に尋ねています。
また、天候やそれが運転にどのように影響するかについてLINGO-1に尋ねることもできます。
最後に、自転車の周囲での安全な運転行動をLINGO-1がどのように理解しているかの例です。

パフォーマンス
LINGO-1の精度は、人間レベルのパフォーマンスと比較して約60%です。当社は、様々な知覚、推論、運転知識のタスクに関する質疑応答を測定する包括的なベンチマークセットに照らして、LINGO-1のパフォーマンスを追跡しています。
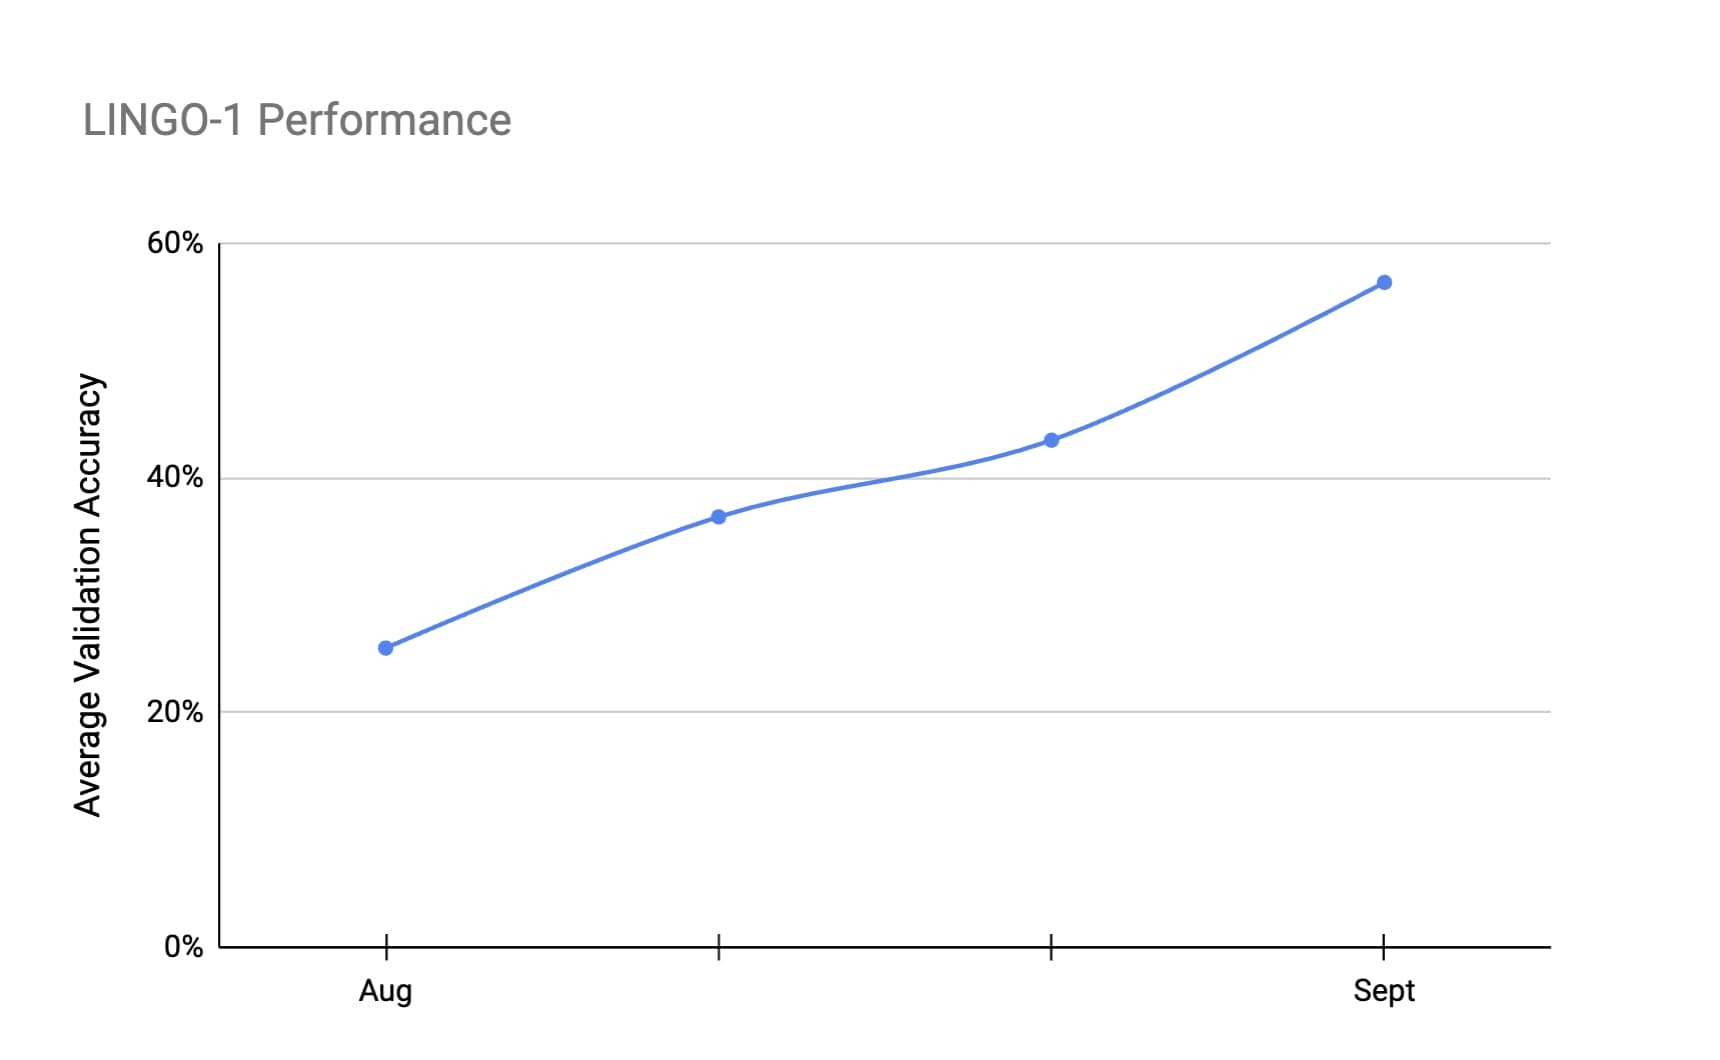
このグラフでは、ここ数週間でLINGO-1のパフォーマンスがどのように向上したかを確認できます。モデルアーキテクチャとトレーニングデータセットの改善により、パフォーマンスは平均検証精度で約60%と倍増しました。当社は引き続きLINGO-1の迅速な反復開発を行っており、今後数週間でさらなる大幅な改善を見込んでいます。
今後の展望
新しいモダリティとして自然言語を含めることは、いくつかの方法で自動運転に革命をもたらす可能性があります。
エンドツーエンドモデルのAI説明可能性の向上
機械学習モデルの説明可能性の欠如は、意思決定プロセスがブラックボックスのように見えることが多いため、共通の懸念事項となっています。しかし、言語を活用することで、AIシステムがどのように意思決定を行うかに光を当てることができます。
自然言語インターフェースを作成することで、ユーザーがAIモデルと有意義な対話を行えるようになり、選択について質問したり、シーンの理解や意思決定に関する洞察を得たりすることが可能になります。乗客と自動運転車両の間のこのユニークな対話は透明性を高め、人々がこれらのシステムを理解し信頼することを容易にします。さらに、言語を統合することで、人間のフィードバックに適応し学習するモデルの能力が向上する可能性があります。教習所の指導員が生徒を指導するように、修正指示やユーザーからのフィードバックによって、モデルの理解と意思決定プロセスを時間の経過とともに洗練させることができます。
より優れたプランニングと推論による運転パフォーマンスの向上
近い将来、LINGOの自然言語、推論、プランニング能力を活用して、当社のクローズドループ運転モデルを強化することを目指しています。現在、多くの異なる統合アーキテクチャを検討していますが、以下にハイレベルなアーキテクチャを示します。
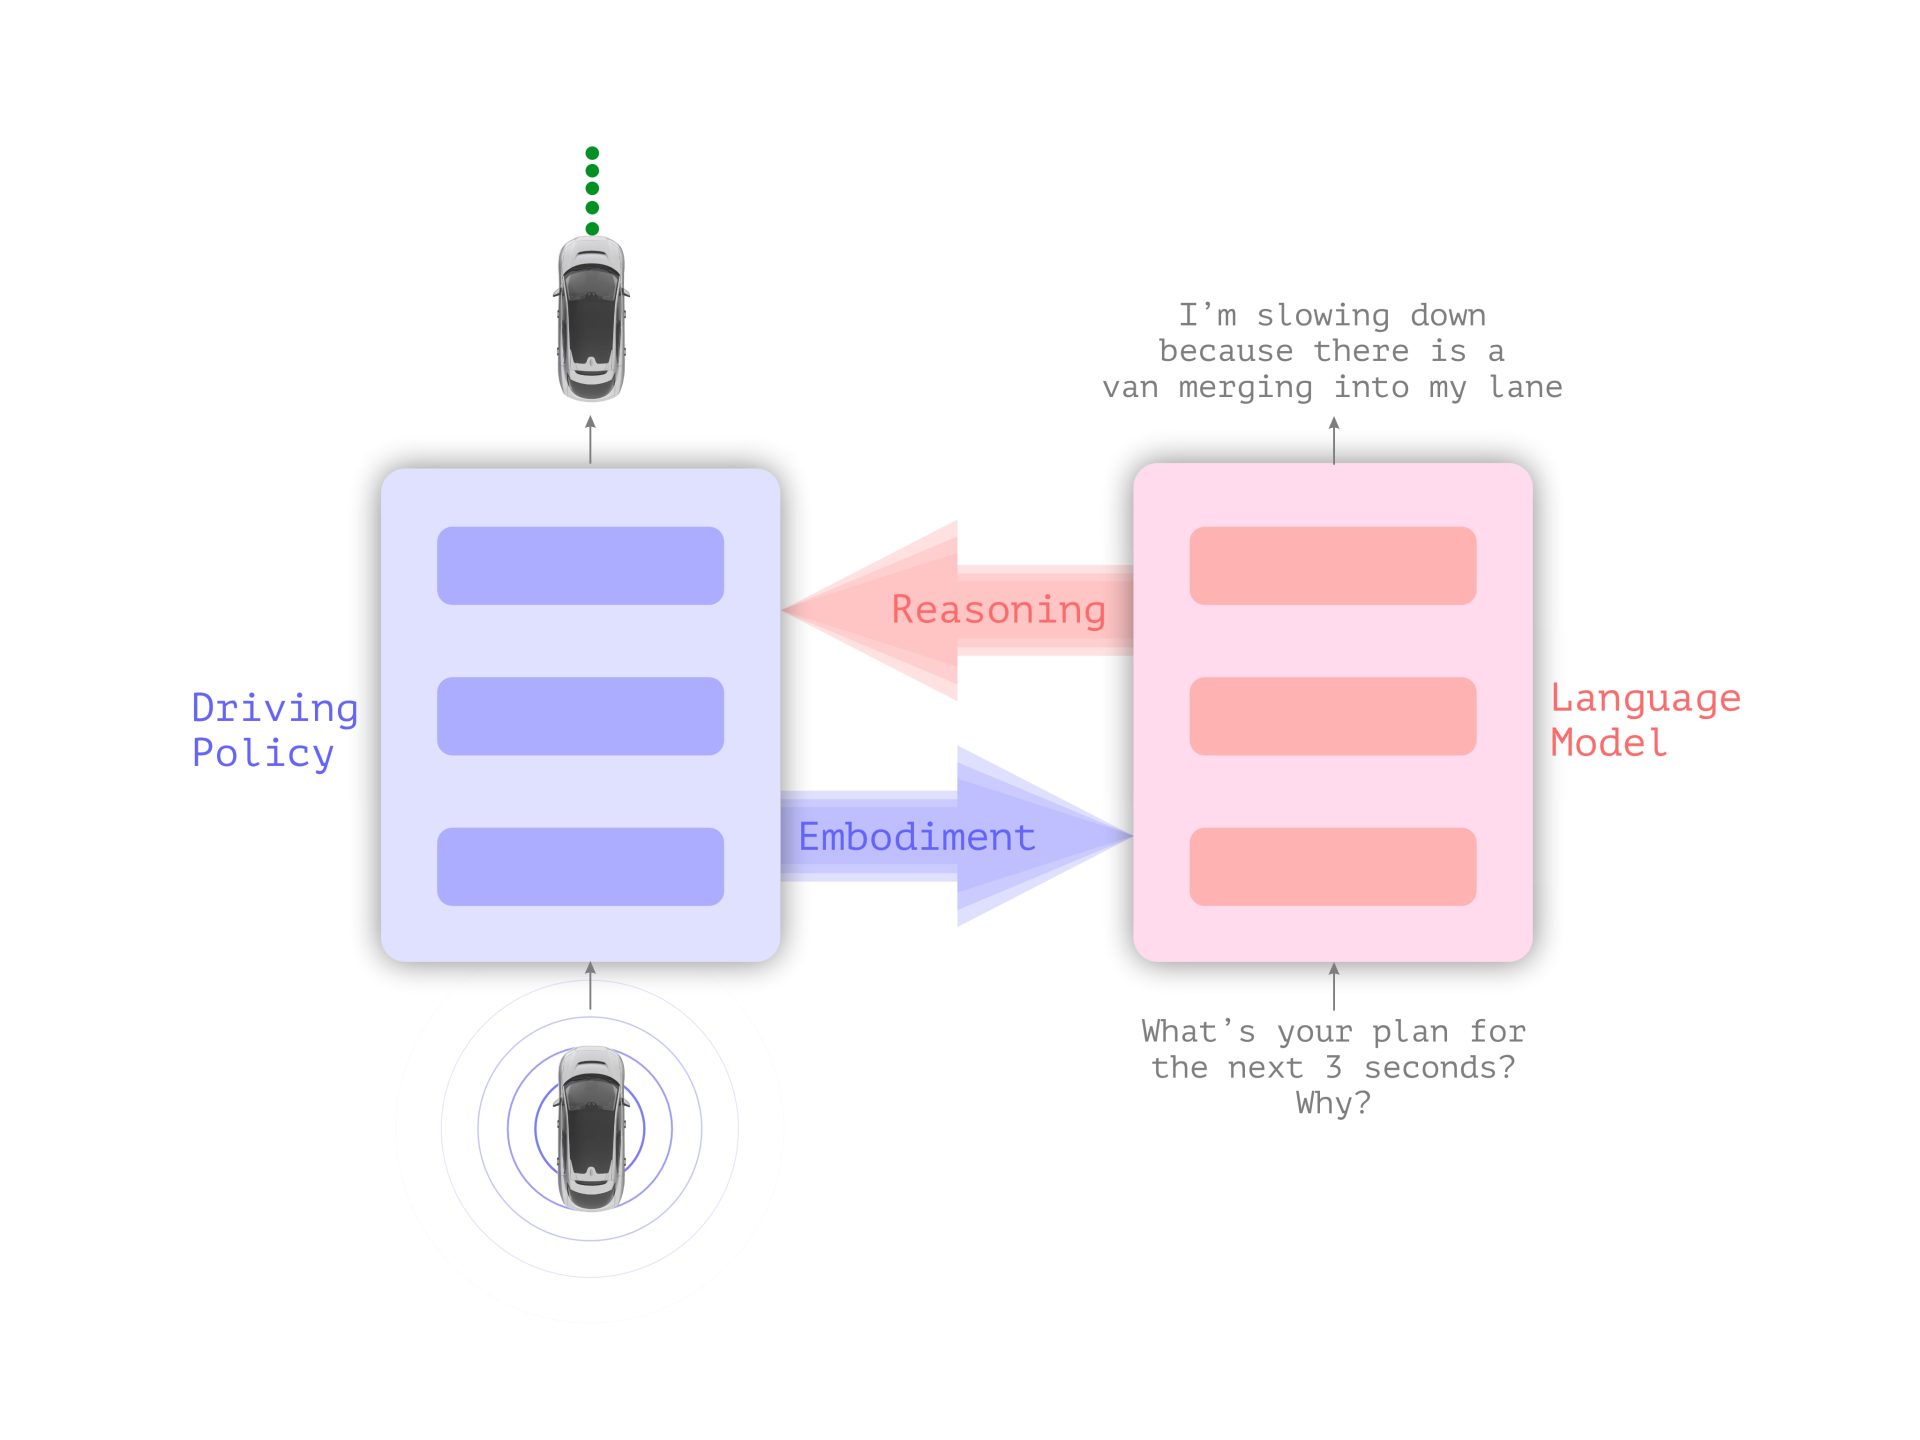
言語モデルと運転モデルを統合する上で重要な側面は、両者の間のグラウンディング(接地)です。運転パフォーマンスに影響を与える2つの主な要因は、様々な入力モダリティを使用してシーンを正確に解釈する言語モデルの能力と、中間レベルの推論を効果的な低レベルのプランニングに変換する運転モデルの習熟度です。
新しいシナリオやロングテールなシナリオに対応するための効率的な学習
「百聞は一見に如かず」と言いますが、トレーニングに関しては「一文は千枚の画像に匹敵」します。その理由を見てみましょう。自然言語を使用すれば、運転シーンにおける因果要因を説明できます。例えば、道路上の歩行者のために減速する車のトレーニング例が何千も必要な代わりに、特定の状況での行動方法や考慮すべき他の要因についての短いテキスト説明を添えた数個の例を使用できます。つまり、運転操作と因果推論の説明をモデルのトレーニングに組み込むことで、学習を加速させることができるのです。
因果推論は自動運転において極めて重要であり、システムがシーン内の要素とアクションの間の関係を理解することを可能にします。十分にグラウンディングされたVLAMは、基盤モデルが主要な因果構成要素を特定し、運転シーン内のエンティティ間のつながりを理解する上で、大幅な改善をもたらす可能性があります。例えば、システムは横断歩道で待っている歩行者と、「渡るな」を示す交通信号を関連付けることができます。この進歩は、特にデータが限られている困難なシナリオにおいて、プランニングを大幅に改善する可能性を秘めています。
さらに、LLMからの言語由来の汎用的な知識を運転モデルに組み込むことで、これまでに見たことのない新しい状況への汎化能力を高めることができます。LLMはインターネット規模のデータセットから人間の行動に関する膨大な知識をすでに備えており、物体の特定、交通規則、運転操作などの概念を理解する能力を持っています。例えば、言語モデルは、木、店、家、ボールを追いかける犬、学校の前に止まっているバスの違いを知っています。この知識を当社の基盤モデルに統合してシステムの生の知能を向上させることで、トレーニング例が限られている困難なロングテールシナリオに対処できるようになります。
この知識を実際の運転状況に適用することは依然として課題ですが、VLAMは画像データをより広範な情報でエンコードすることにより、より良く、より安全な自動運転を実現する可能性を提供します。これにより、学習プロセスが加速され、モデルの精度が向上し、多様な運転タスクを処理する能力が高まる可能性があります。
限界
LINGO-1は足がかりとなる機会を象徴しており、エンボディドAIの安全性と解釈可能性に多くの新しい可能性を切り拓きます。LINGO-1の急速な進歩に期待を寄せる一方で、いくつかの注意点を述べ、モデルの現在の限界について説明したいと思います。
限定的な汎化能力
現在、LINGO-1はロンドン中心部での運転経験とインターネット規模のテキストでトレーニングされています。トレーニングのベースとなっている幅広い知識から世界の運転文化の側面を学んではいますが、英国の道路規則についての解説が最も得意です。例えば、世界各国のどちら側を走行すべきかを述べることはできます。しかし、この知識を異なる国での実際の運転経験に結びつける(グラウンディングさせる)ことが、次のステップの一つです。
ハルシネーション(幻覚)
ハルシネーションは大規模言語モデルにおけるよく知られた問題であり、LINGO-1も例外ではありません。当社はRLHFやその他の一般的な手法を通じて、ハルシネーションの頻度と深刻度を抑え続けています。しかし、LINGO-1には標準的なLLMにはない、注目に値する利点があります。LINGO-1はビジョン、言語、アクションに根ざしているため、世界をより良く理解するための教師ソースがより多く存在します。テキストによる説明、ビデオで見るもの、そして世界との関わり方の間で推論し、理解を一致させることを学習できるため、因果関係を理解するための情報源が増えるのです。
限定的な時間的コンテキスト
ビデオのディープラーニングは、ビデオデータが通常、画像やテキストのデータセットよりも桁違いに大きいため、困難な課題です。特に、ビデオベースのマルチモーダル言語モデルは、複雑でダイナミックな運転シーンを推論するために、多くのビデオフレームを埋め込むことができる長いコンテキスト長を必要とします。私たちは、非常に長いコンテキストを持つトランスフォーマーモデルを使用することが極めて重要であることを見出しました。パートナーであるMicrosoft Azureとともに、LINGO-1のパフォーマンスを向上させるために、スケールの限界を押し広げるべく懸命に取り組んでいます。
クローズドループ推論
現在、私たちはモデルの説明可能性に取り組んでいますが、最終的には大規模言語モデルの推論能力を実際の運転に反映させたいと考えています。将来的にLINGO-1を当社の自動運転車両フリートに搭載して実行できるようにするクローズドループ・アーキテクチャの開発を進めています。
結論
当社のオープンループ・ドライビング・コメンテーターであるLINGO-1は、自然言語を使用して基盤運転モデルの学習と説明可能性を強化するための重要な第一歩を提供します。ロボットのトレーニングにおける自然言語の統合はまだ初期段階にありますが、エンドツーエンドの自動運転に向けたこの研究を推進できることを嬉しく思います。
この研究の将来的な応用の可能性には胸が躍ります。単純なテキストプロンプトを通じて道路交通法(Highway Code)の変更に合わせて自動運転システムを更新したり、ロボットカーに前方の道路状況について尋ねたりできることを想像してみてください。自然言語は、より安全で信頼性の高い自動運転車両の開発において大きな可能性を秘めています。
自動運転の未来を形作るという私たちの情熱に共感していただけるなら、ロンドンまたはベイエリアでの募集職種を確認し、この刺激的な旅にぜひ加わってください!
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む