








15 11月 2023 | リサーチ
リファレンシャル・セグメンテーションによるLINGO-1の「Show and Tell」機能の公開
当社はLINGO-1に新しい「show and tell」機能を開発しました。これはリファレンシャル・セグメンテーションを使用してLINGO-1が注視している対象を視覚的に強調するもので、言語タスクと視覚タスクの連携を強化し、最終的により正確で信頼性の高い応答を可能にします。
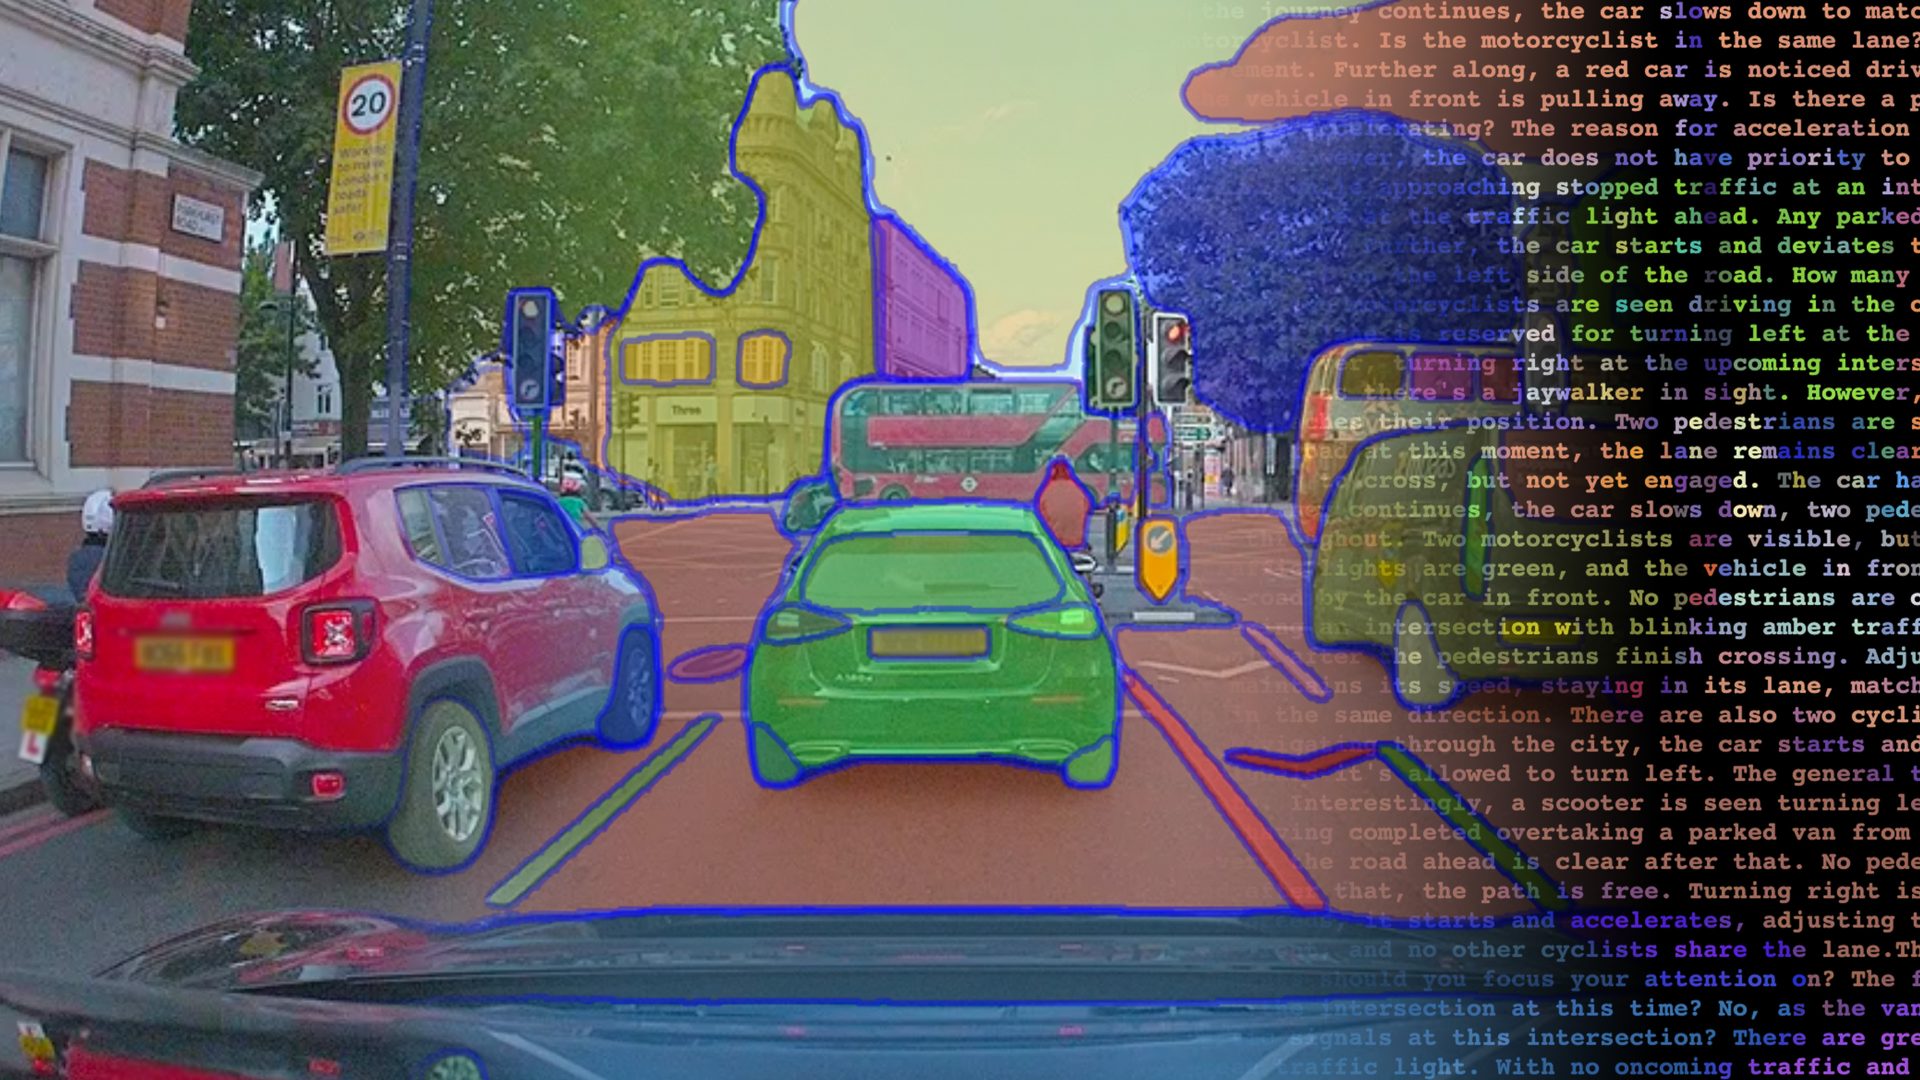
9月、私たちはブログで自動運転における自然言語の活用について紹介しました。その中で触れたのがLINGO-1です。これは視覚、言語、行動を組み合わせることで、当社の基盤運転モデルの解釈、説明、トレーニング方法を強化するオープンループのドライビング・コメンテーターです。LINGO-1を通じて、言語を使用してモデルに走行シーンに関する質問を投げかけ、モデルが何を理解しているかをより深く把握する方法を示してきました。
 LINGO-1による視覚的質疑応答(VQA)の例
しかし、LINGO-1が走行シーンの正しい部分に注意を払っているかどうかを、どうすれば確認できるでしょうか?
上記の例では、AIモデルがどの「道路を横断している歩行者」に焦点を当てているかをどうやって知ることができるでしょうか?もう一つの関連する疑問は、そのシーンに関連する道路規則の理解についてです。例えば、「自転車のマークがあるボックスは何を示していますか?」と尋ねるかもしれません。LINGO-1がテキストによる回答と並行して、こうした要素に注意を払っていることを確認することは非常に重要です。
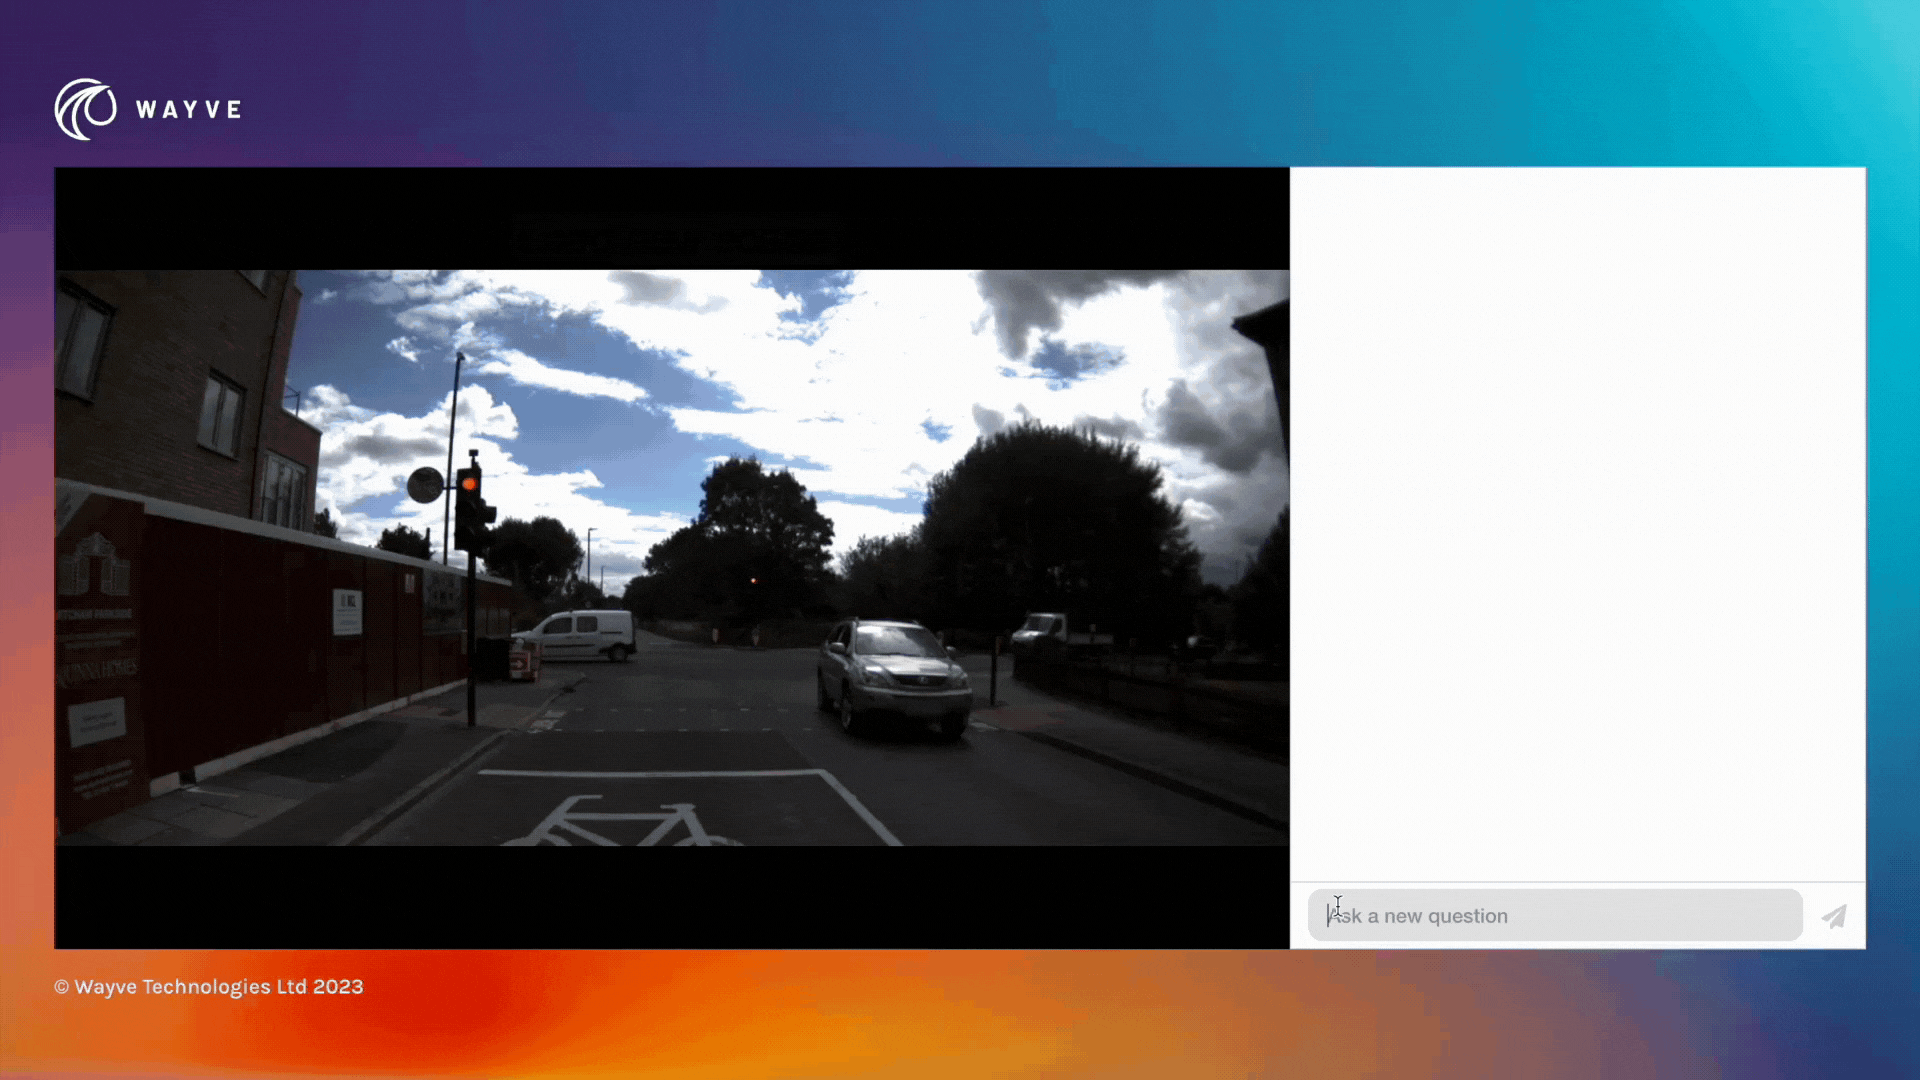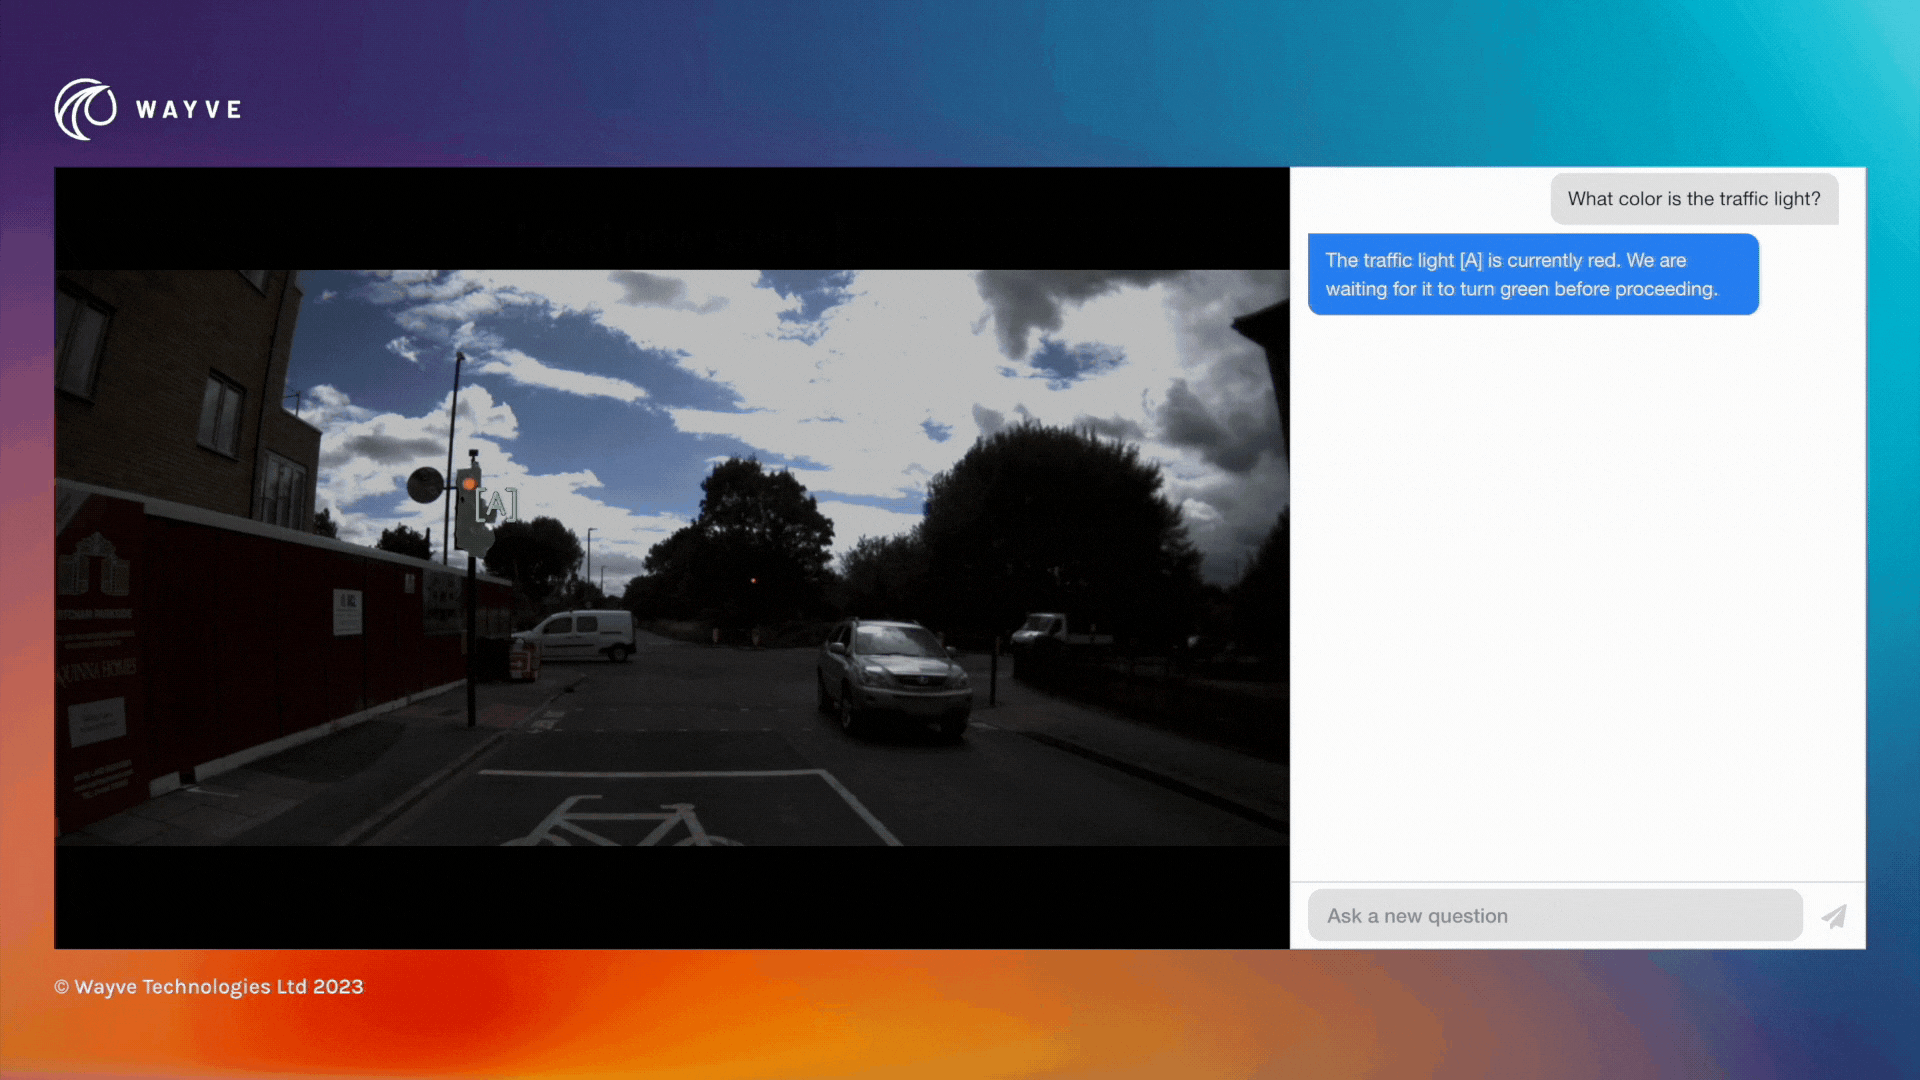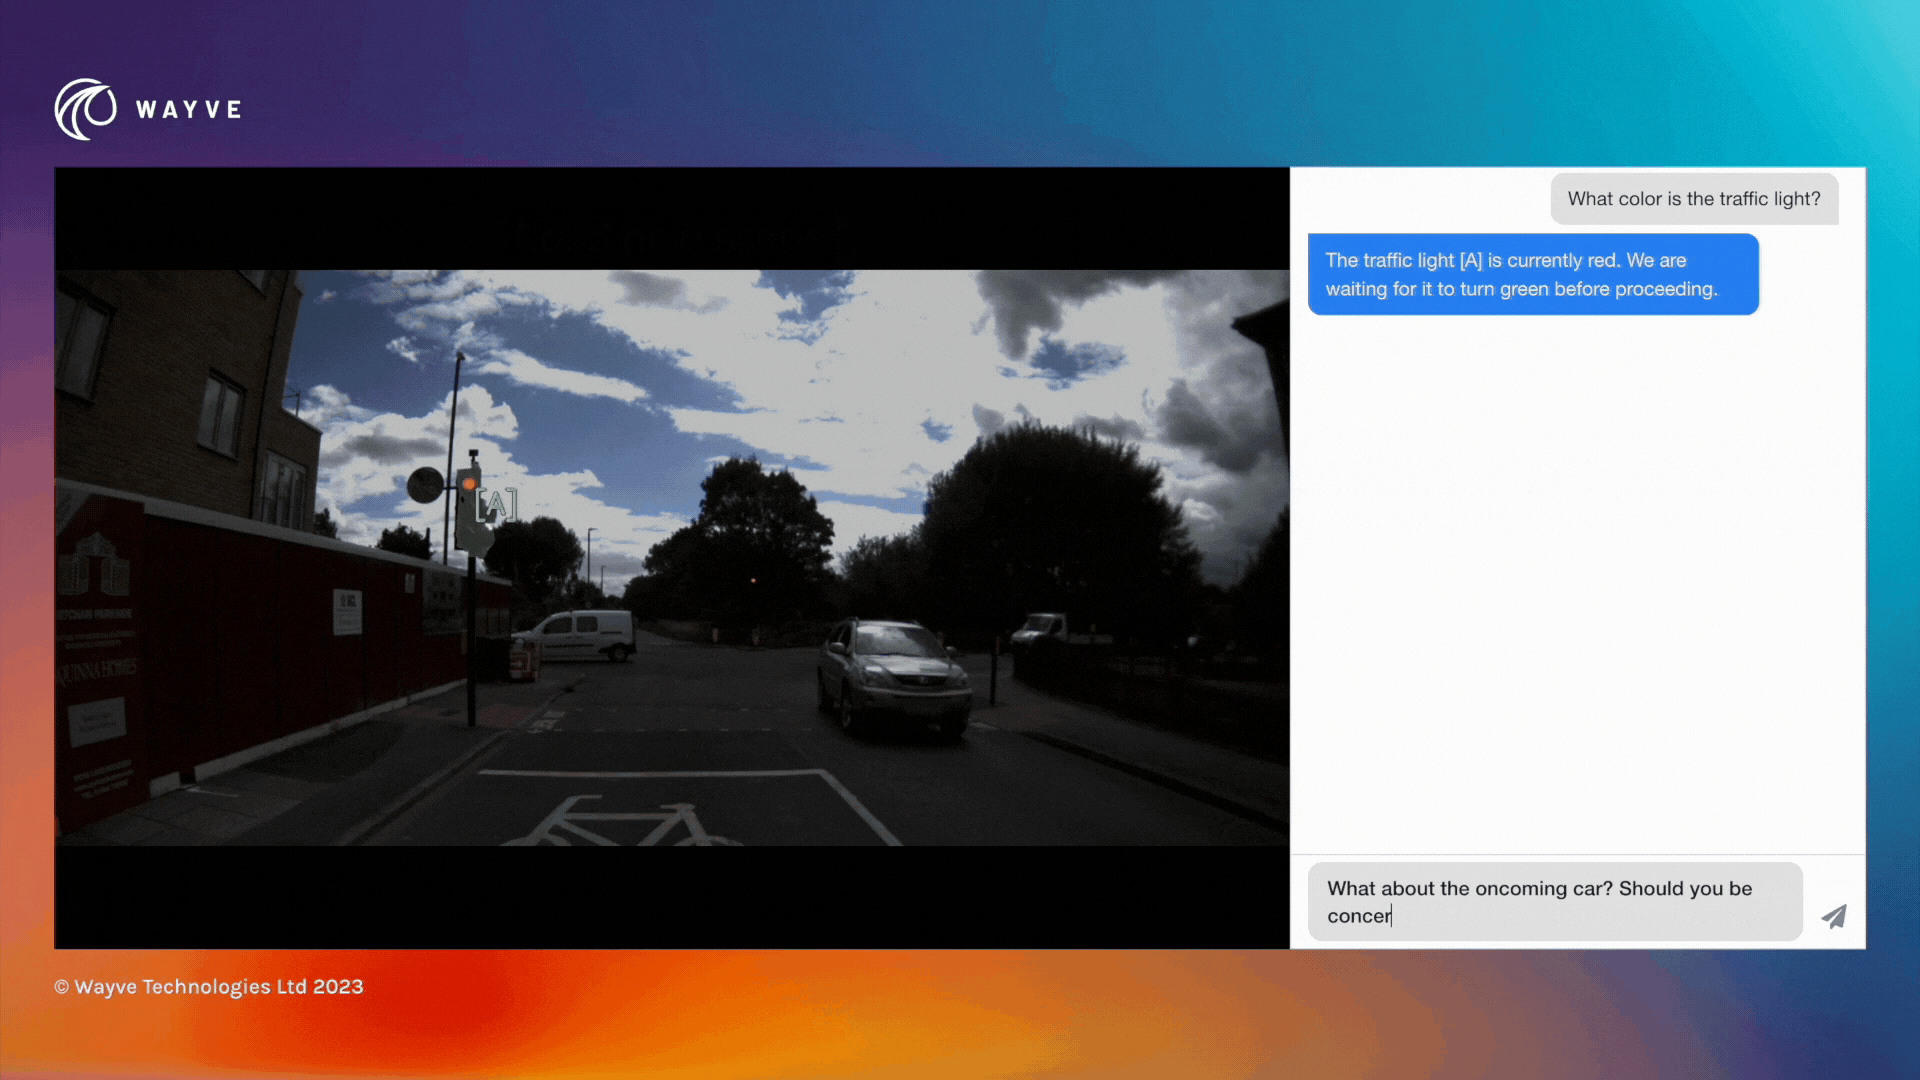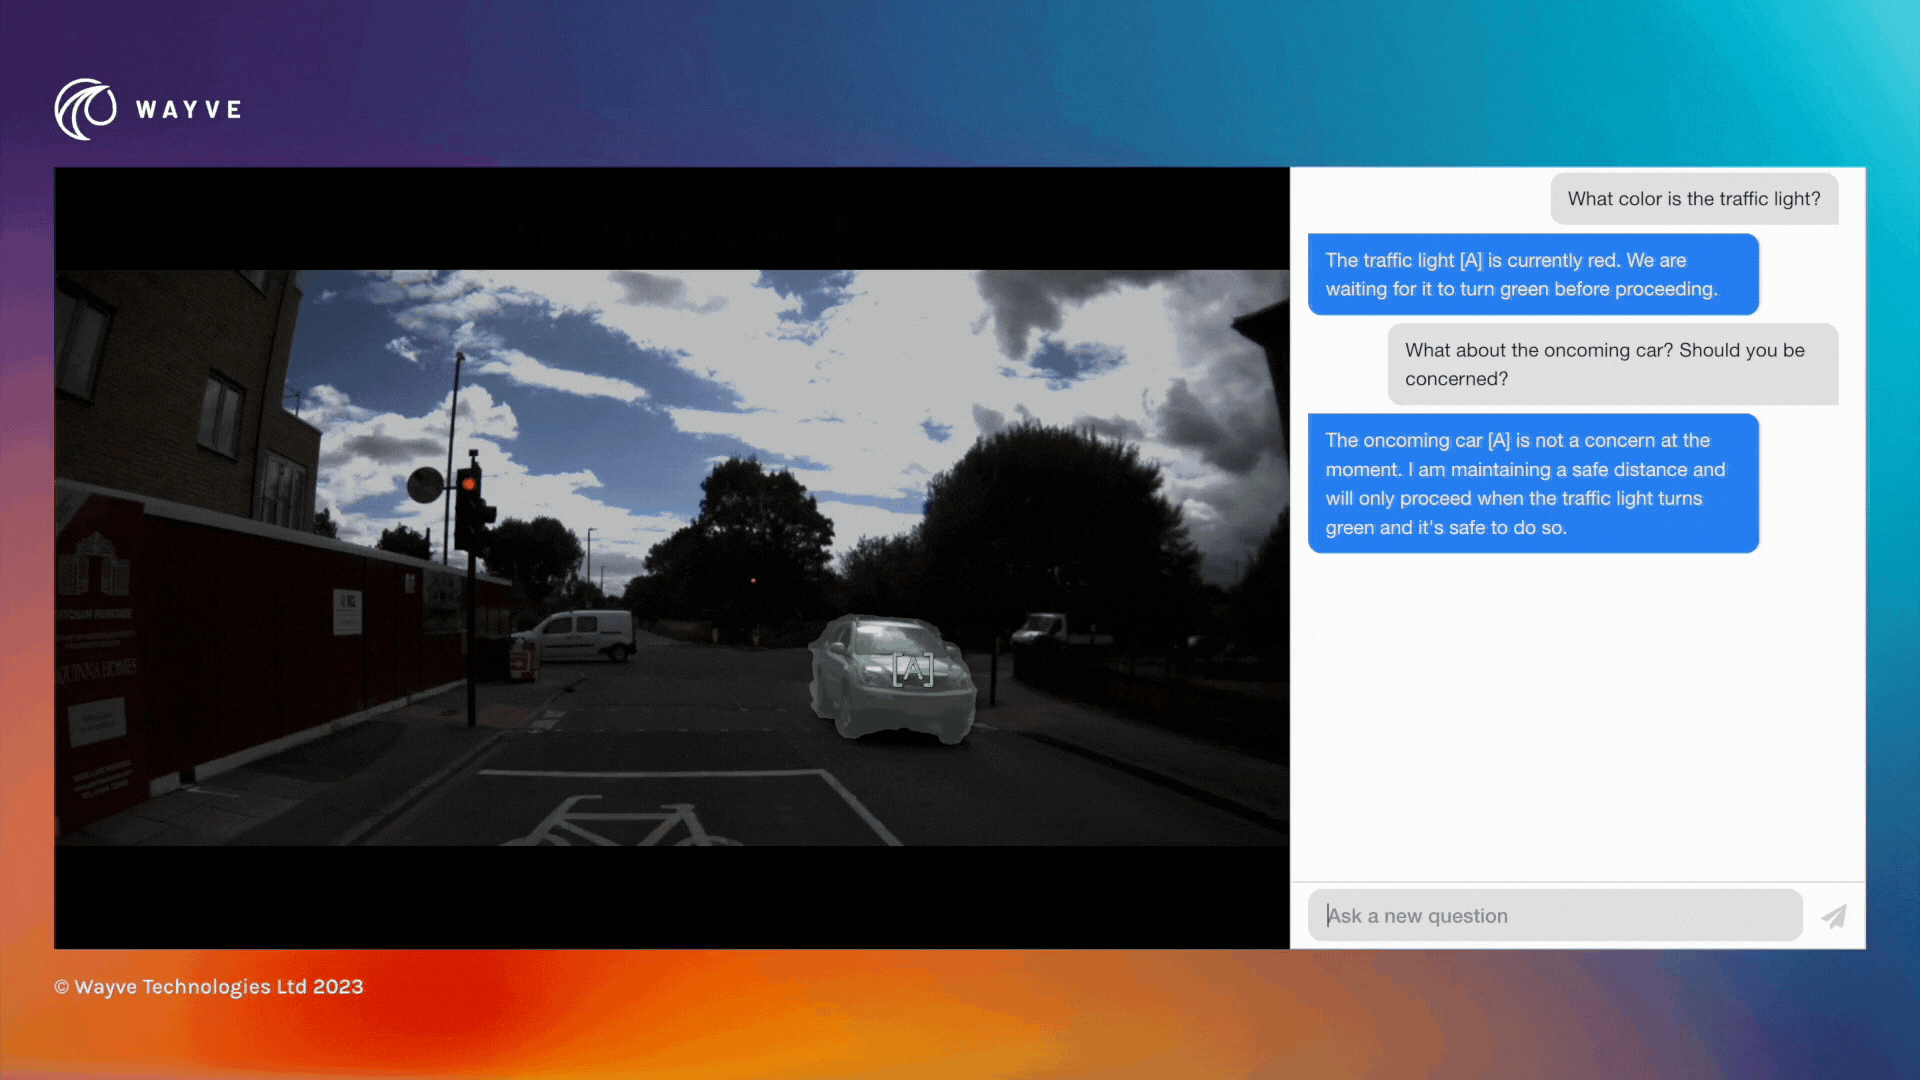
そこで、シーン内のオブジェクトをテキストで説明するだけでなく、リファレンシャル・セグメンテーションを使用して注視点を視覚的に示す新しい「show and tell」機能を開発しました。これは、LINGO-1のテキスト応答に関連する画像内の領域をマーキングすることを意味します。この新しい開発により、言語タスクと視覚タスクの間のより強力な「グラウンディング(結びつき)」が確立され、LINGO-1の応答に対する信頼性が向上します。
リファレンシャル・セグメンテーションを通じて、LINGO-1はシーン内のオブジェクトを特定して説明するだけでなく、自身の注意と理解の視覚的な証拠を提供することができます。
以下のビデオでは、信号機の色について尋ねると、LINGO-1は「信号機は現在赤です」と正確に説明すると同時に、画像フレーム内の信号機を[A]で強調表示します。さらに、LINGO-1は赤信号に対する正しい運転対応について、「進行する前に青に変わるのを待っています」と詳しく説明できます。ご覧の通り、この新機能は言語タスクと視覚タスクのリンクを強化し、LINGO-1の応答の正確性と関連性を評価する能力と信頼性を向上させます。
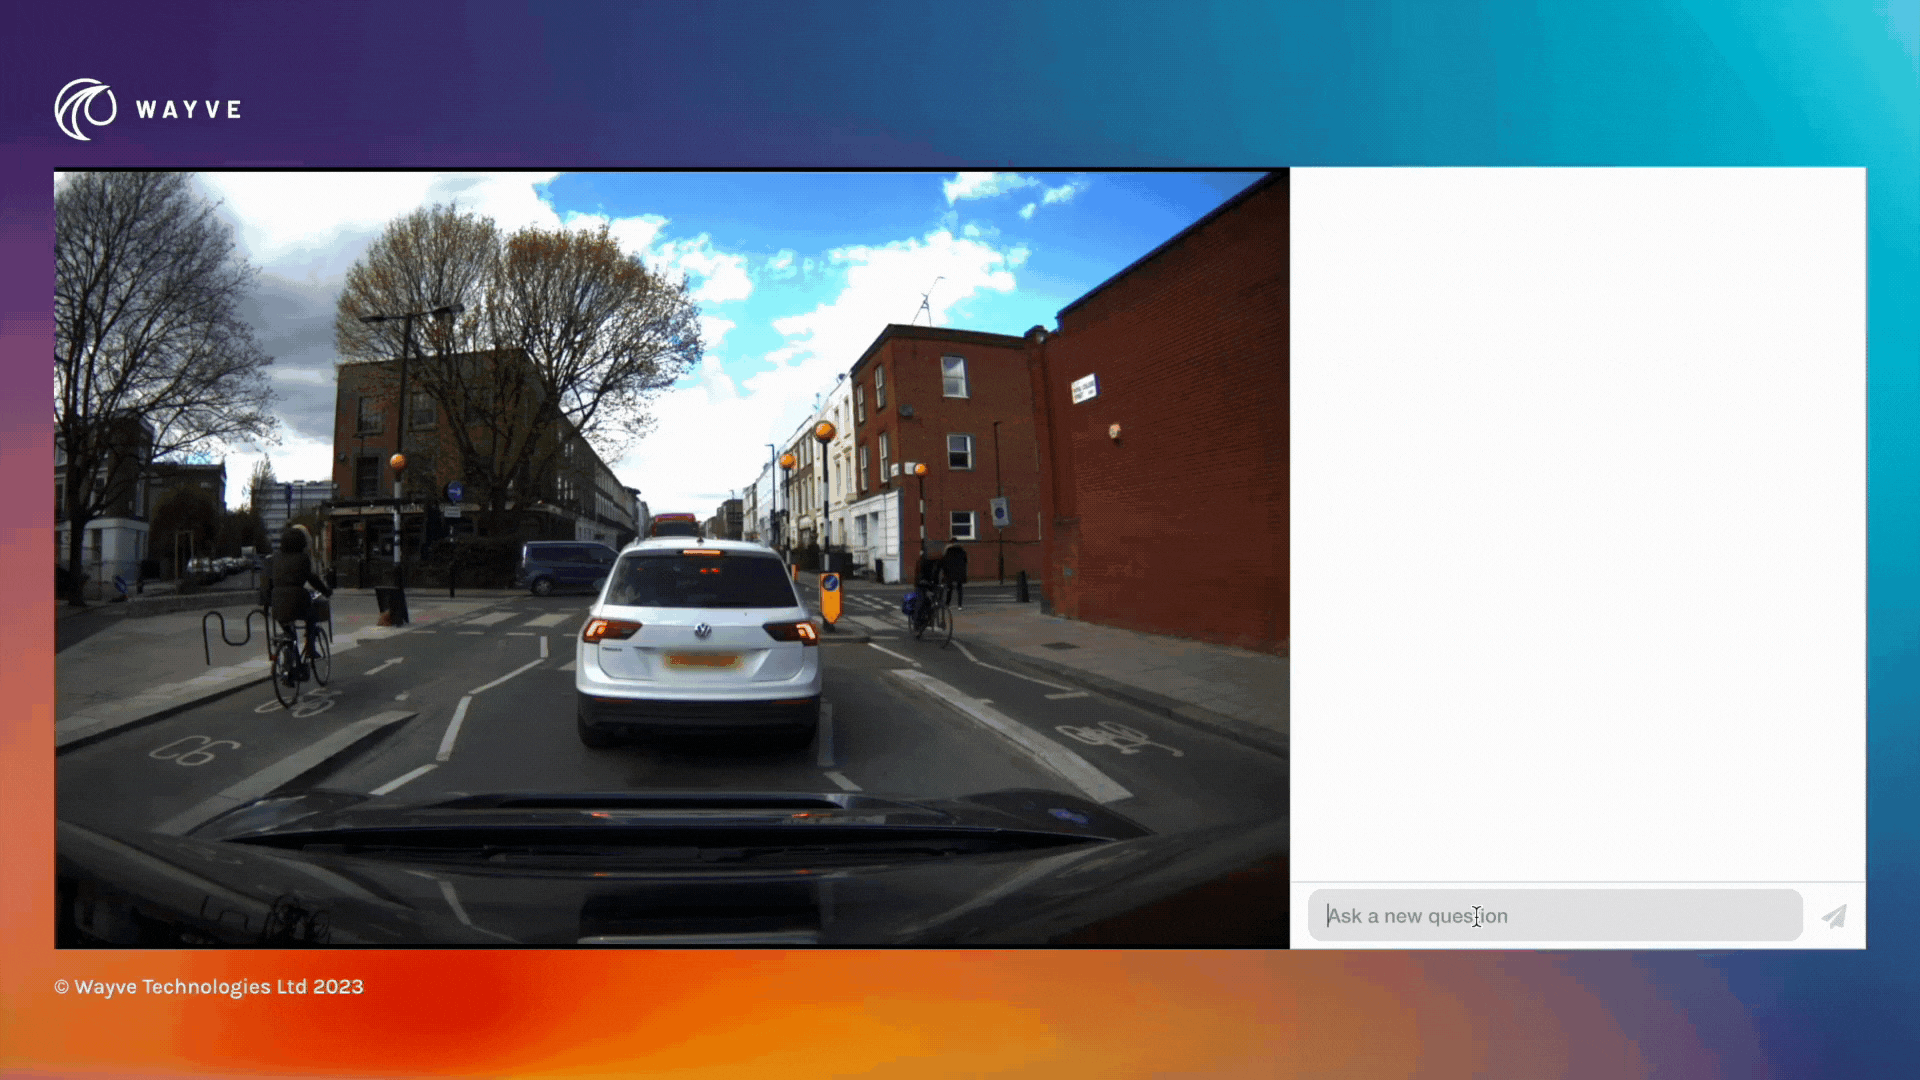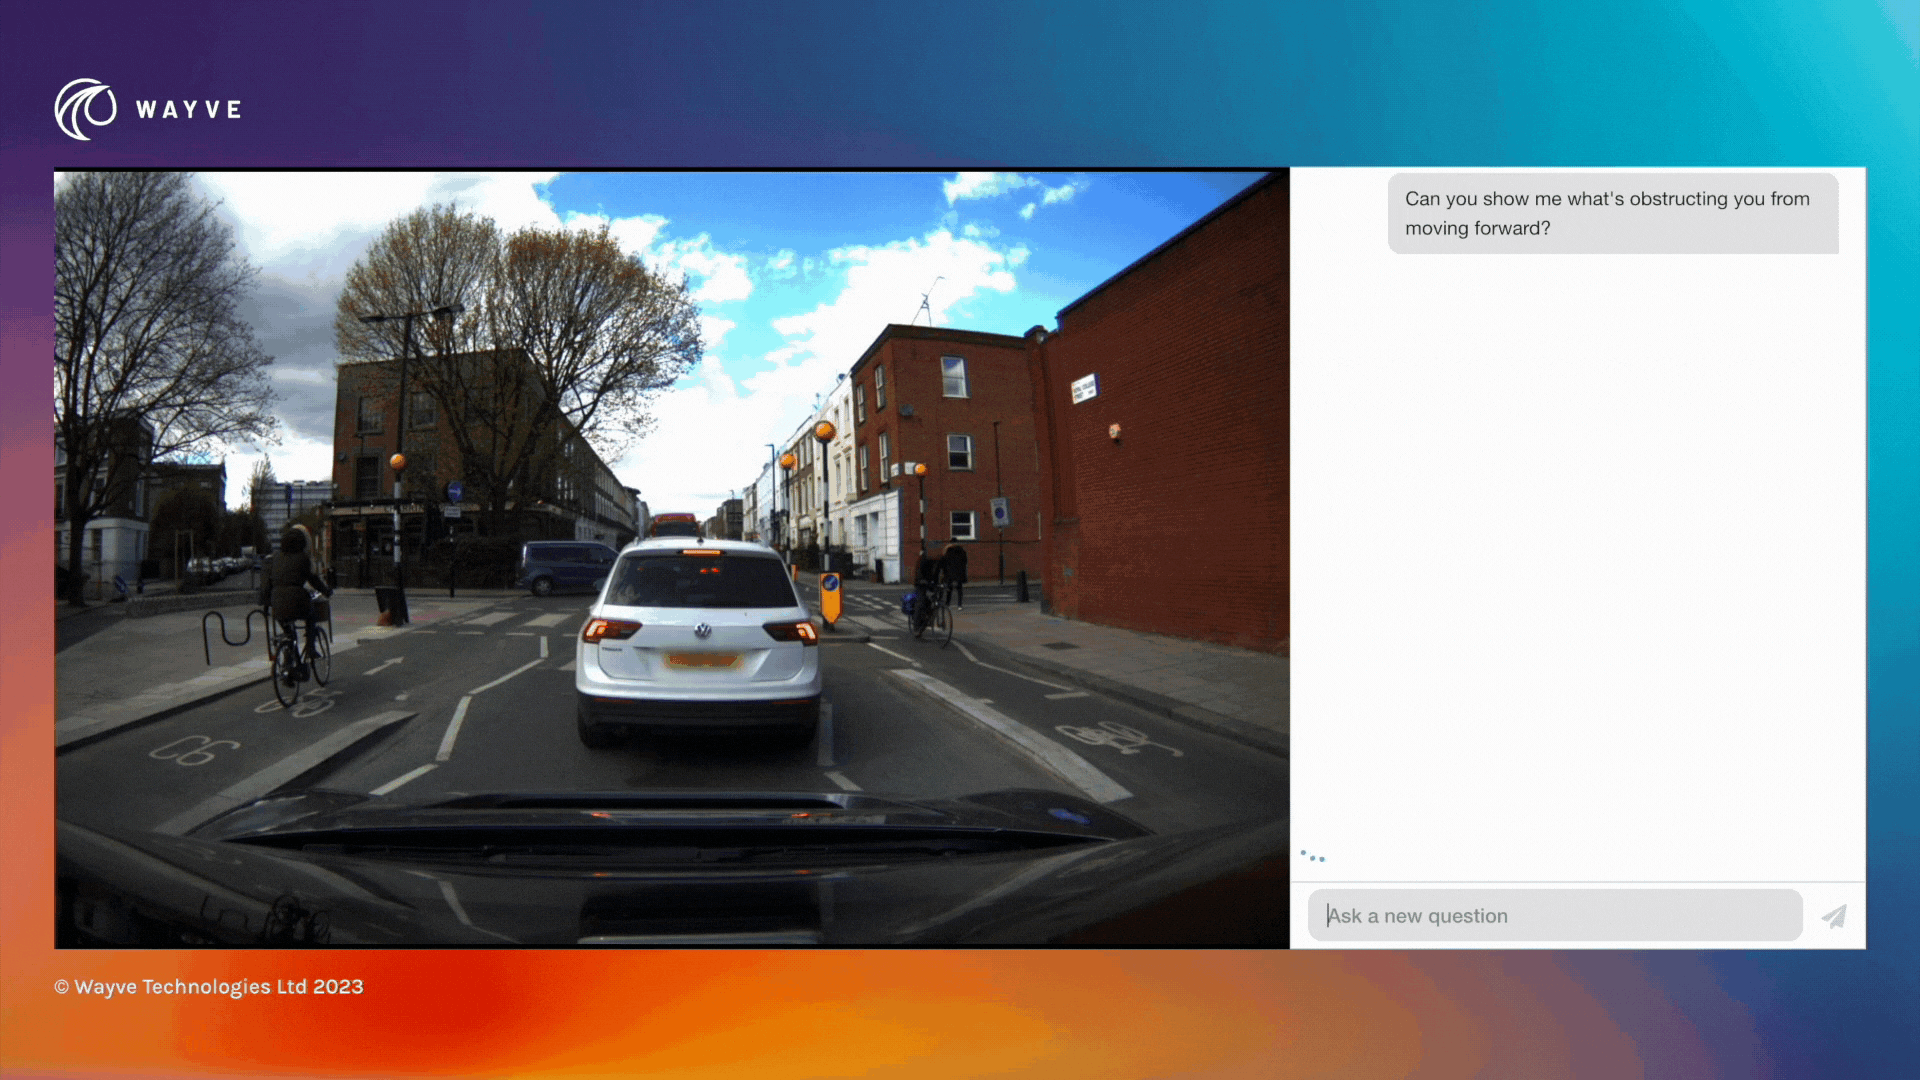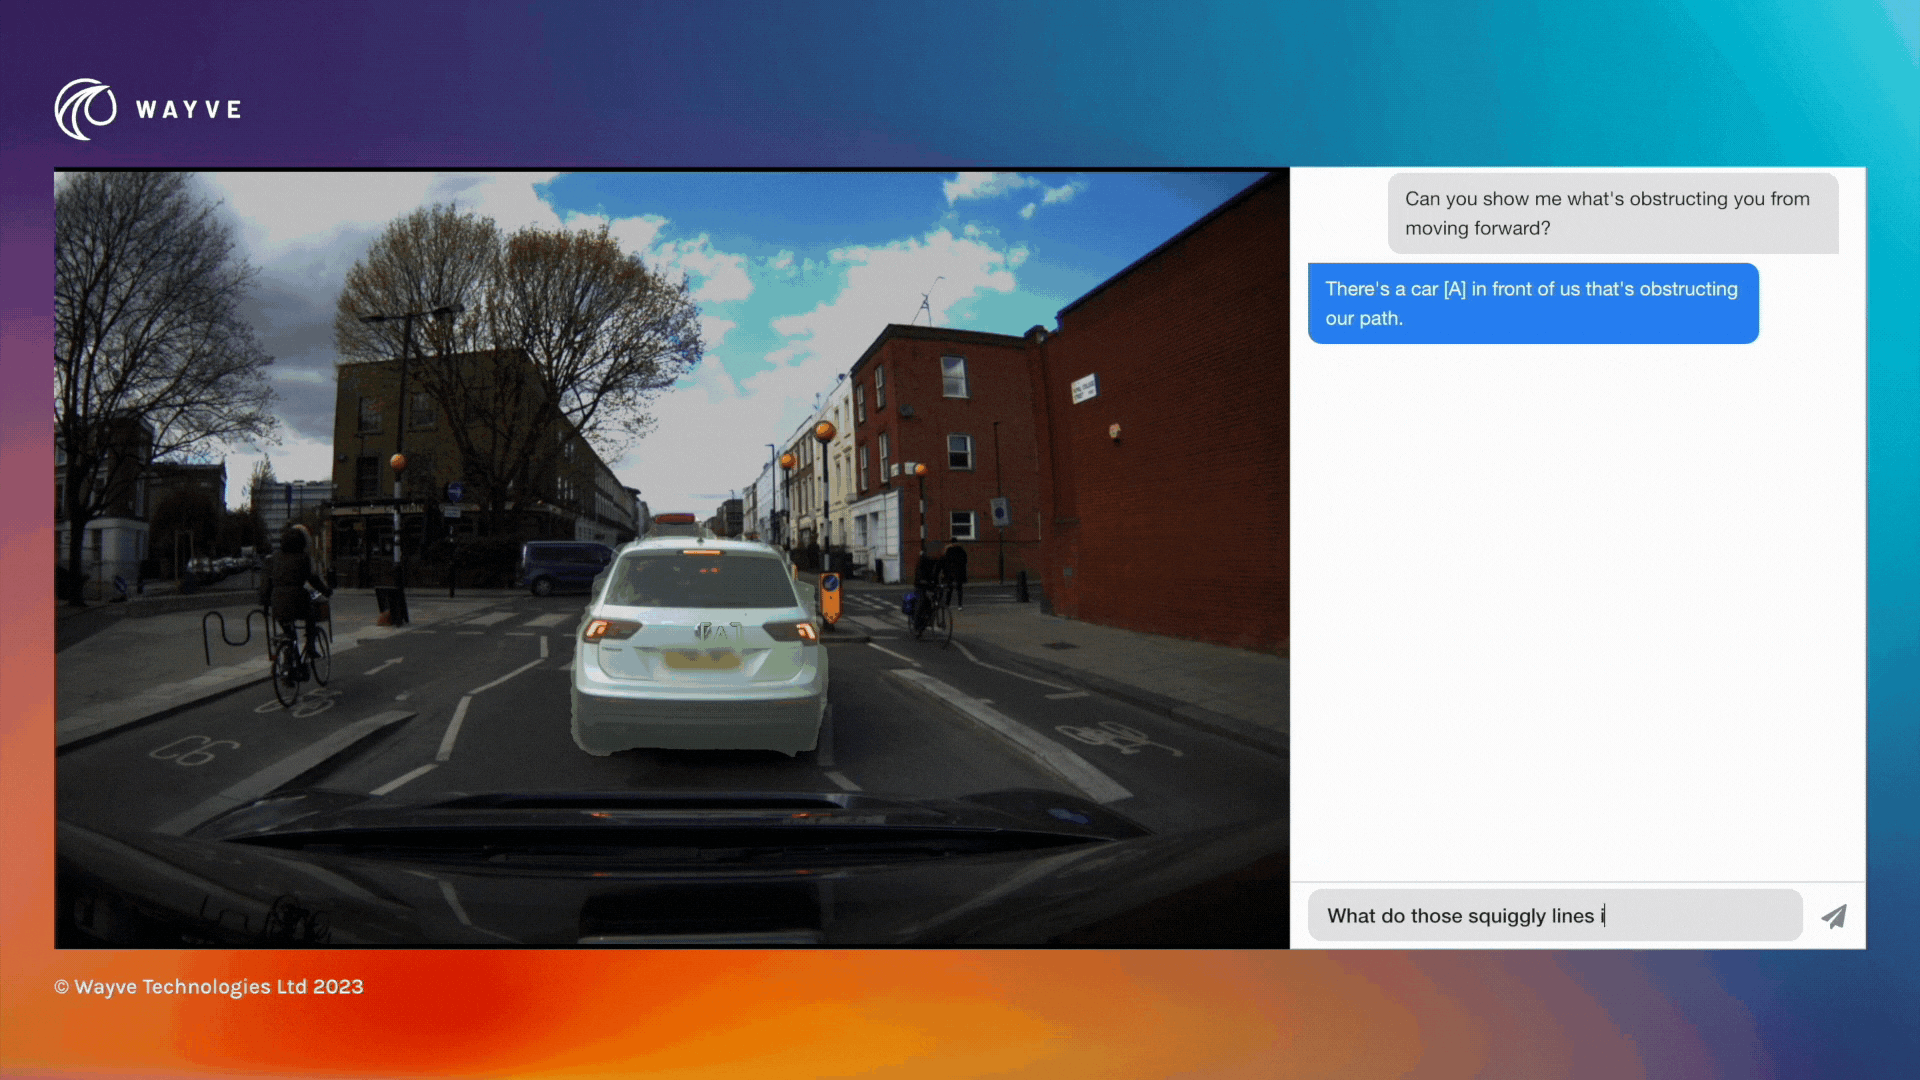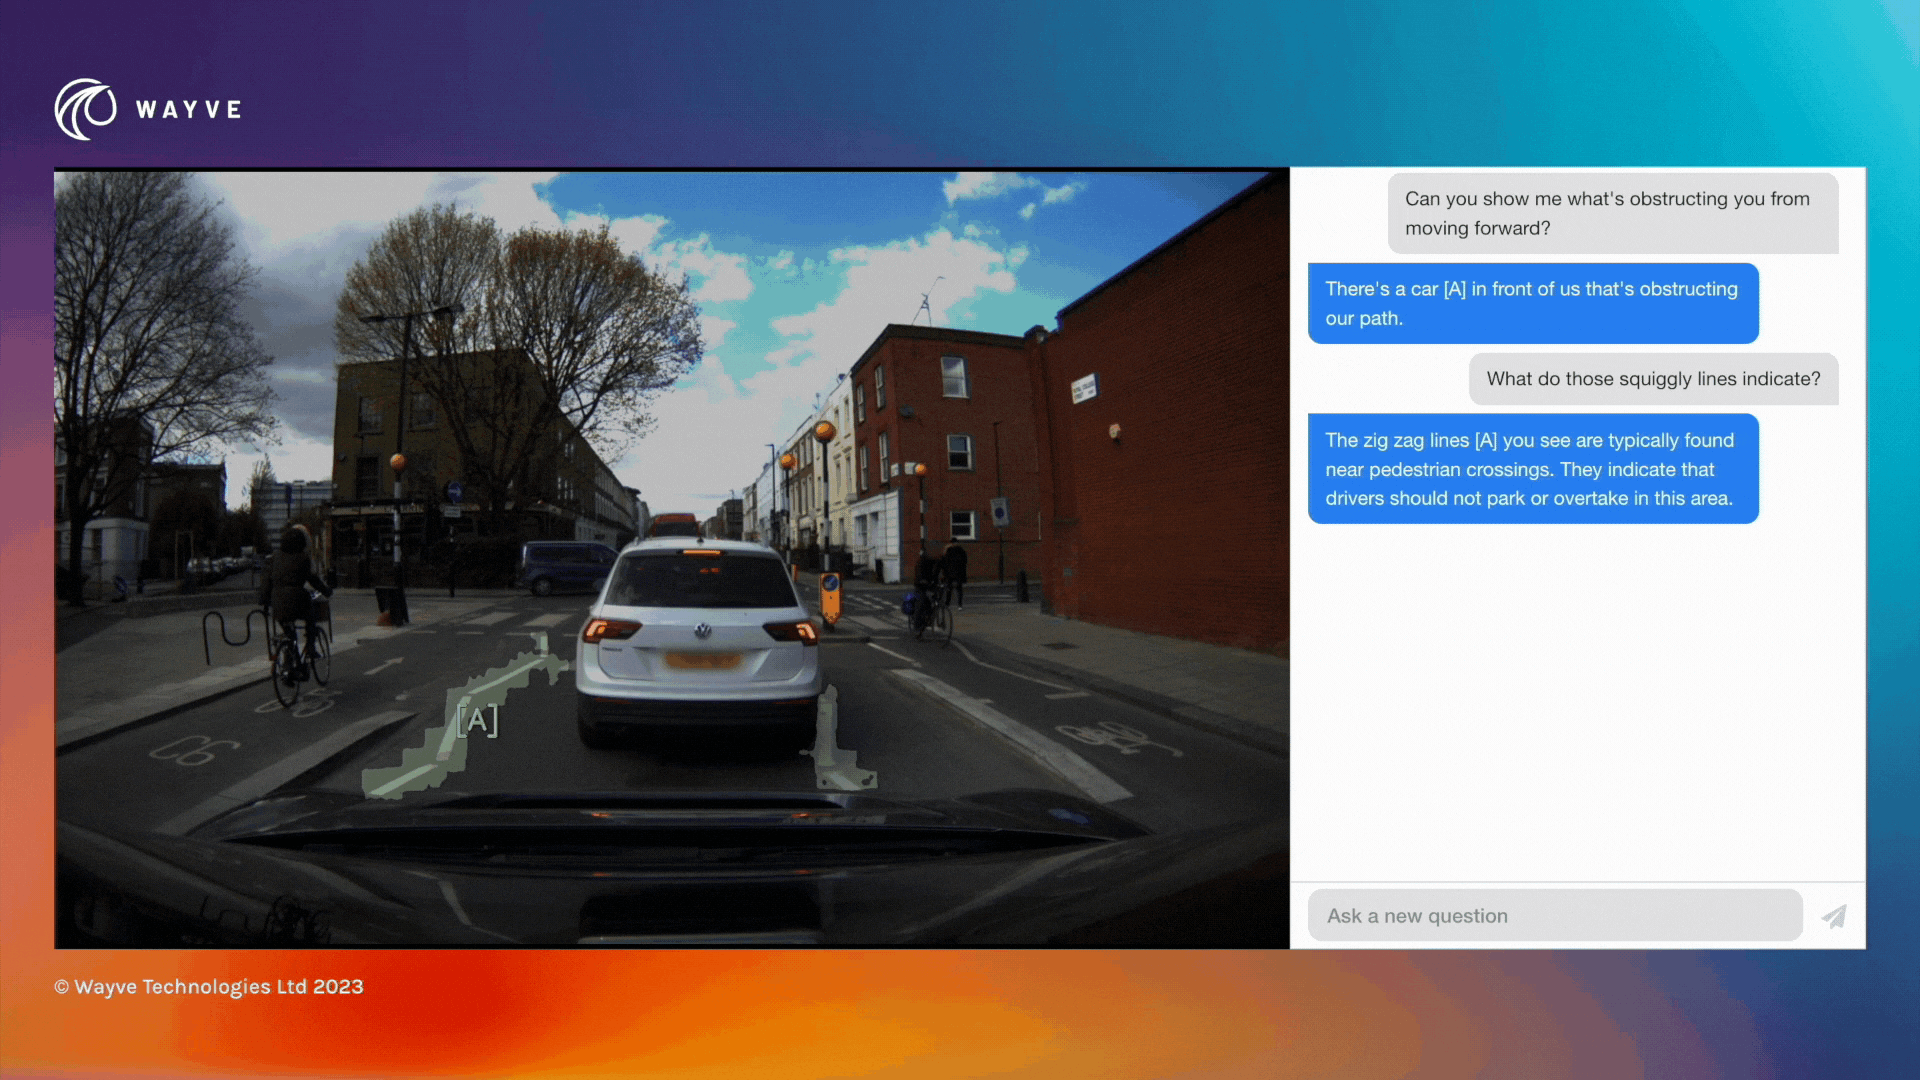
リファレンシャル・セグメンテーションは、相互検証を通じたマルチモーダルな説明可能性への道を開きます。関心のあるオブジェクトを動的に強調することで、LINGO-1はシーンの包括的な理解を示します。次の例では、LINGO-1はシーン内の要素を正確に特定し、道路交通法(Highway Code)に規定された特定の道路規則に関連付けています。「あの波線は何を示していますか?」という質問に対し、LINGO-1は「見えているジグザグの線[A]は、通常、歩行者用横断歩道の近くにあります。これは、ドライバーがこのエリアで駐車や追い越しをしてはいけないことを示しています」と正しく回答します。
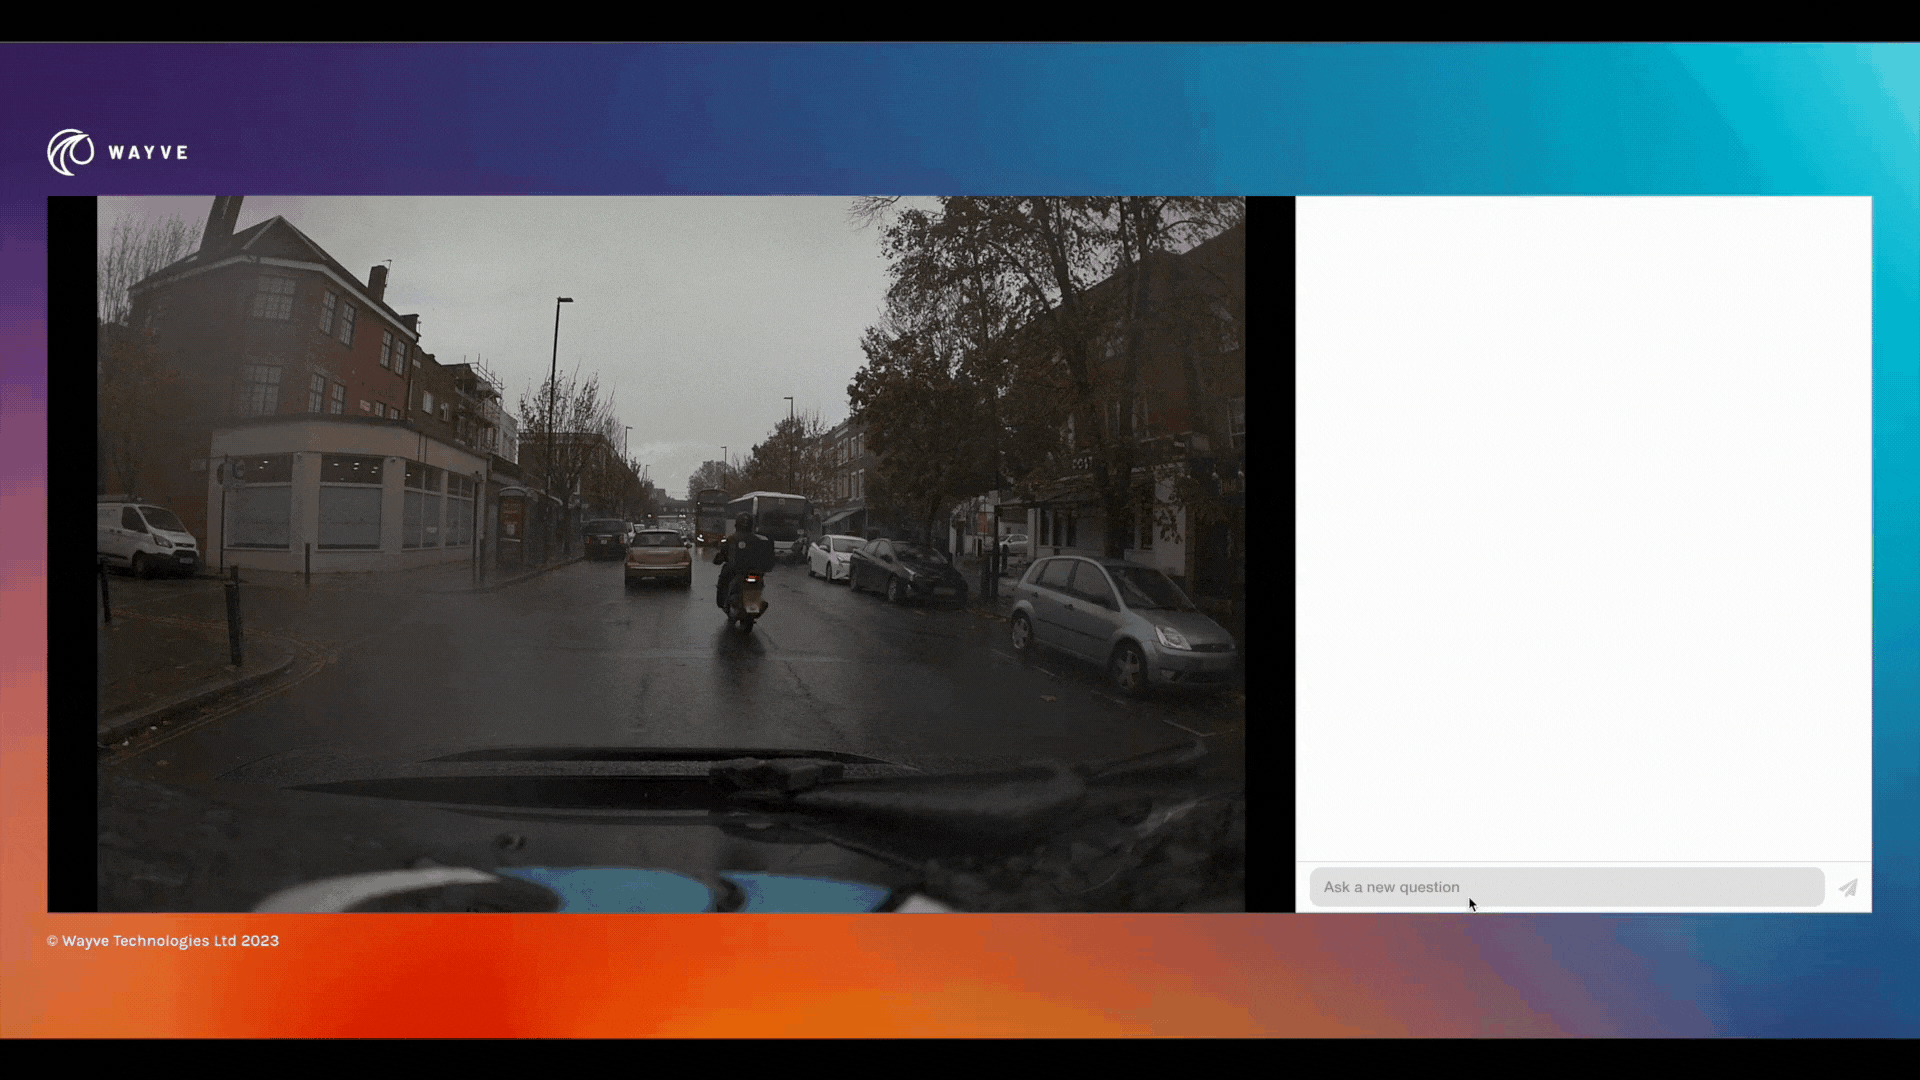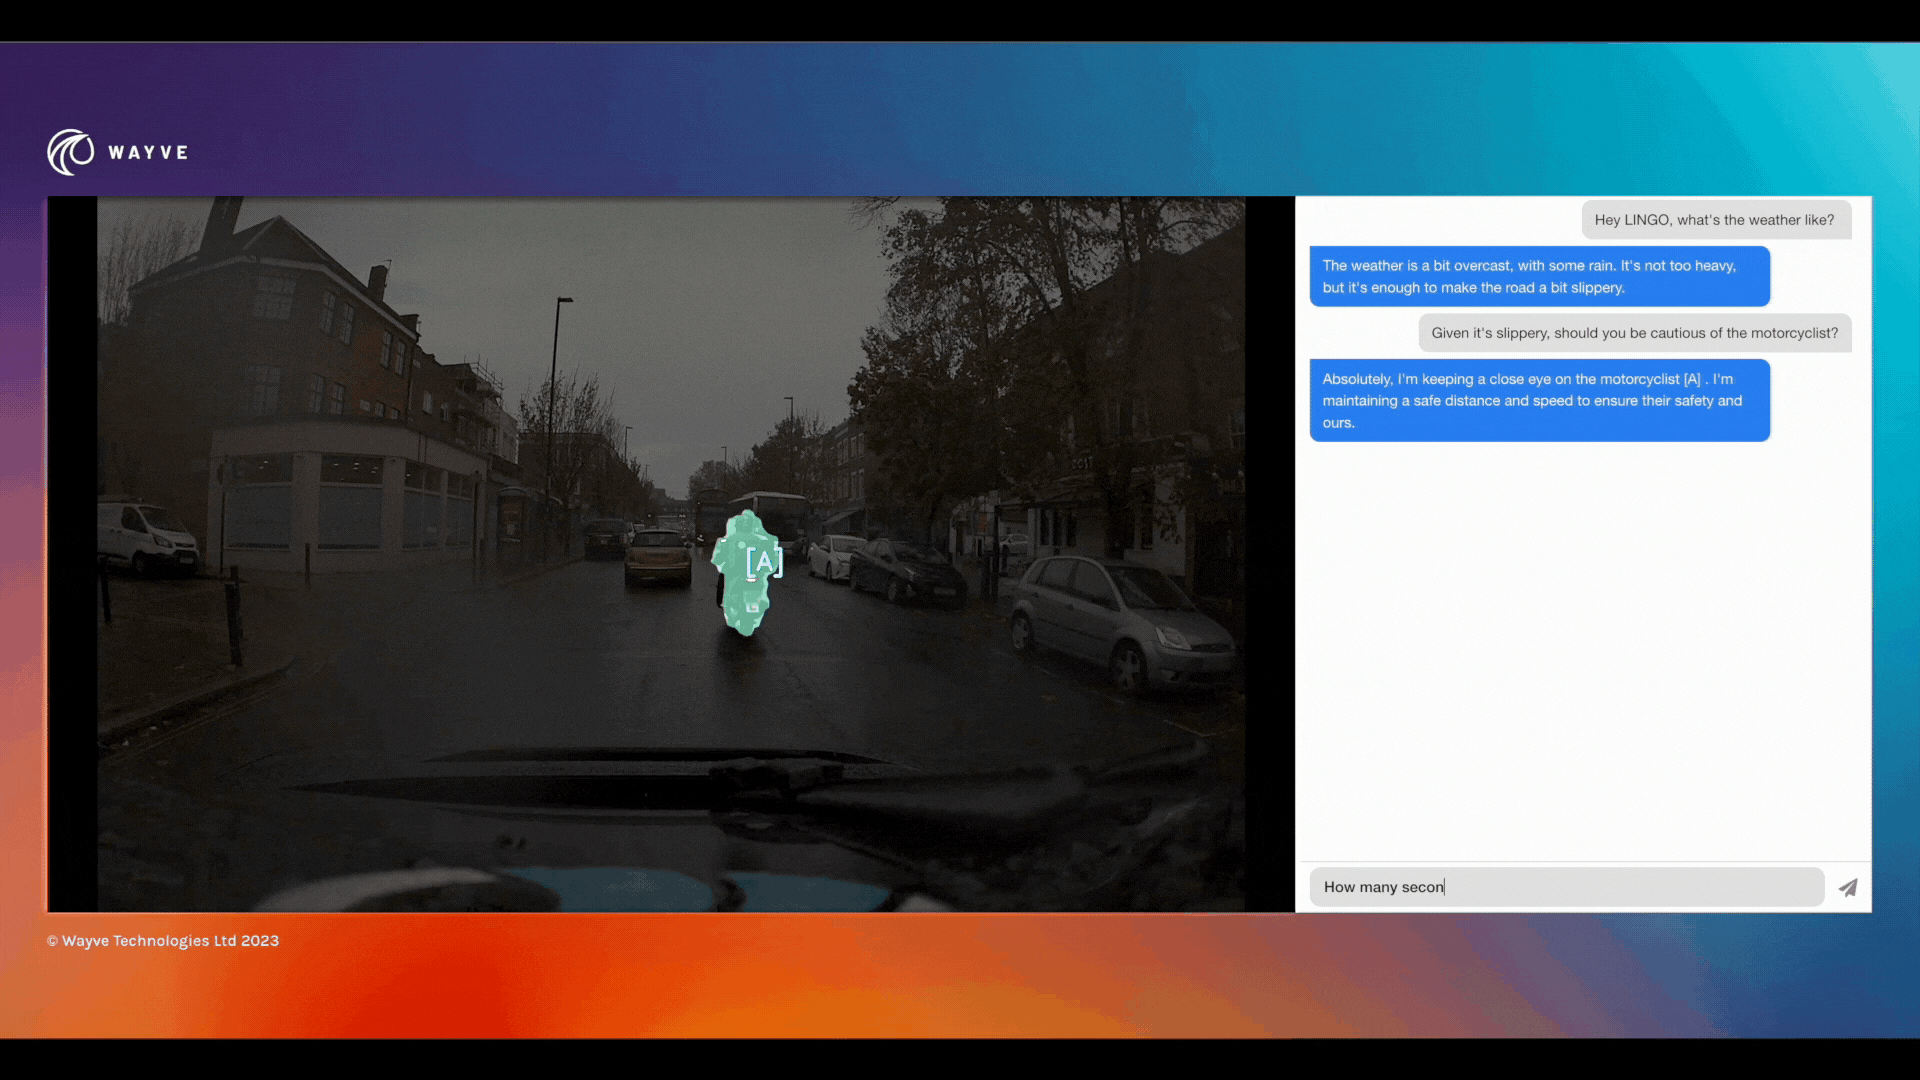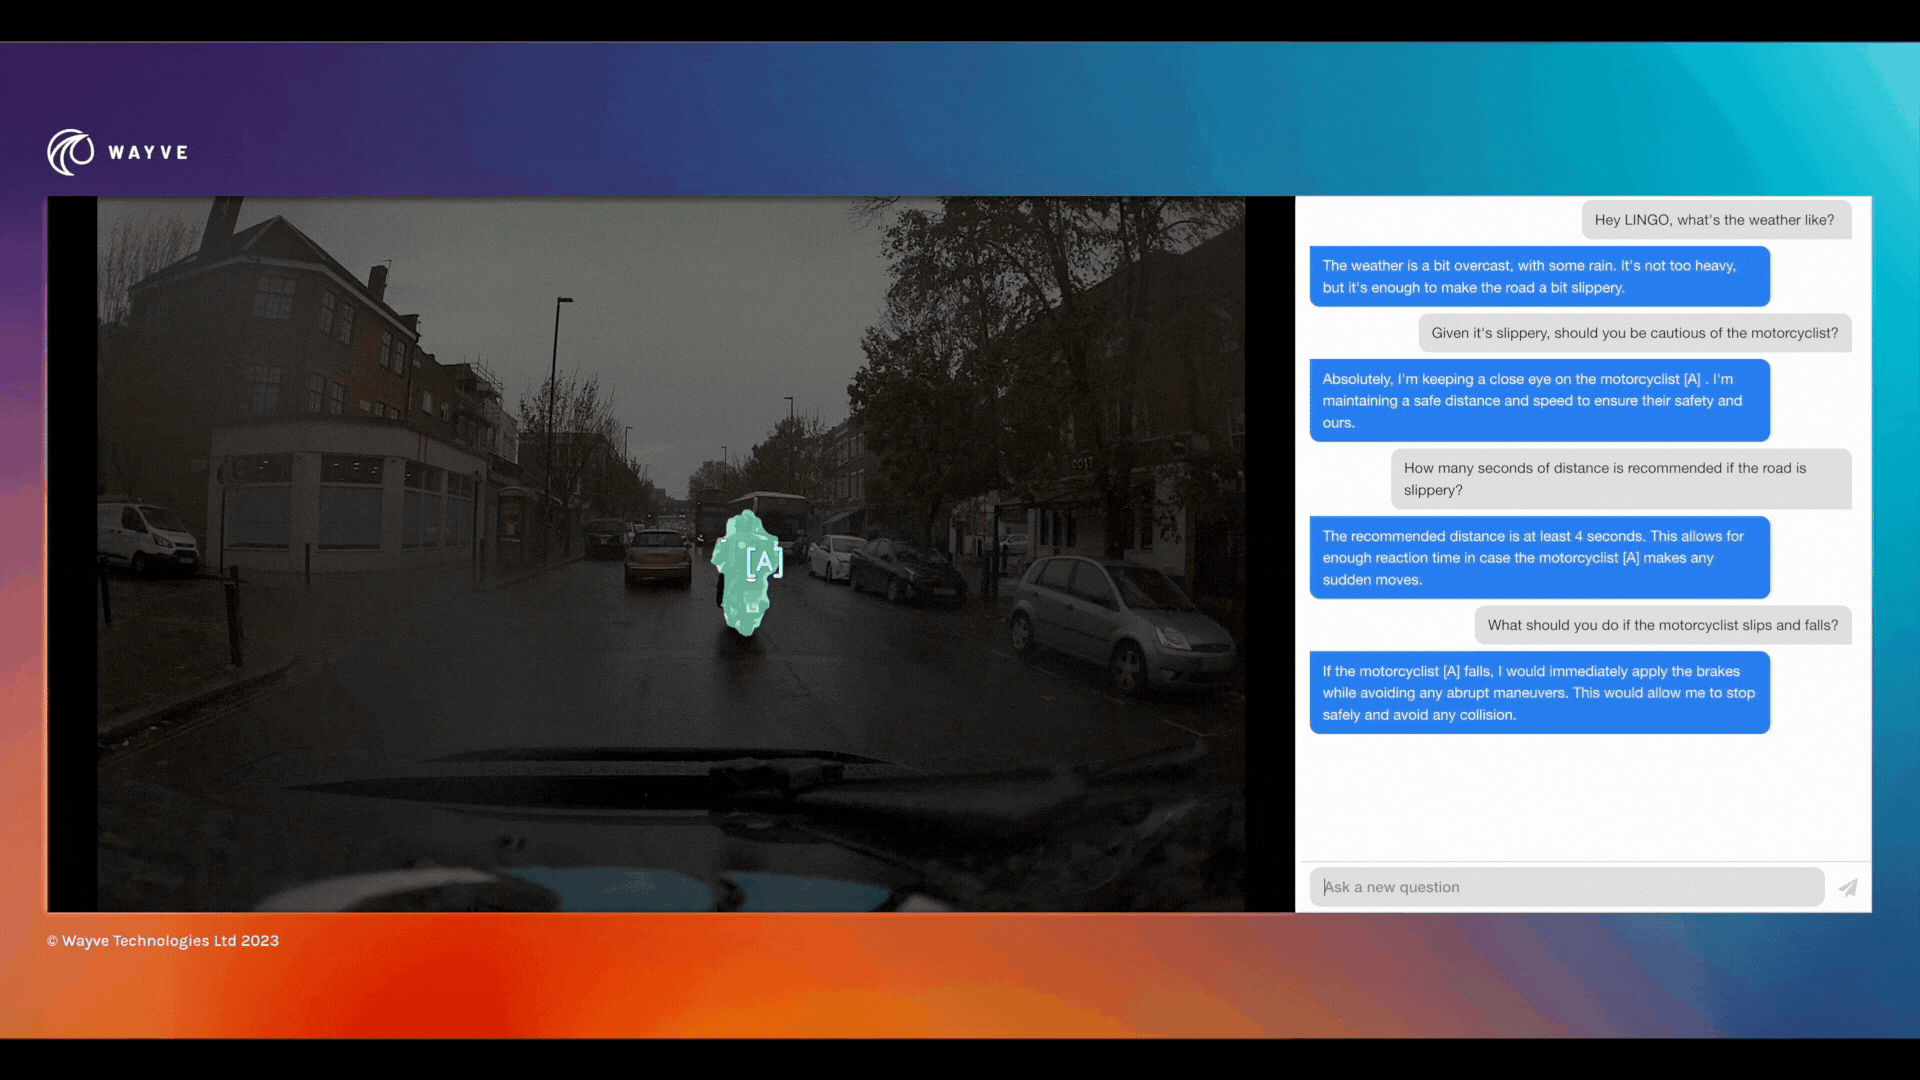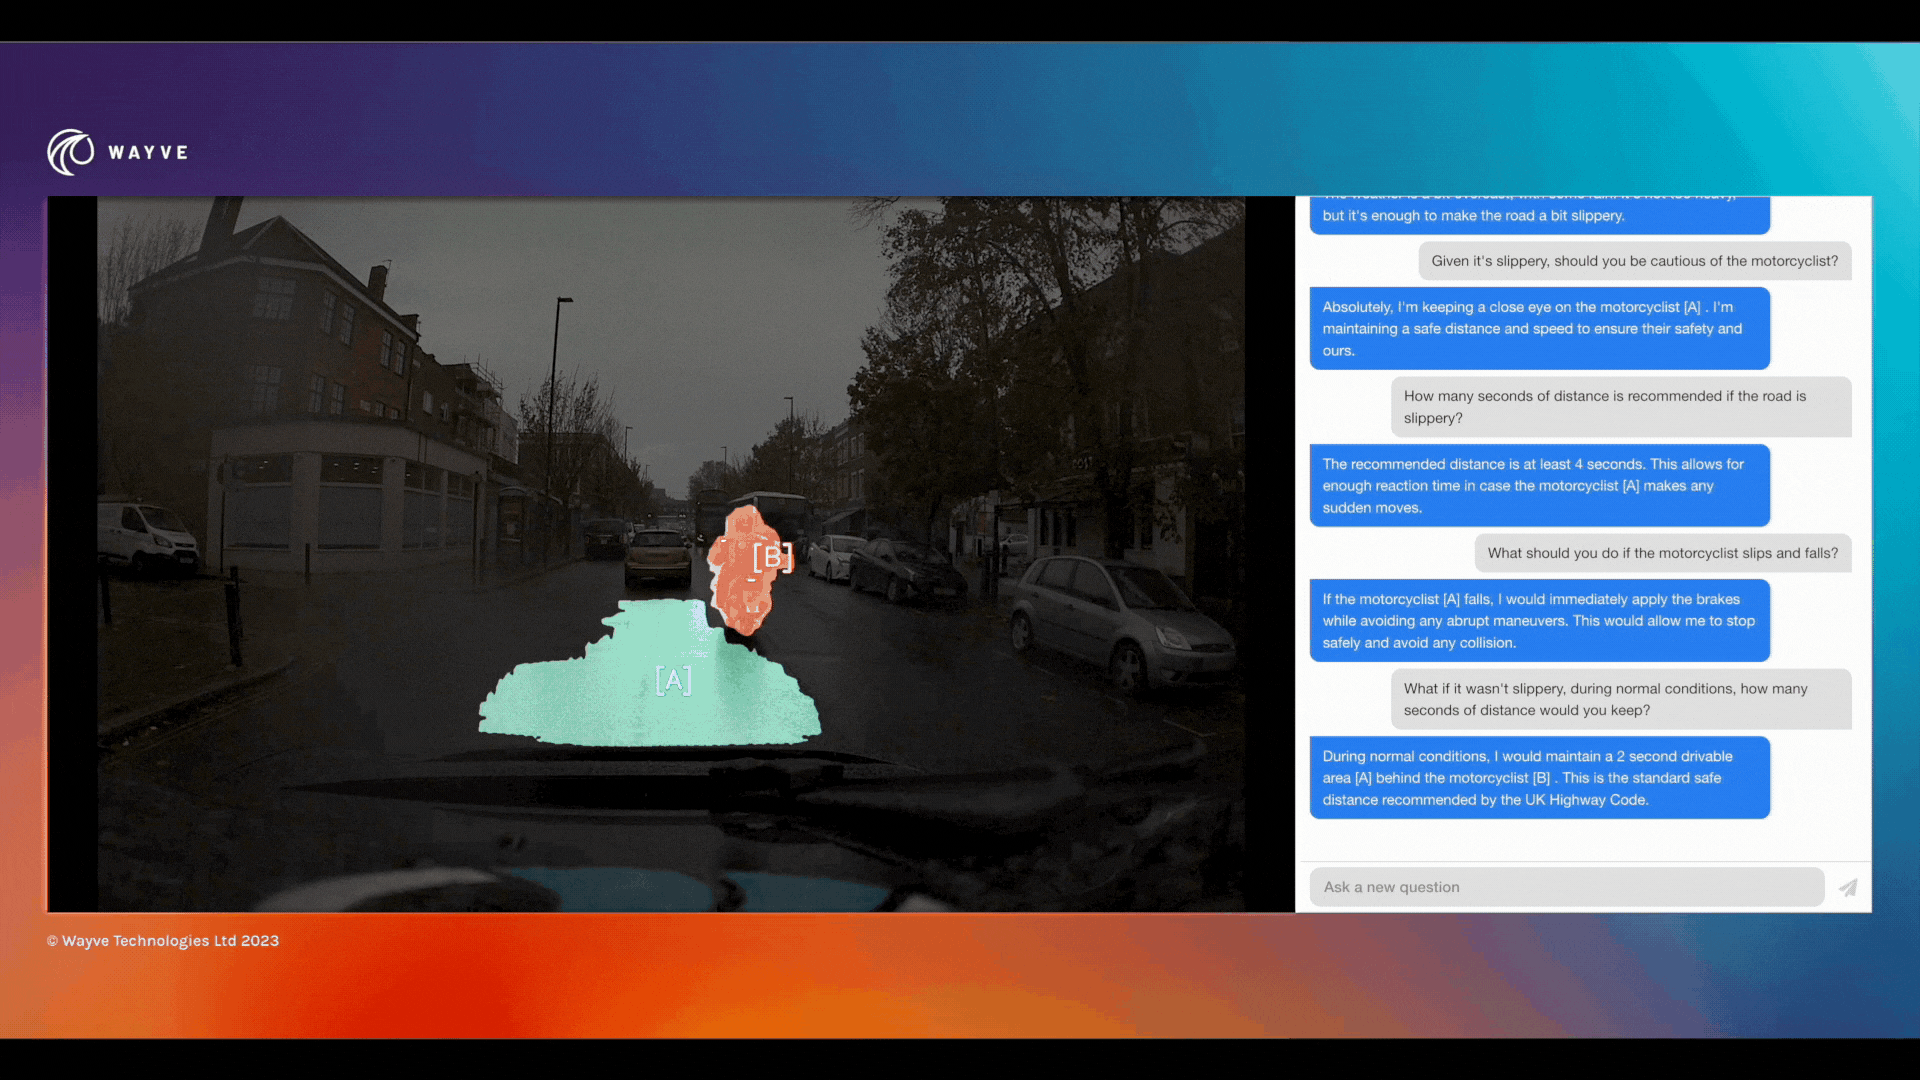
ここでは、天候に基づいた安全な停止距離についてLINGO-1が知っていることを尋ねることができます。LINGO-1は「天気は少し曇っており、雨が降っています。それほど激しくはありませんが、路面が少し滑りやすくなるには十分です」と正確に述べます。この天候を踏まえ、「路面が滑りやすい場合、何秒の車間距離が推奨されますか?」と尋ねると、LINGO-1は「推奨される距離は少なくとも4秒です。これにより、オートバイ[A]が急な動きをした場合に備えて十分な反応時間を確保できます」と答えます。また、「通常の条件下では、オートバイ[B]の後方に2秒の走行可能距離エリア[A]を維持します。これは英国の道路交通法で推奨されている標準的な安全距離です」ということも理解しています。
この例では、右折する車両を避けるためにバスレーンを走行することが推奨されるかどうかを尋ねています。LINGO-1は「はい、良い着眼点です。しかし、バスレーン[A]は実線の白線で区切られていることに注意が必要です。英国の道路交通法によれば、必要かつ安全である場合を除き、実線の白線でマークされたレーンに入ることは許可されていません。したがって、現在の車線を走り続けます」と回答します。
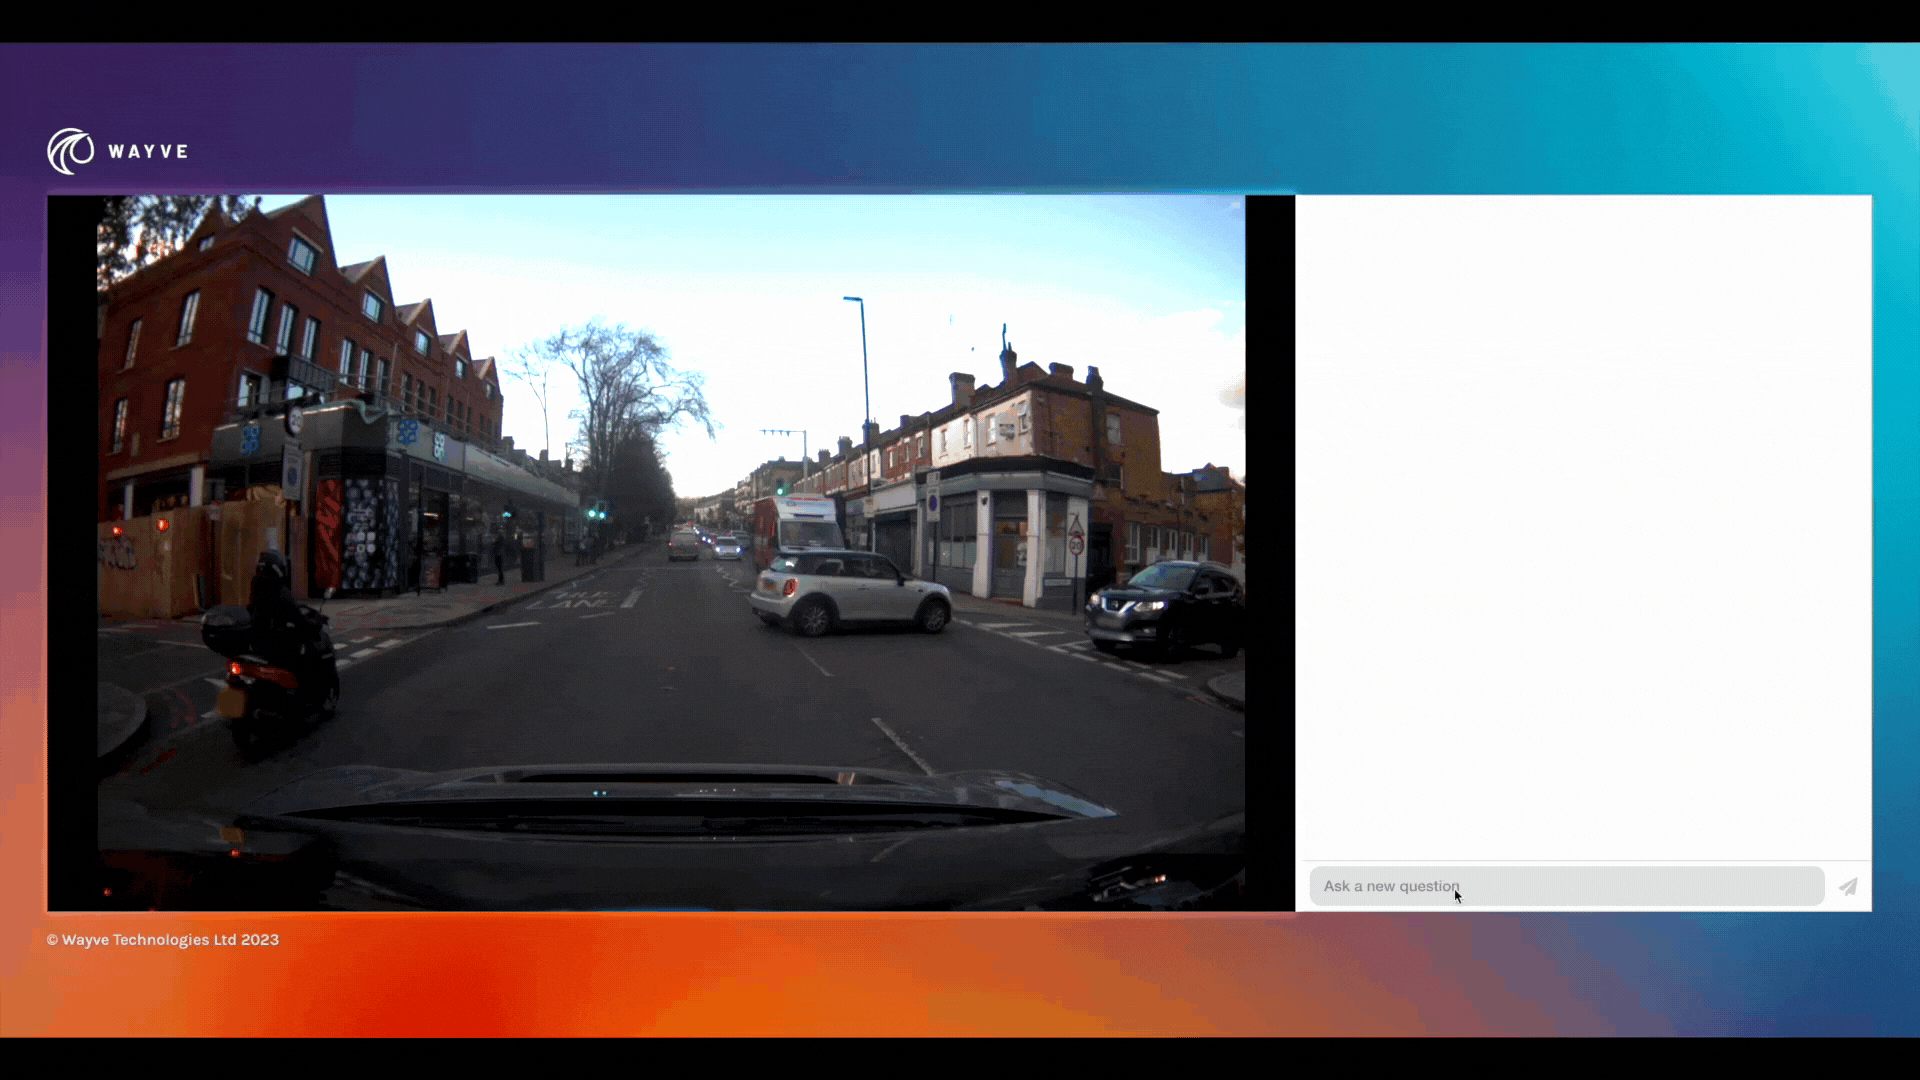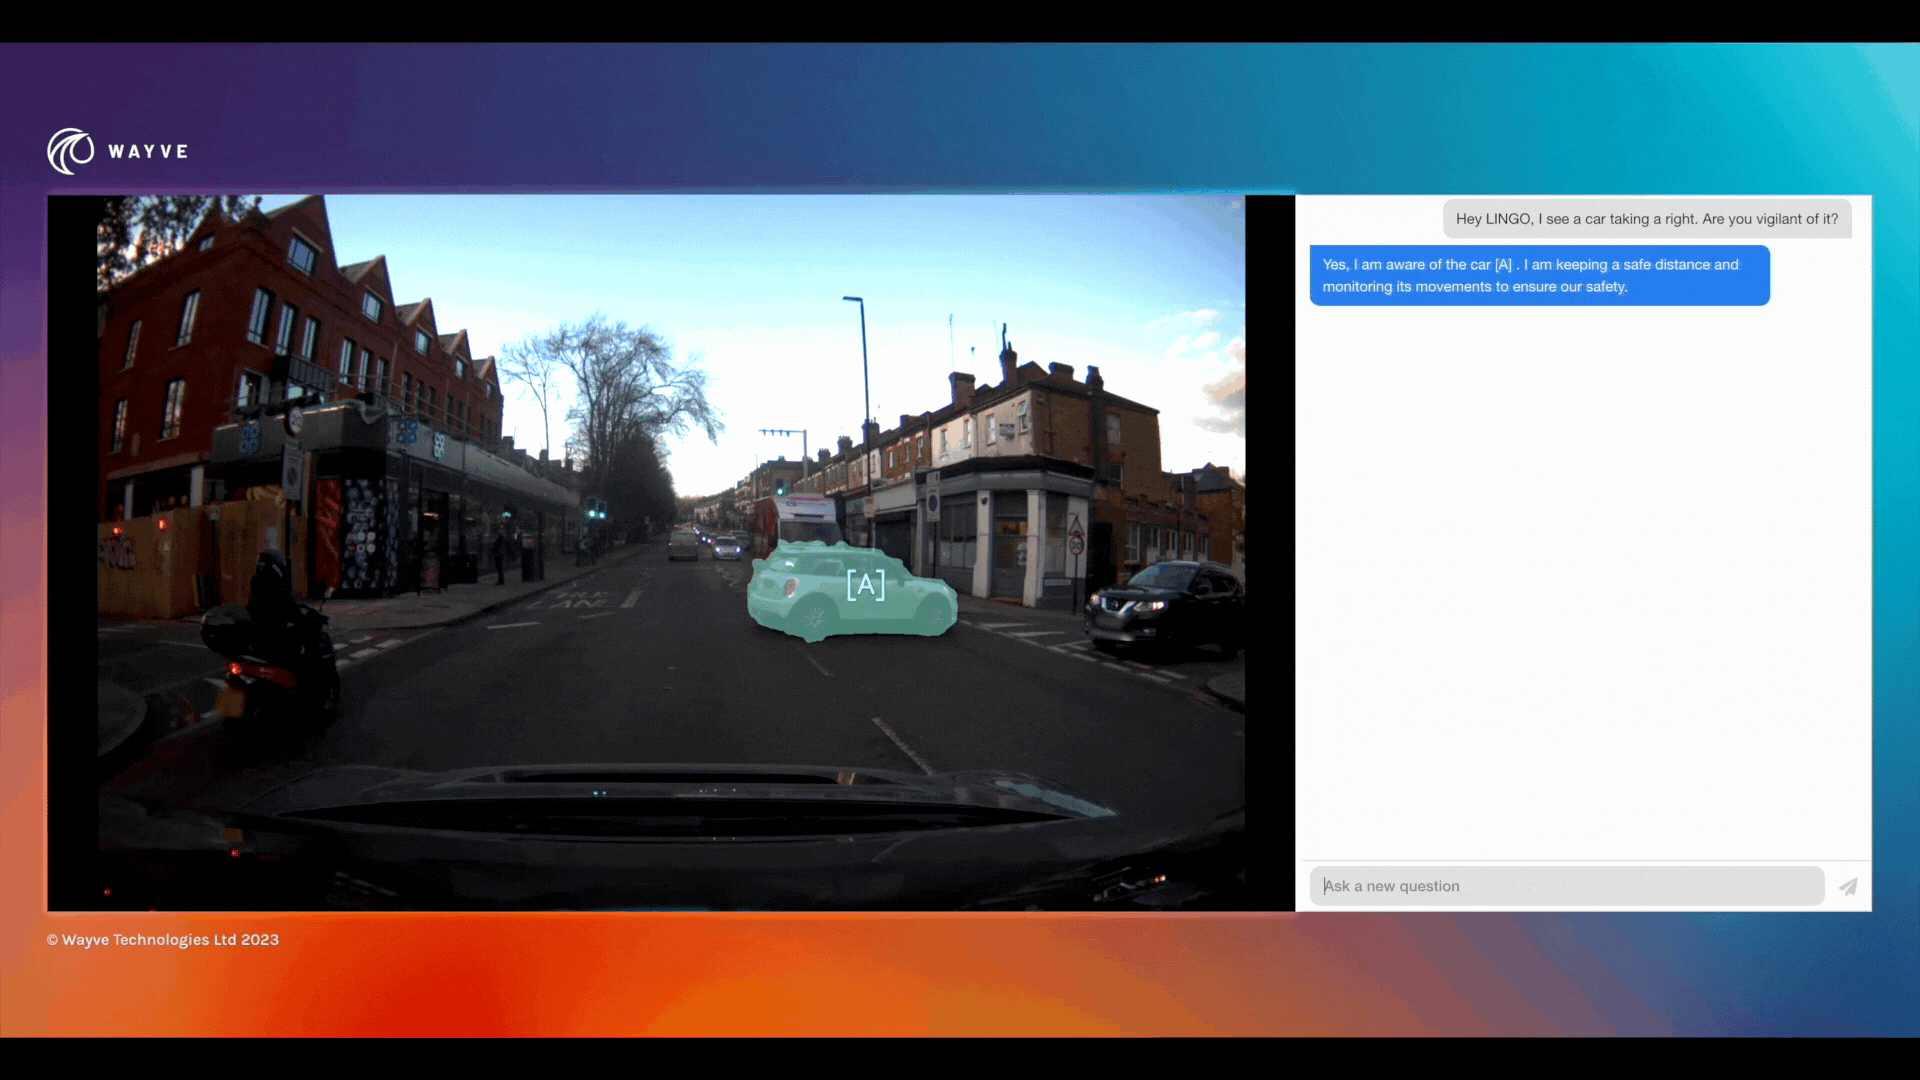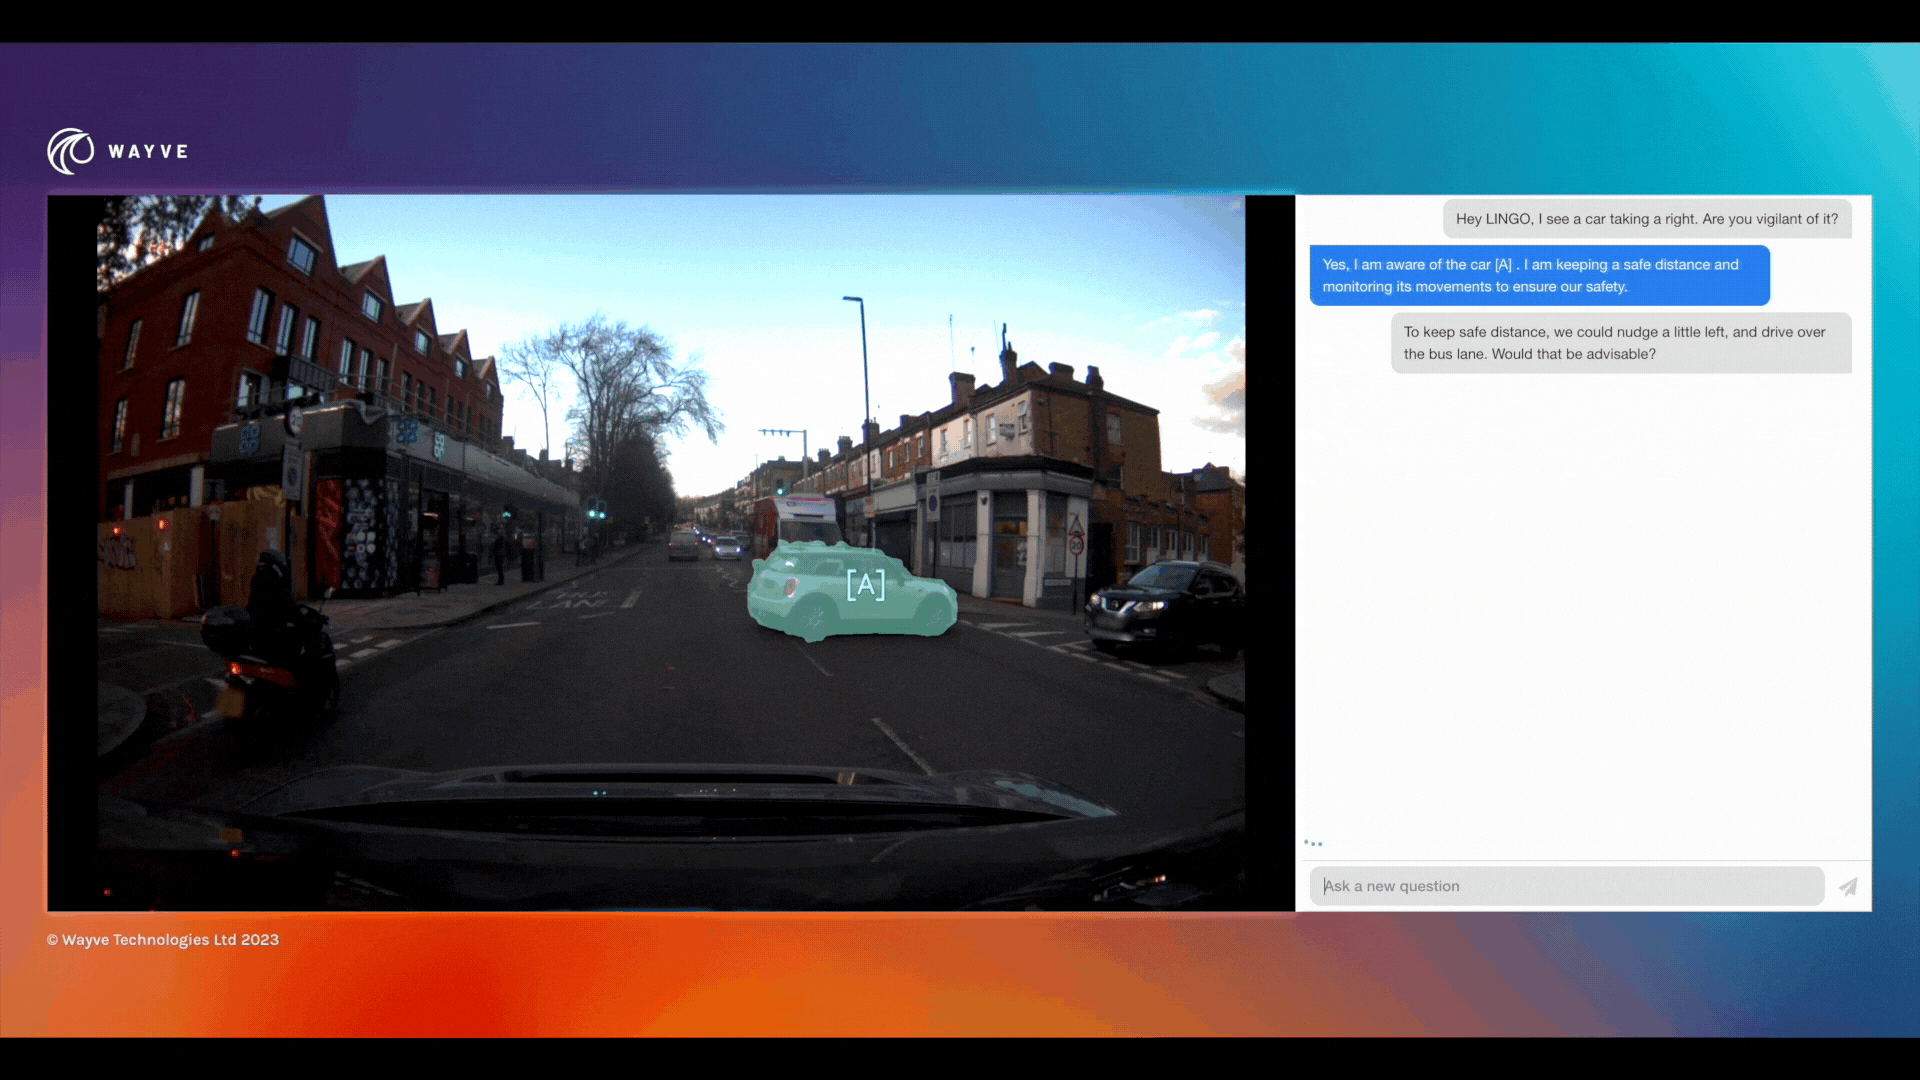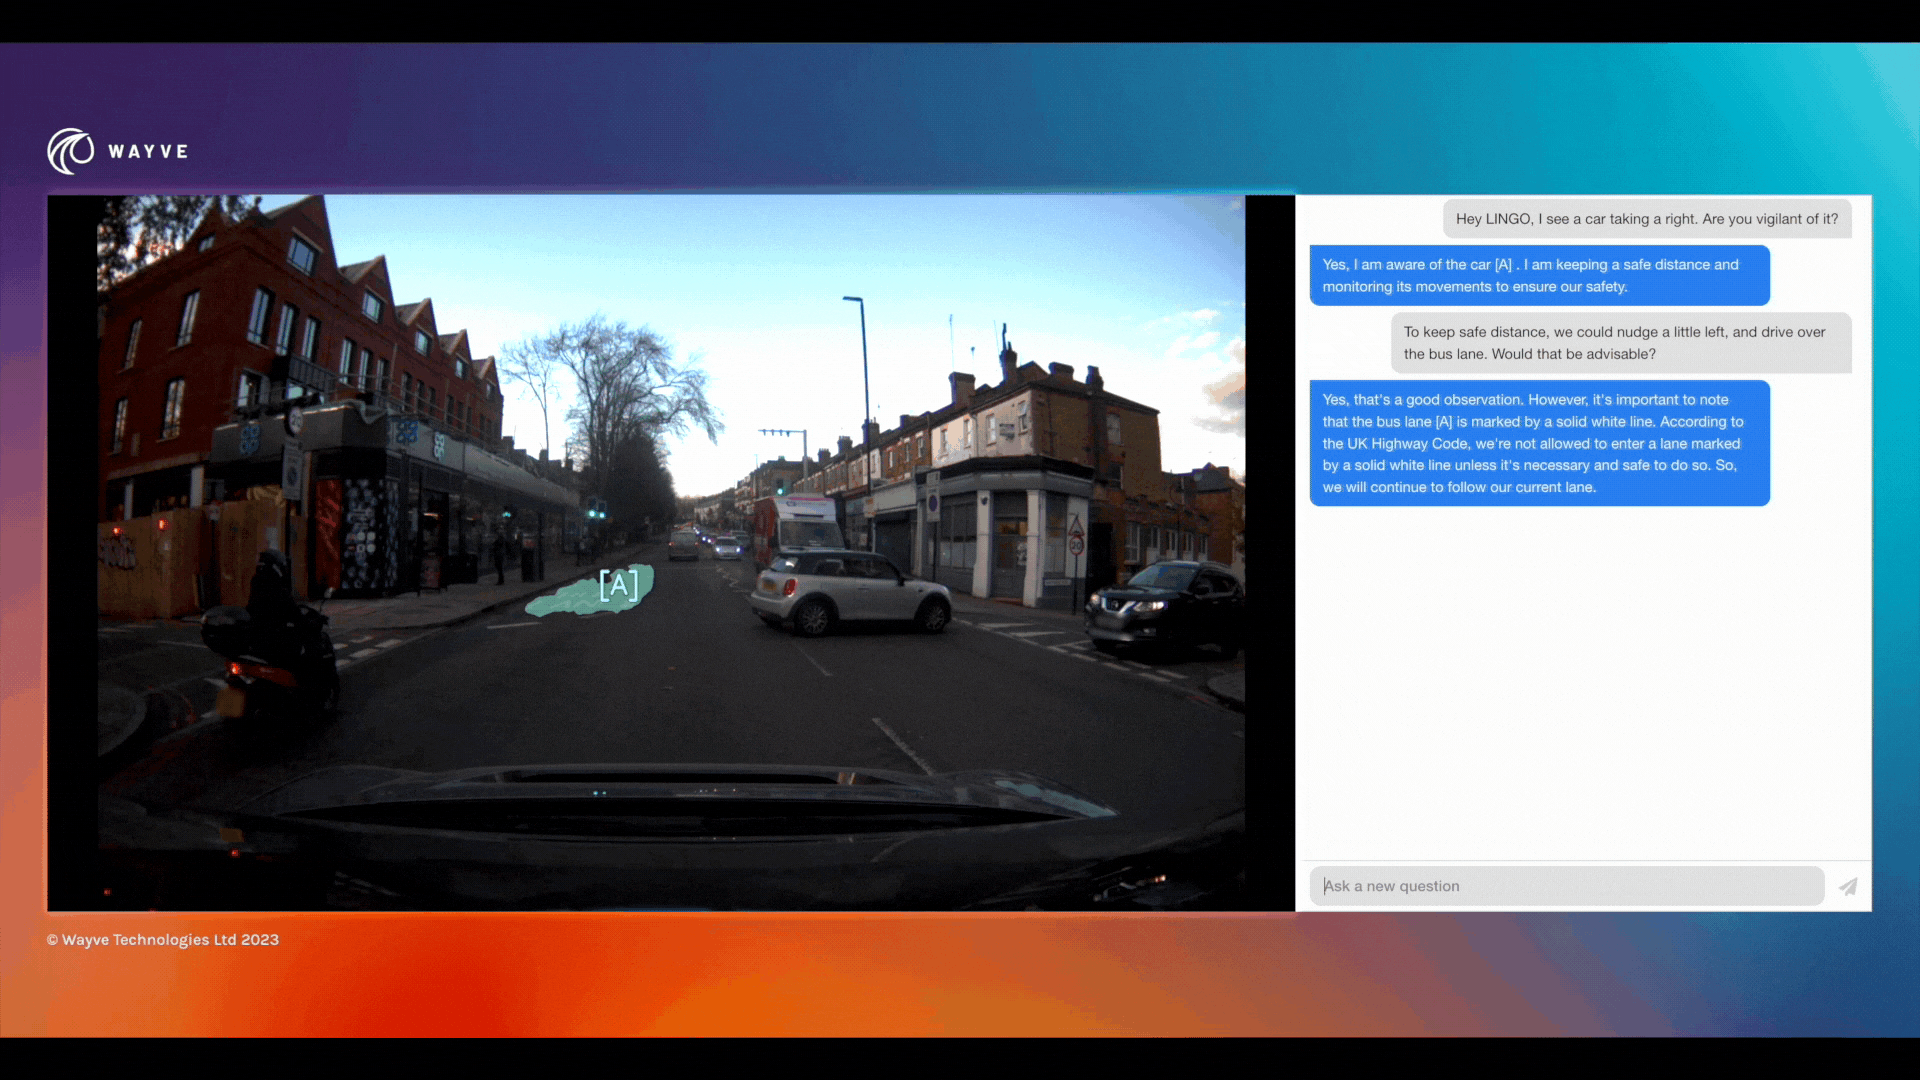
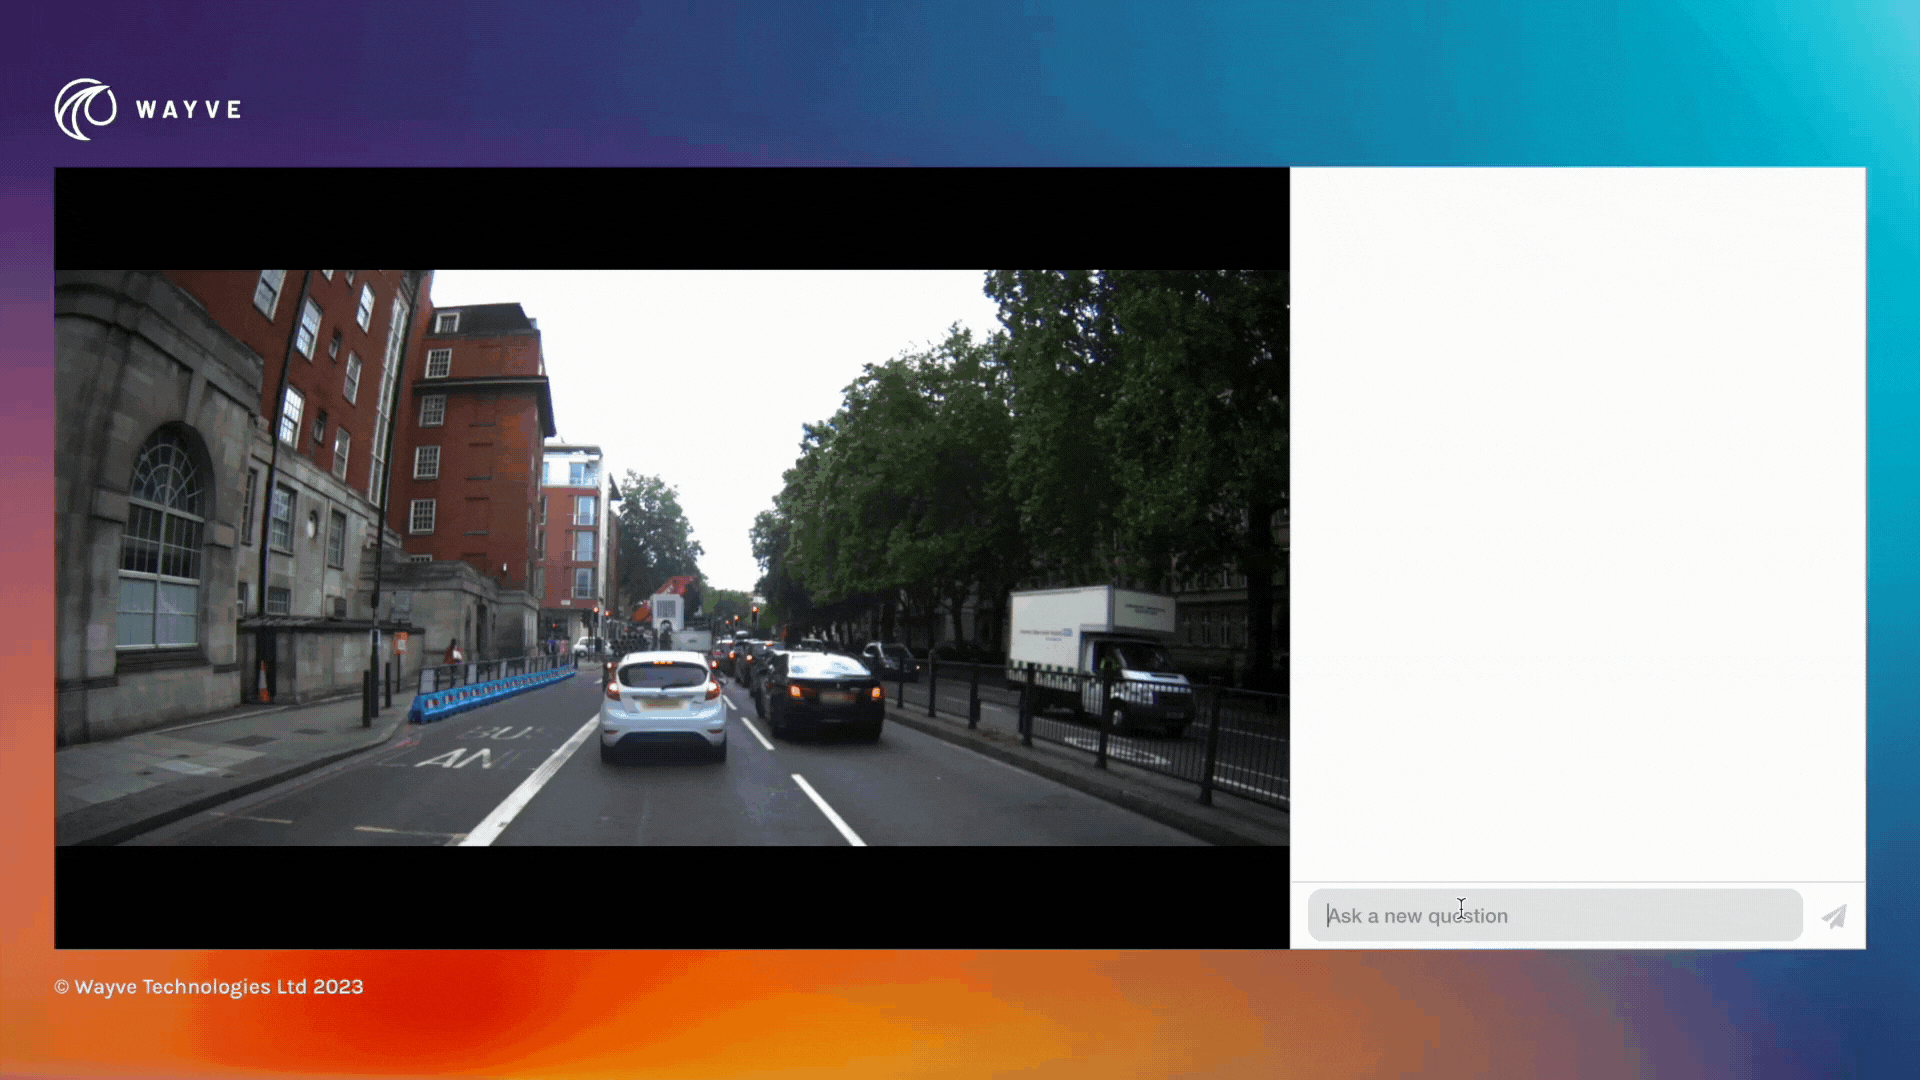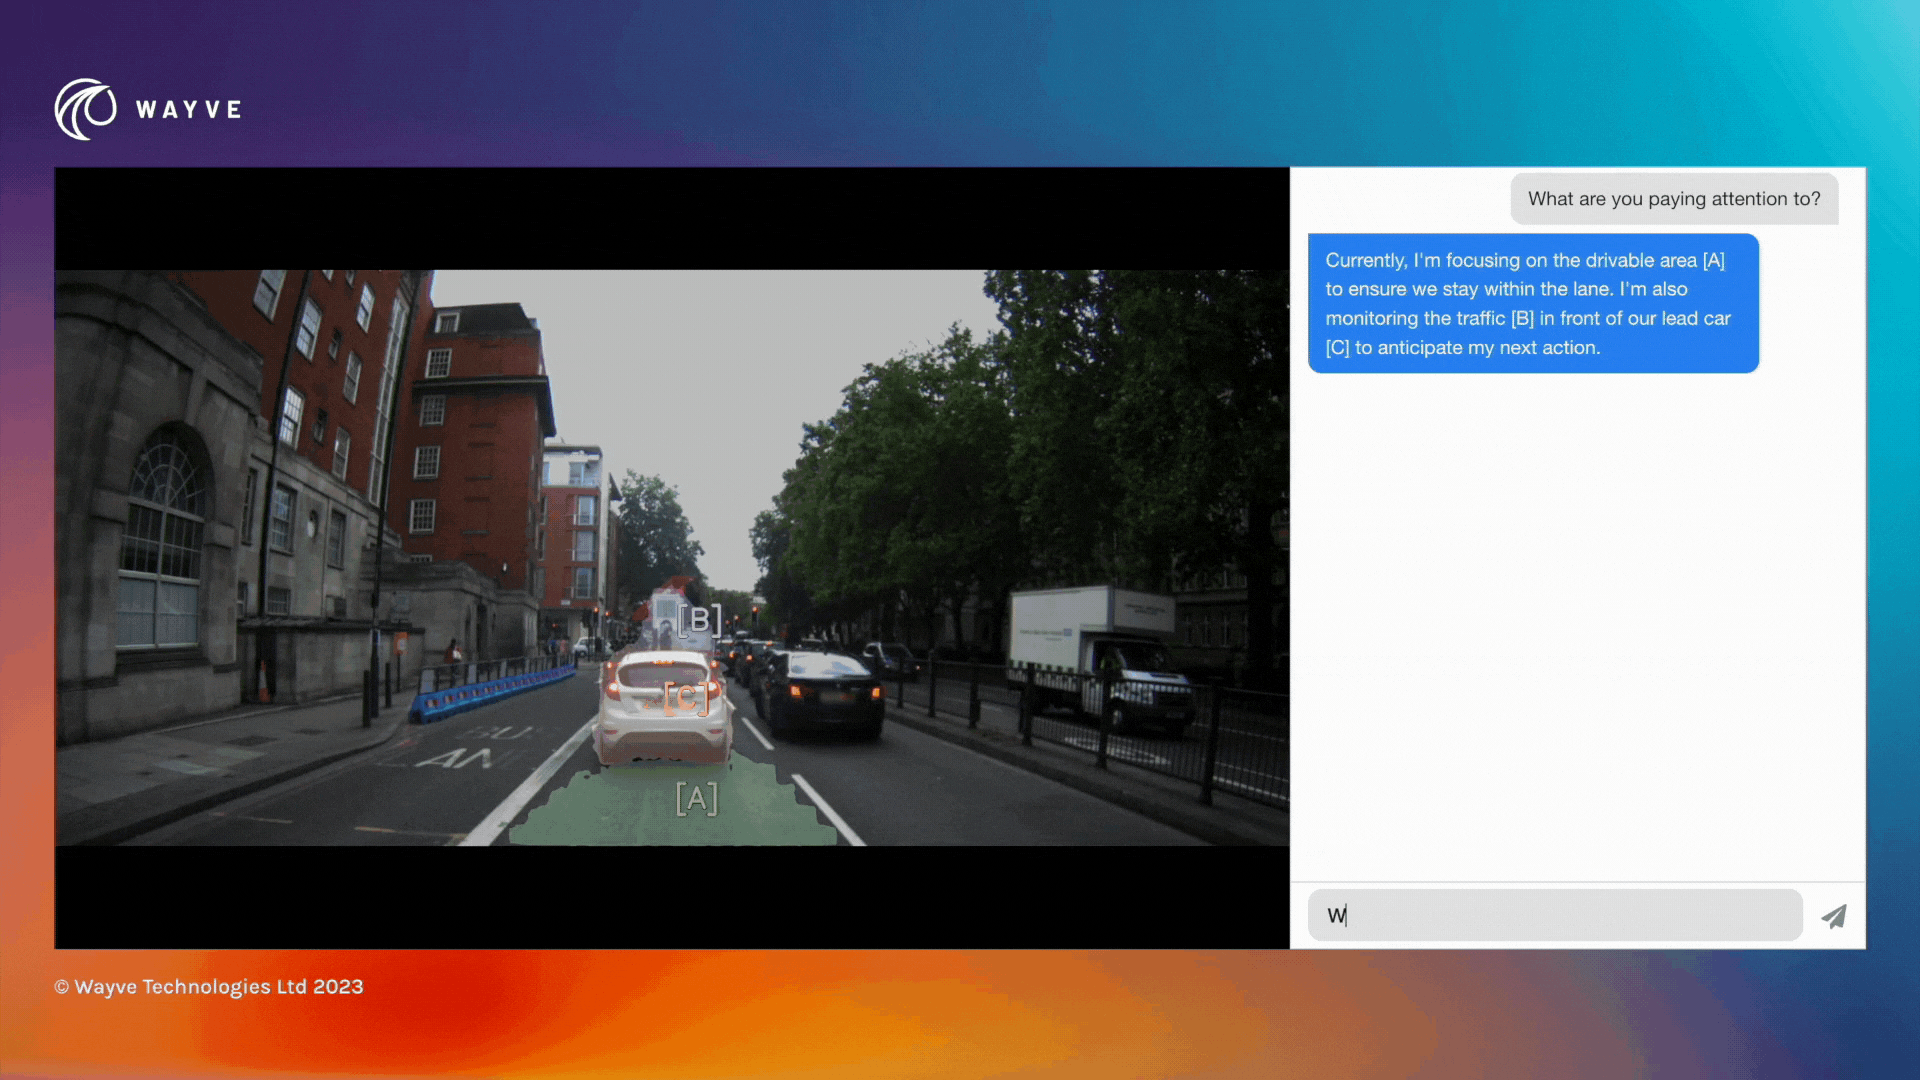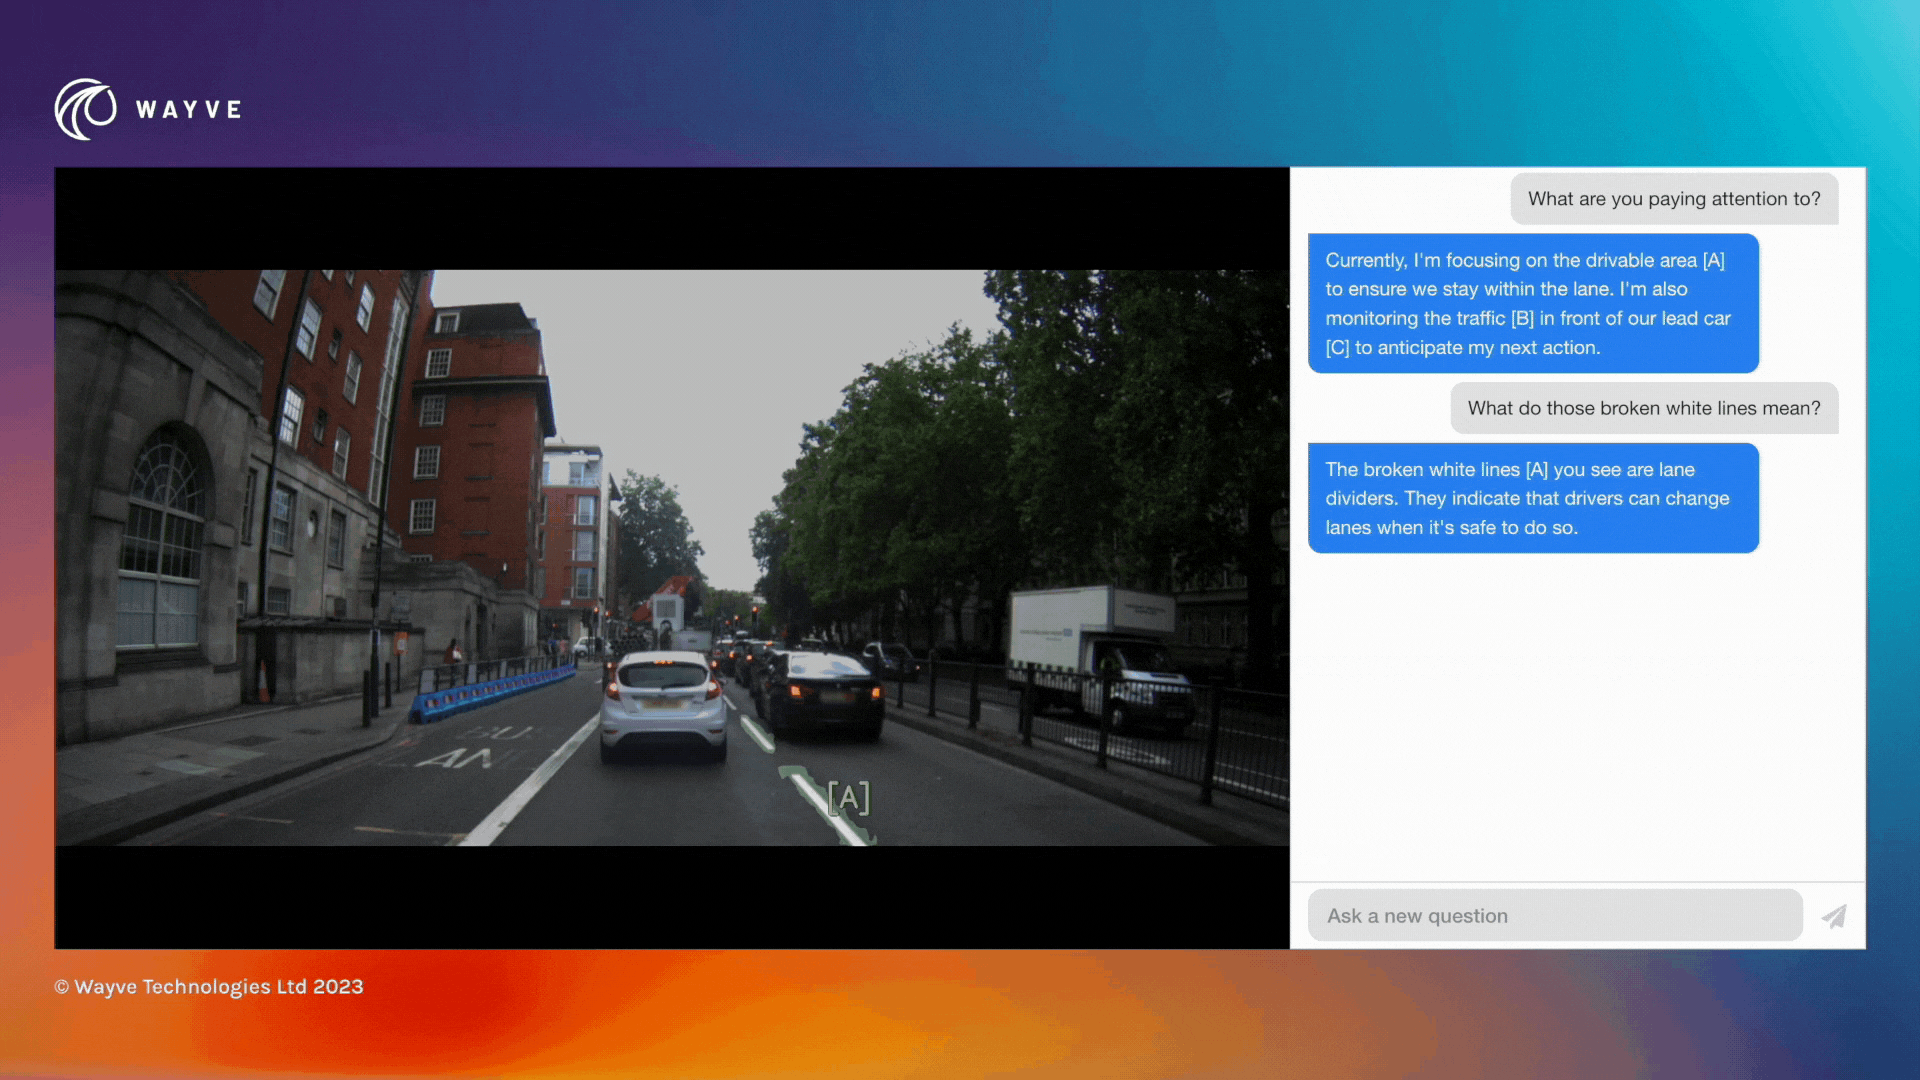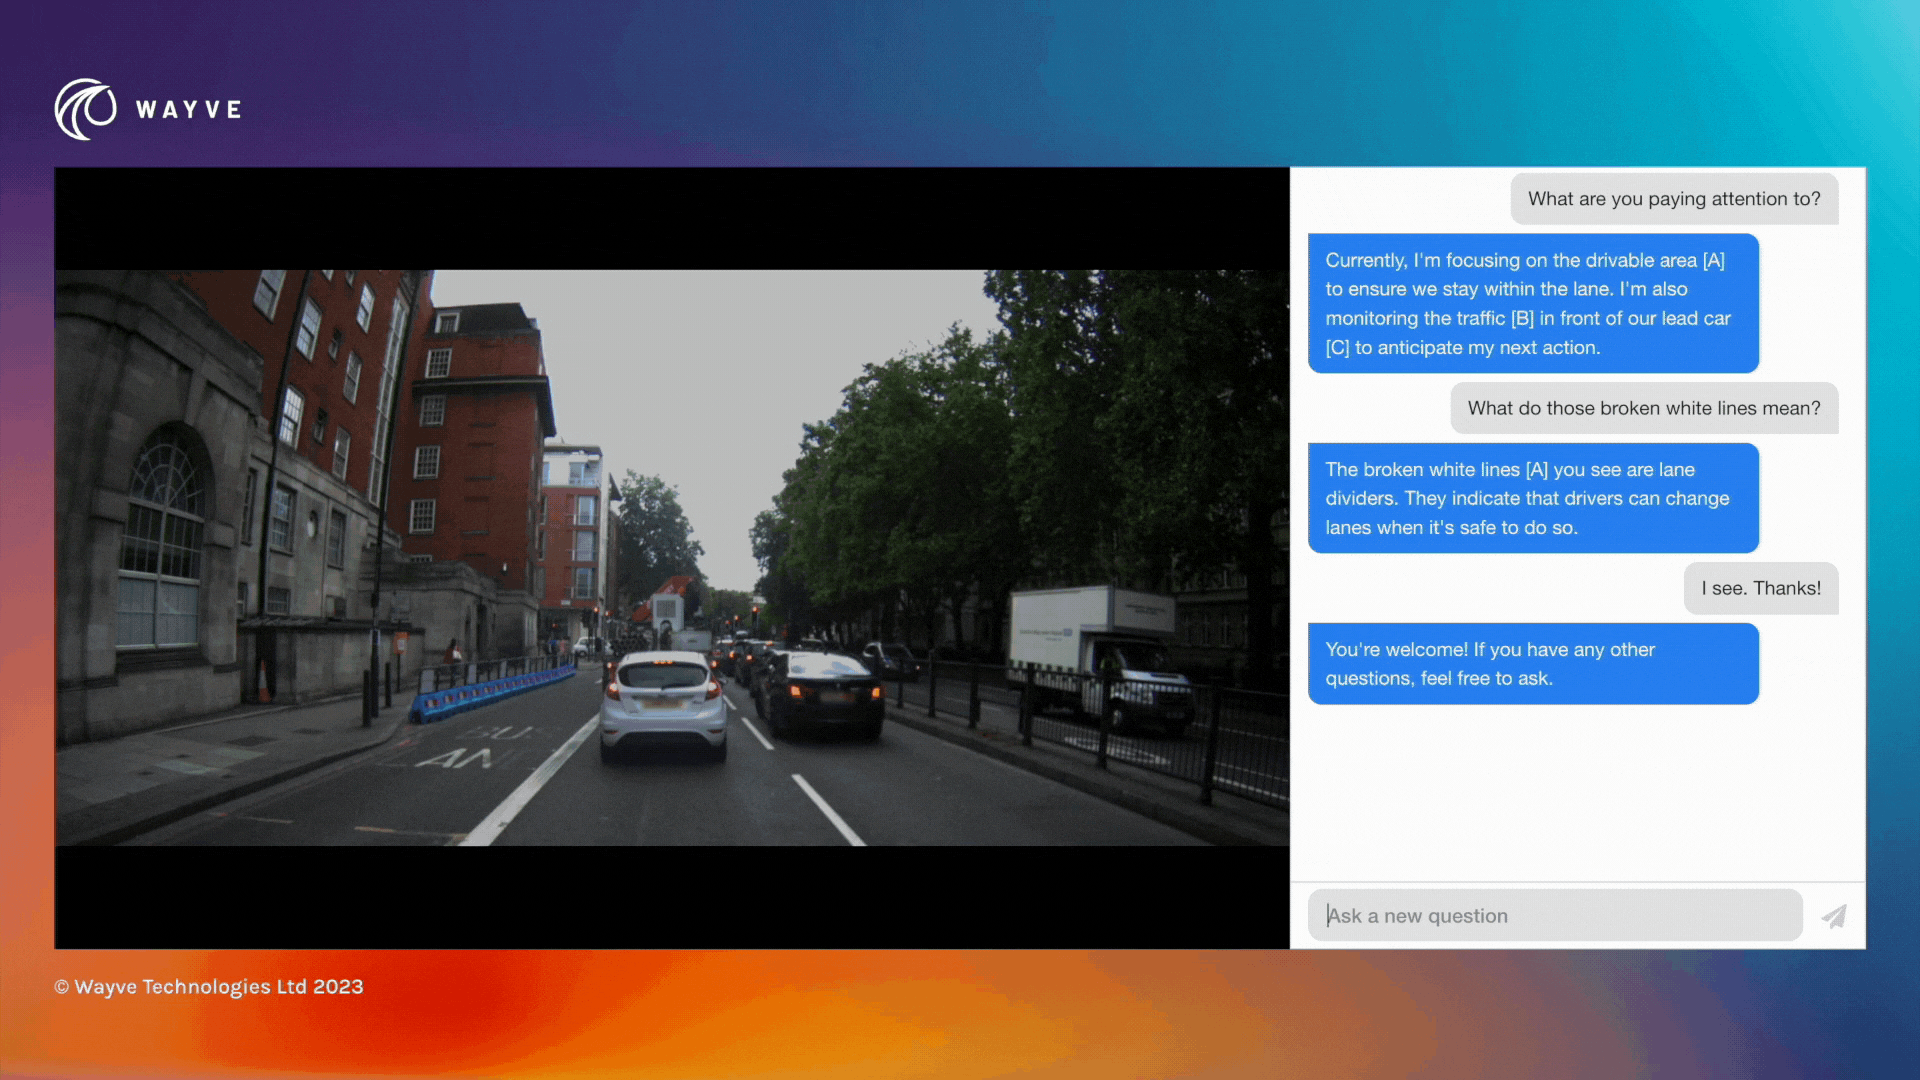
ここでは、LINGO-1が「車線内に留まるために走行可能エリア[A]に焦点を当てています。また、次の行動を予測するために、先行車[C]の前の交通状況[B]も監視しています」ということがわかります。また、破線の白線が車線分離線であり、「安全な場合にドライバーが車線を変更できることを示している」ことも正しく特定できます。
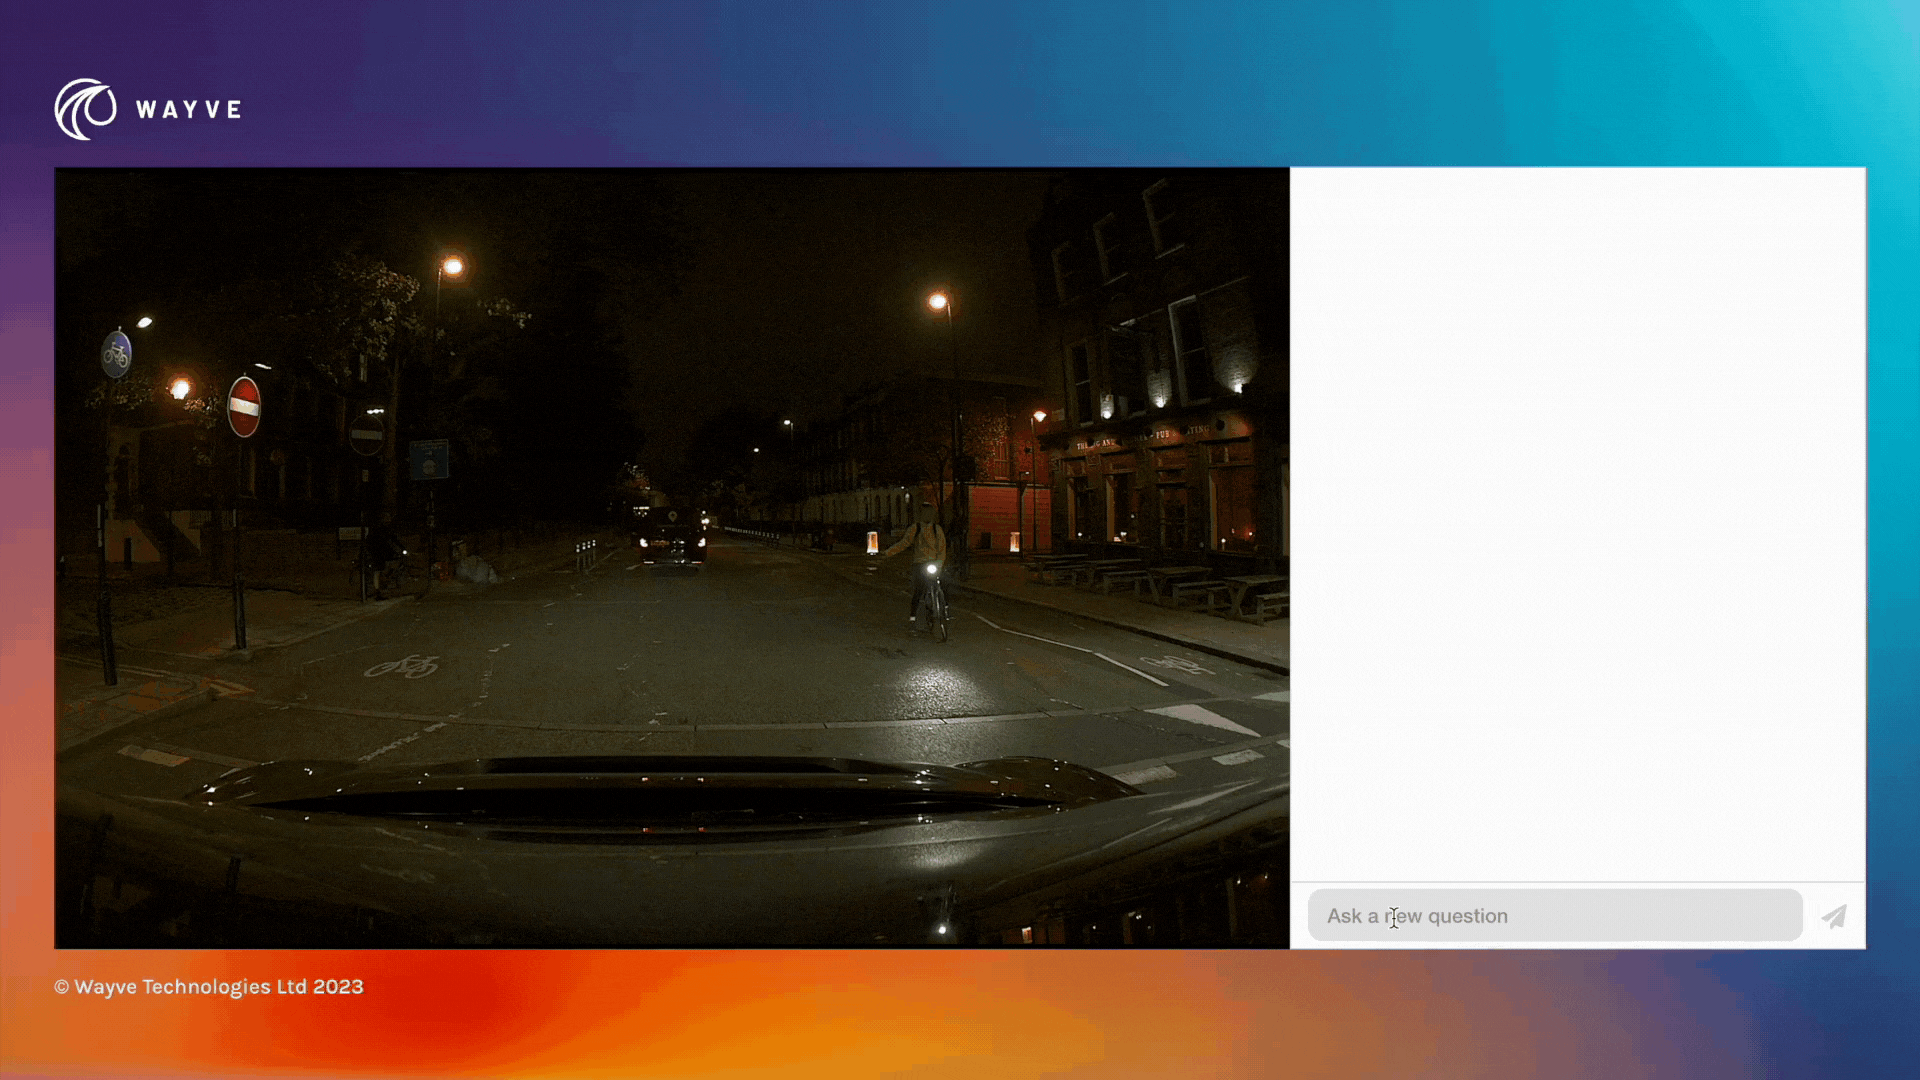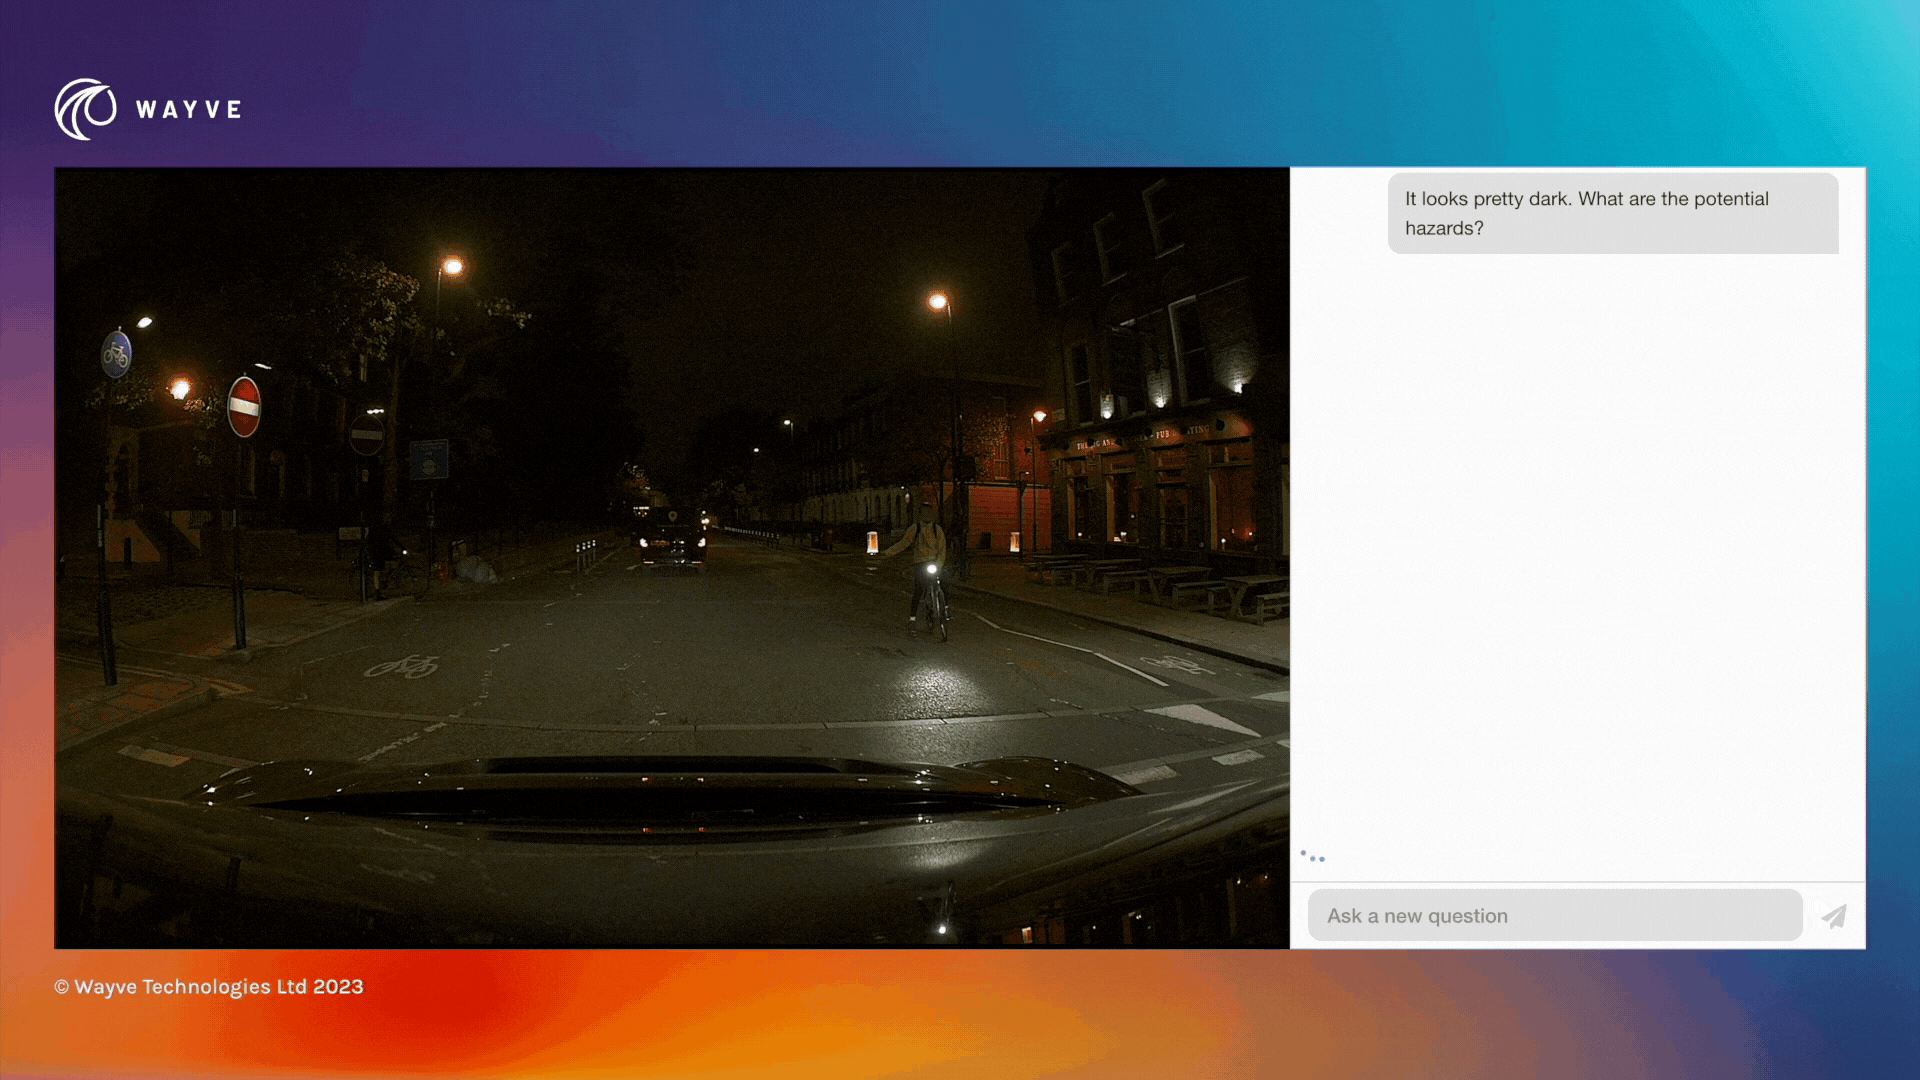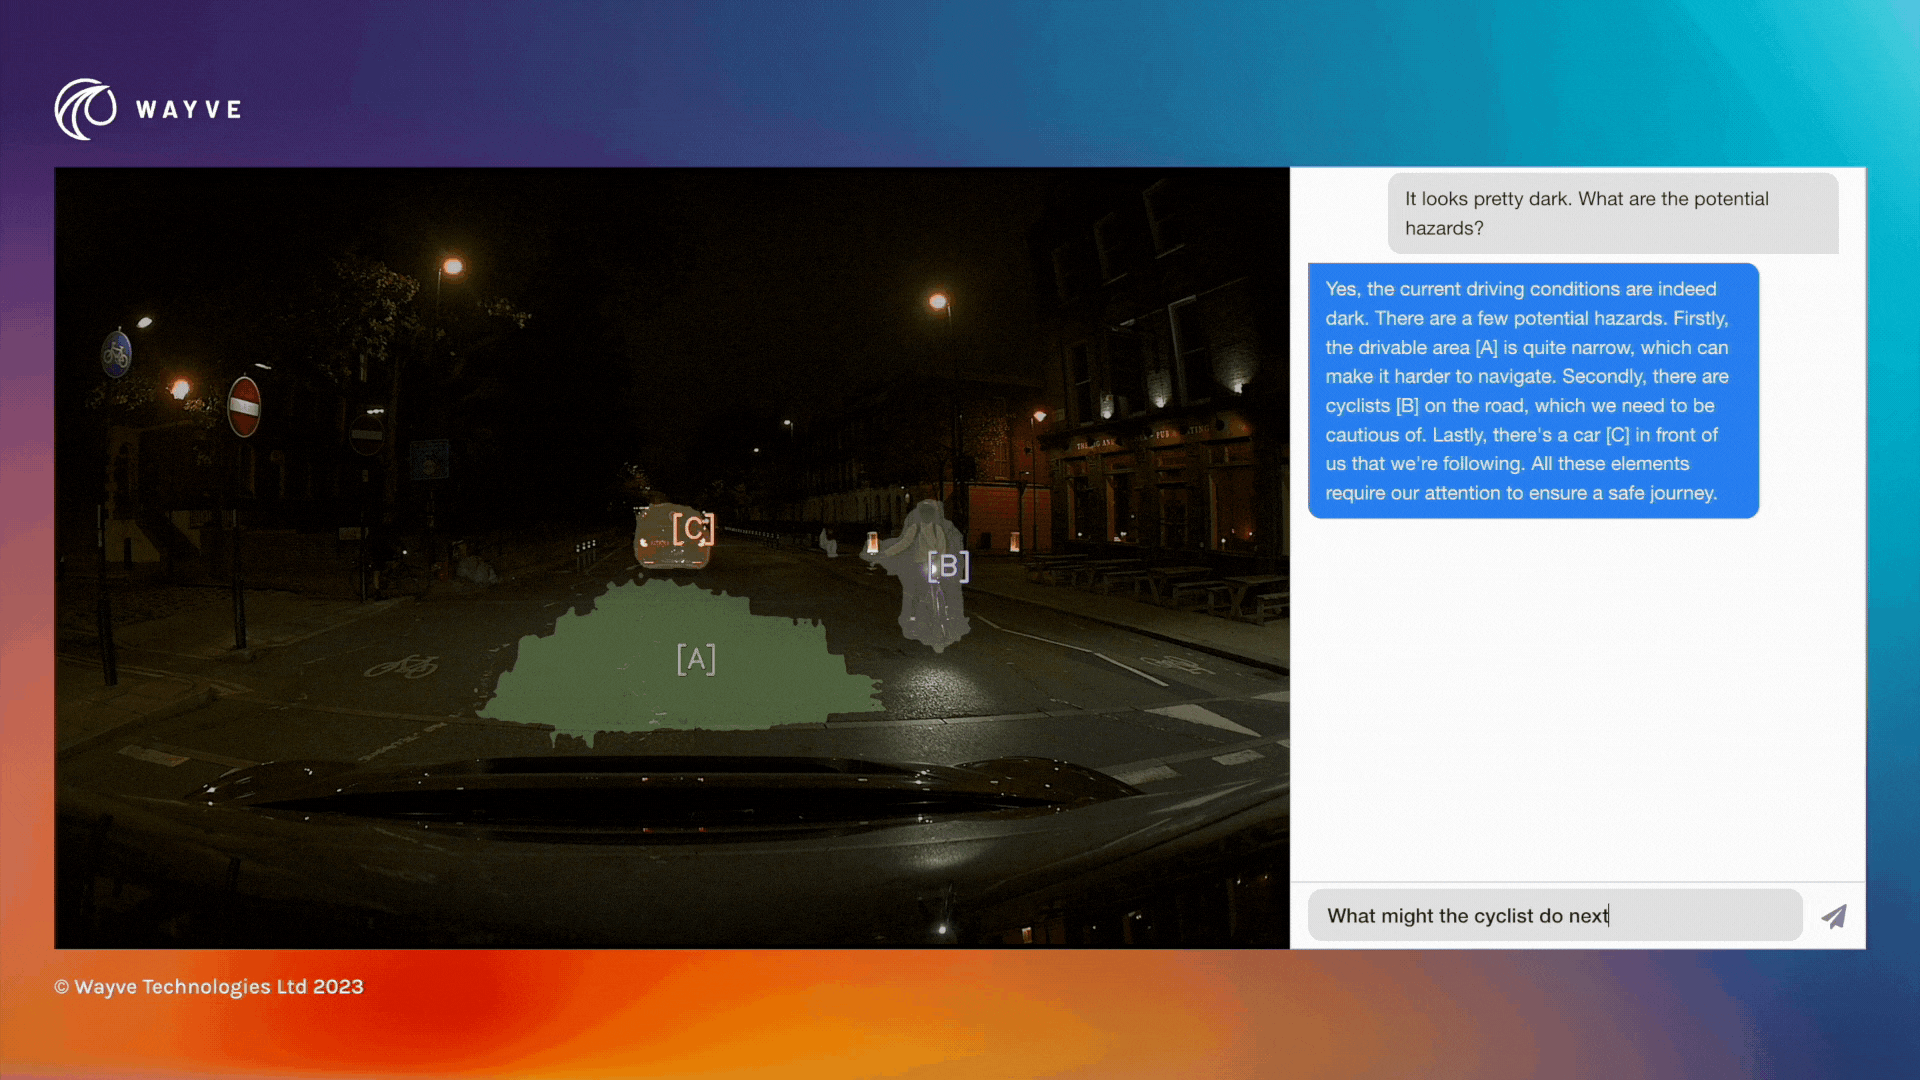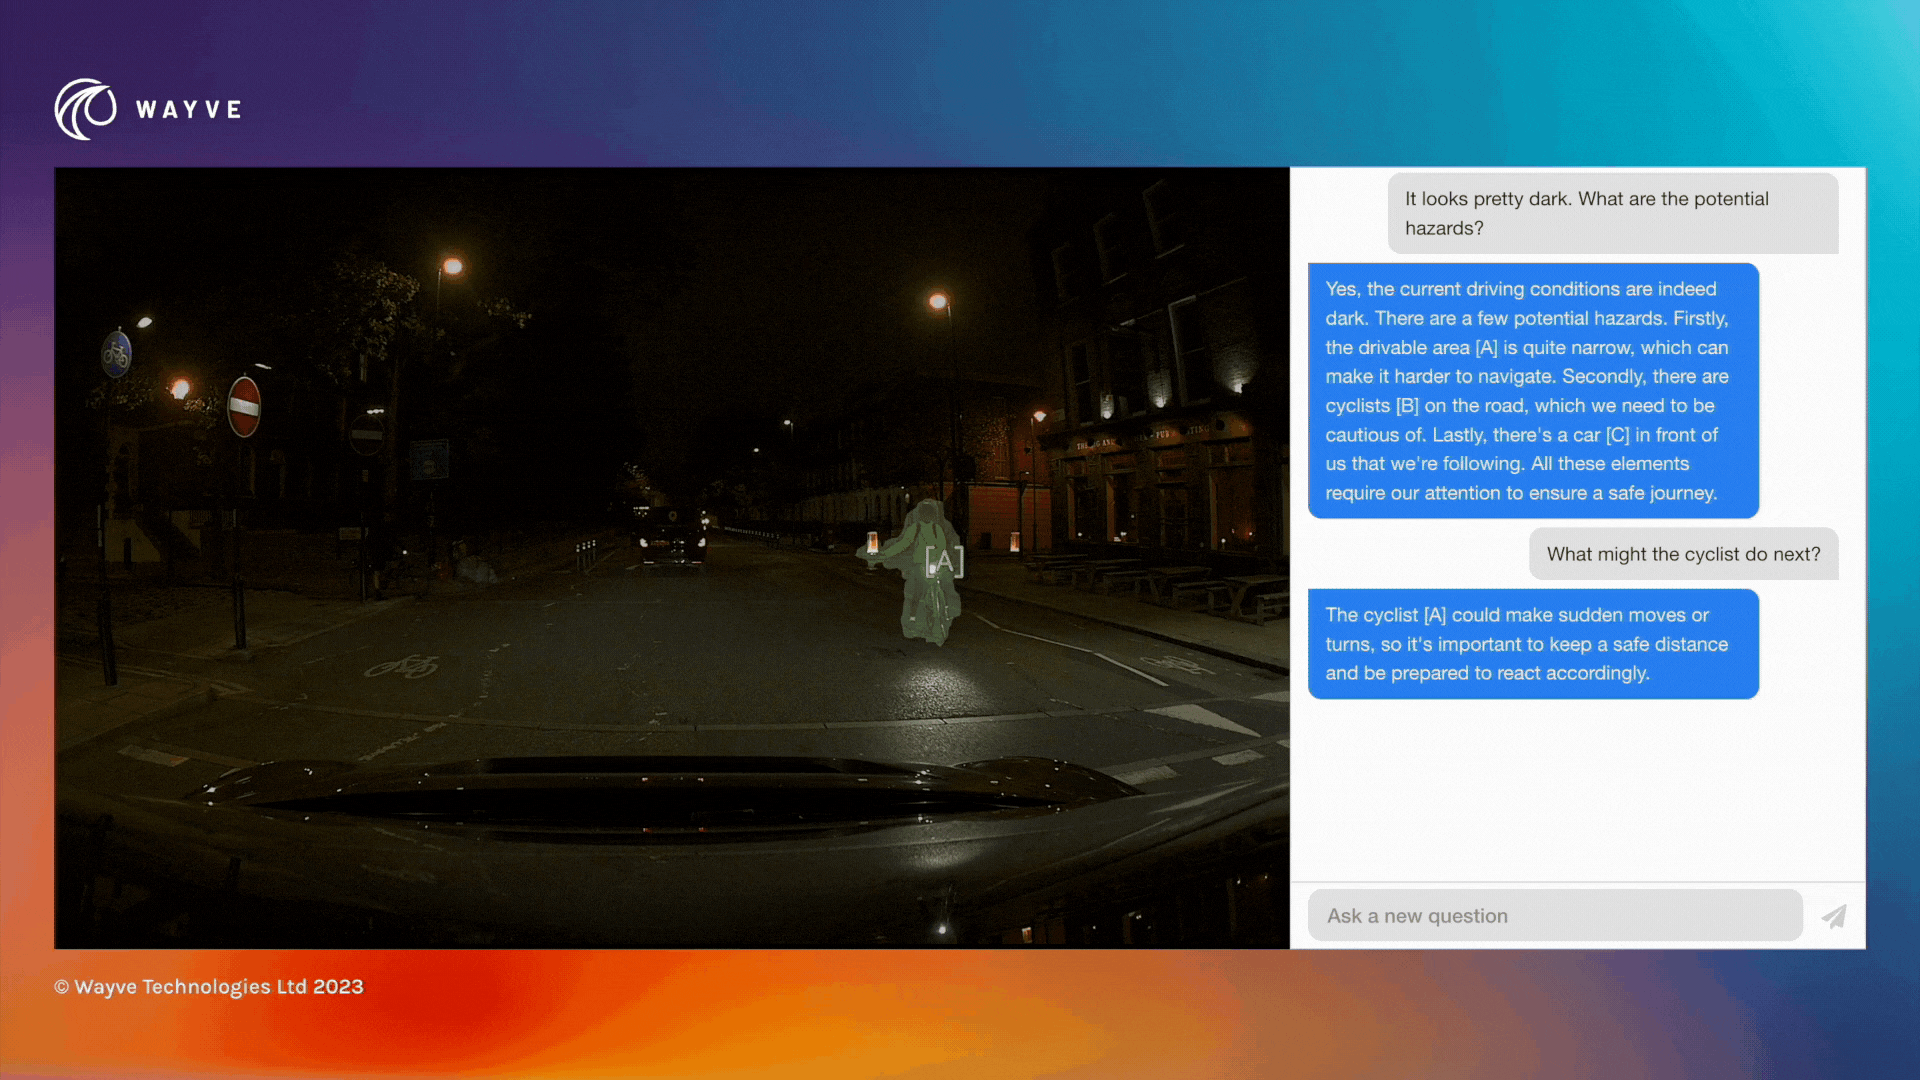
この最後の例は、LINGO-1が夜間の運転中に潜在的な危険についてどのように推論するかを示しています。モデルがまず、このシナリオが暗闇での運転であることを確認し、以下の潜在的な危険に対して注意が必要であることを認識しているのがわかります:[A] 狭い走行可能エリア、[B] 道路上のサイクリスト、[C] この画像では特定が困難な前方の車両の存在。また、「サイクリストは急な動きや方向転換をする可能性があるため、安全な距離を保ち、適切に反応できるように準備しておくことが重要です」ということも正しく認識しています。
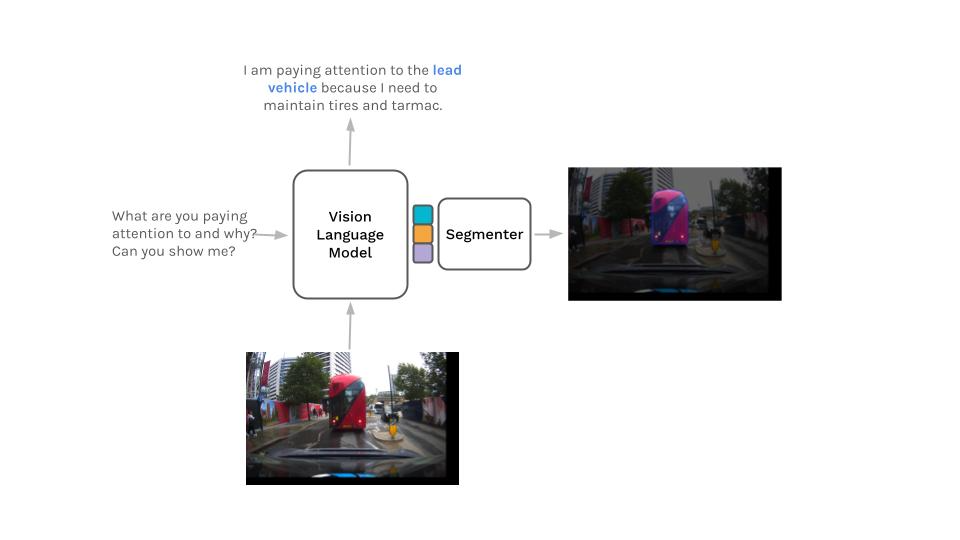
LINGO-1 Show & Tell アーキテクチャ
この新しい機能を開発するために、当社はLINGO-1のアーキテクチャを拡張し、自動運転(AV)ドメインに特化したデータセットを使用してトレーニングを行いました。これらのデータセットにより、モデルにマルチタスク能力が備わりました。つまり、テキストで応答しながら、同時にリファレンシャル・セグメンテーションを実行できるのです。重要な点として、トレーニングと検証のために、このようなマルチモーダル・データセットを収集・キュレーションするための効率的なプロトコルを開発しました。
この新機能で運転を前進させる
「show and tell」の導入は、自動運転と人間と車両のインタラクションに新たな可能性をもたらします。以下にいくつかの潜在的なユースケースを挙げます。
- トレーニングと適応性の強化:言語と視覚をリンクさせることで、これらのモデルにより効率的な監視とシーンに関するより多くの情報を提供し、学習プロセスを加速させることができます。この学習能力は、例が限られている運転中のロングテール・シナリオに対処するために不可欠です。
- LLMにおけるハルシネーションへの対処:ハルシネーション(幻覚)は大規模言語モデルにおけるよく知られた問題であり、LINGO-1も例外ではありません。言語を視覚でグラウンディングする機能を開発することで、モデルがシーン内で正確に特定できるオブジェクトに対してのみ応答するように強制する追加の監視ソースを導入し、ハルシネーションのリスクを軽減できます。
- 安全コミュニケーションの向上:シーン内の潜在的な危険を視覚的に強調することで、LINGO-1は歩行者、サイクリスト、障害物の位置などの重要な情報を効果的に伝えることができます。これは、当社のAV技術の能力に対する信頼と自信を築く上で重要な役割を果たします。
Vision-Language-Xモデルで自動運転の未来を切り拓く
LINGO-1の「show and tell」機能の組み込みは、自動運転車の性能を向上させるために自然言語を使用する上での新たな進歩を意味します。この革新的な機能は、Vision-Language-Xモデル(VLXM)の開発に向けた重要なステップです。ここで「X」は、言語、リファレンシャル・セグメンテーション、走行計画、生の制御信号など、多様なマルチモーダル出力を網羅しています。
これらの要素を統合することで、Wayveは自動運転車が周囲をどのように認識し解釈するかだけでなく、その理解をどのように伝えるかについても強化しており、より人間に近い運転アプローチを実現しています。その結果、Wayveは、自動運転車が乗客、歩行者、その他の道路利用者に意図や行動を明確かつ効果的に伝えることができる未来の舞台を整えており、最終的により安全で信頼性の高い自動運転システムの開発に貢献しています。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む