








25 6月 2018 | リサーチ
わずか1日で運転を学習する
自動運転車に搭載された深層強化学習の初事例
子供の頃、自転車の乗り方を練習した時のことを覚えていますか?期待と少しの不安を抱きながら、初めてサドルに座り、大人がバランスを崩した時に支えてくれるよう見守る中でペダルを漕いだことでしょう。何度かふらついた後、数メートルほどバランスを保てるようになったかもしれません。そして数時間後には、砂利道でも芝生の上でも、公園中を軽快に走り回っていたはずです。
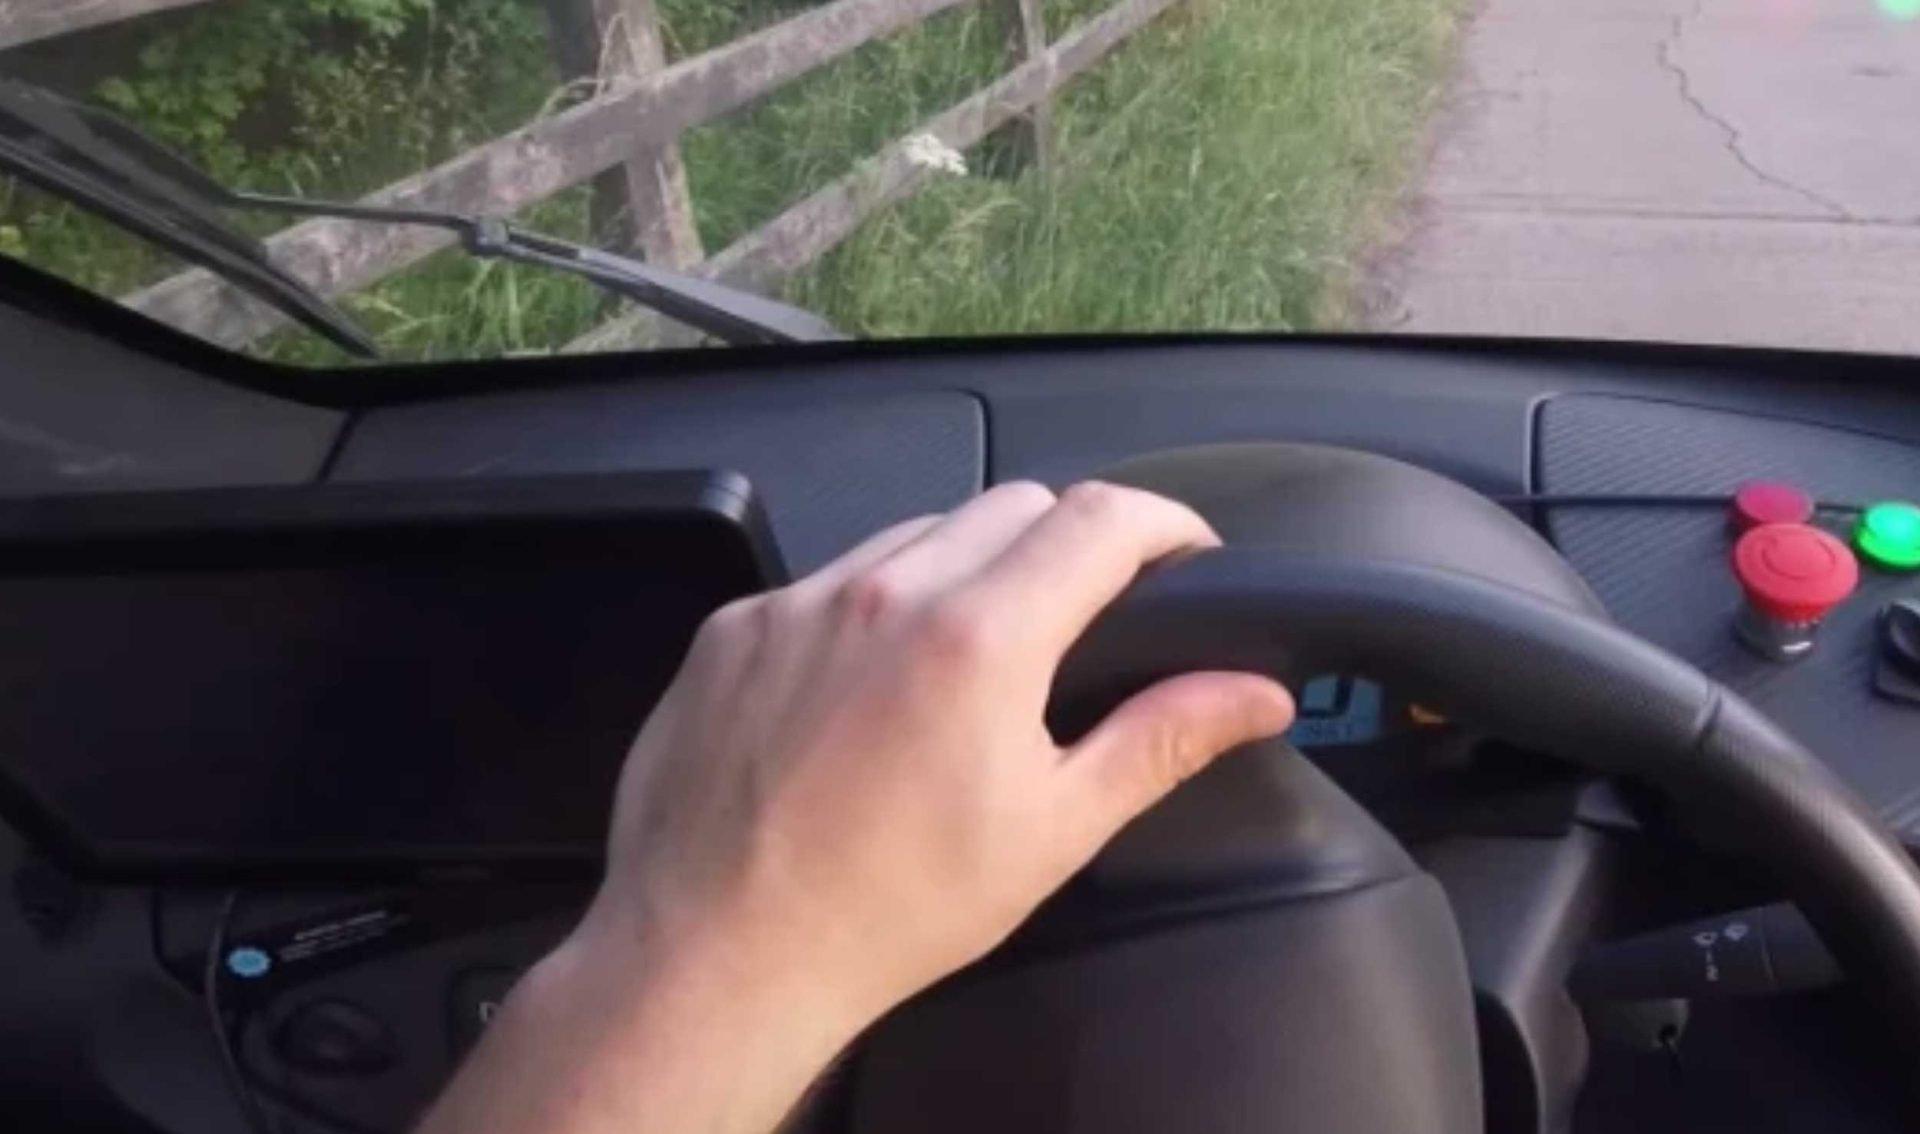
大人はその間、簡単なコツを教えてくれただけでした。公園の詳細な3Dマップも、頭に取り付けた高精度なレーザーも必要ありませんでした。自転車でバランスを取るために、守るべき長いルールのリストも不要でした。大人はただ、あなたが見ているものを「どうすべきか」に結びつける方法を学習し、自転車を乗りこなせるようになるための安全な環境を与えてくれたのです。
今日の自動運転車には大量のセンサーが搭載されており、時間のかかる開発サイクルを経て、手作業で設計された膨大なルールのリストによって運転方法が指示されています。このブログ記事では基本に立ち返り、あなたが自転車の乗り方を学んだ時のように、賢い試行錯誤を通じて、車がゼロから車線追従を学習する様子をご紹介します。私たちの取り組みをぜひご覧ください。
わずか15〜20分で、セーフティドライバーによる介入をトレーニングのフィードバックとして利用するだけで、車にゼロから車線追従を教えることができました。
詳細な3Dマップも、手書きのルールも不要
これは、自動運転車がオンラインで学習し、試行を重ねるごとに上達した初めての事例です。では、どのようにして実現したのでしょうか?
私たちは、一般的なモデルフリーの深層強化学習アルゴリズム(深層決定論的方策勾配法、DDPG)を車線追従タスク用に適応させました。モデルの入力は単眼カメラの画像1枚です。システムは、探索、最適化、評価の3つのプロセスを繰り返しました。
ネットワーク構成は、4つの畳み込み層と3つの全結合層からなる深層ネットワークで、パラメータ数は合計で1万弱です。比較として、最先端の画像分類アーキテクチャは数千万のパラメータを持っています。
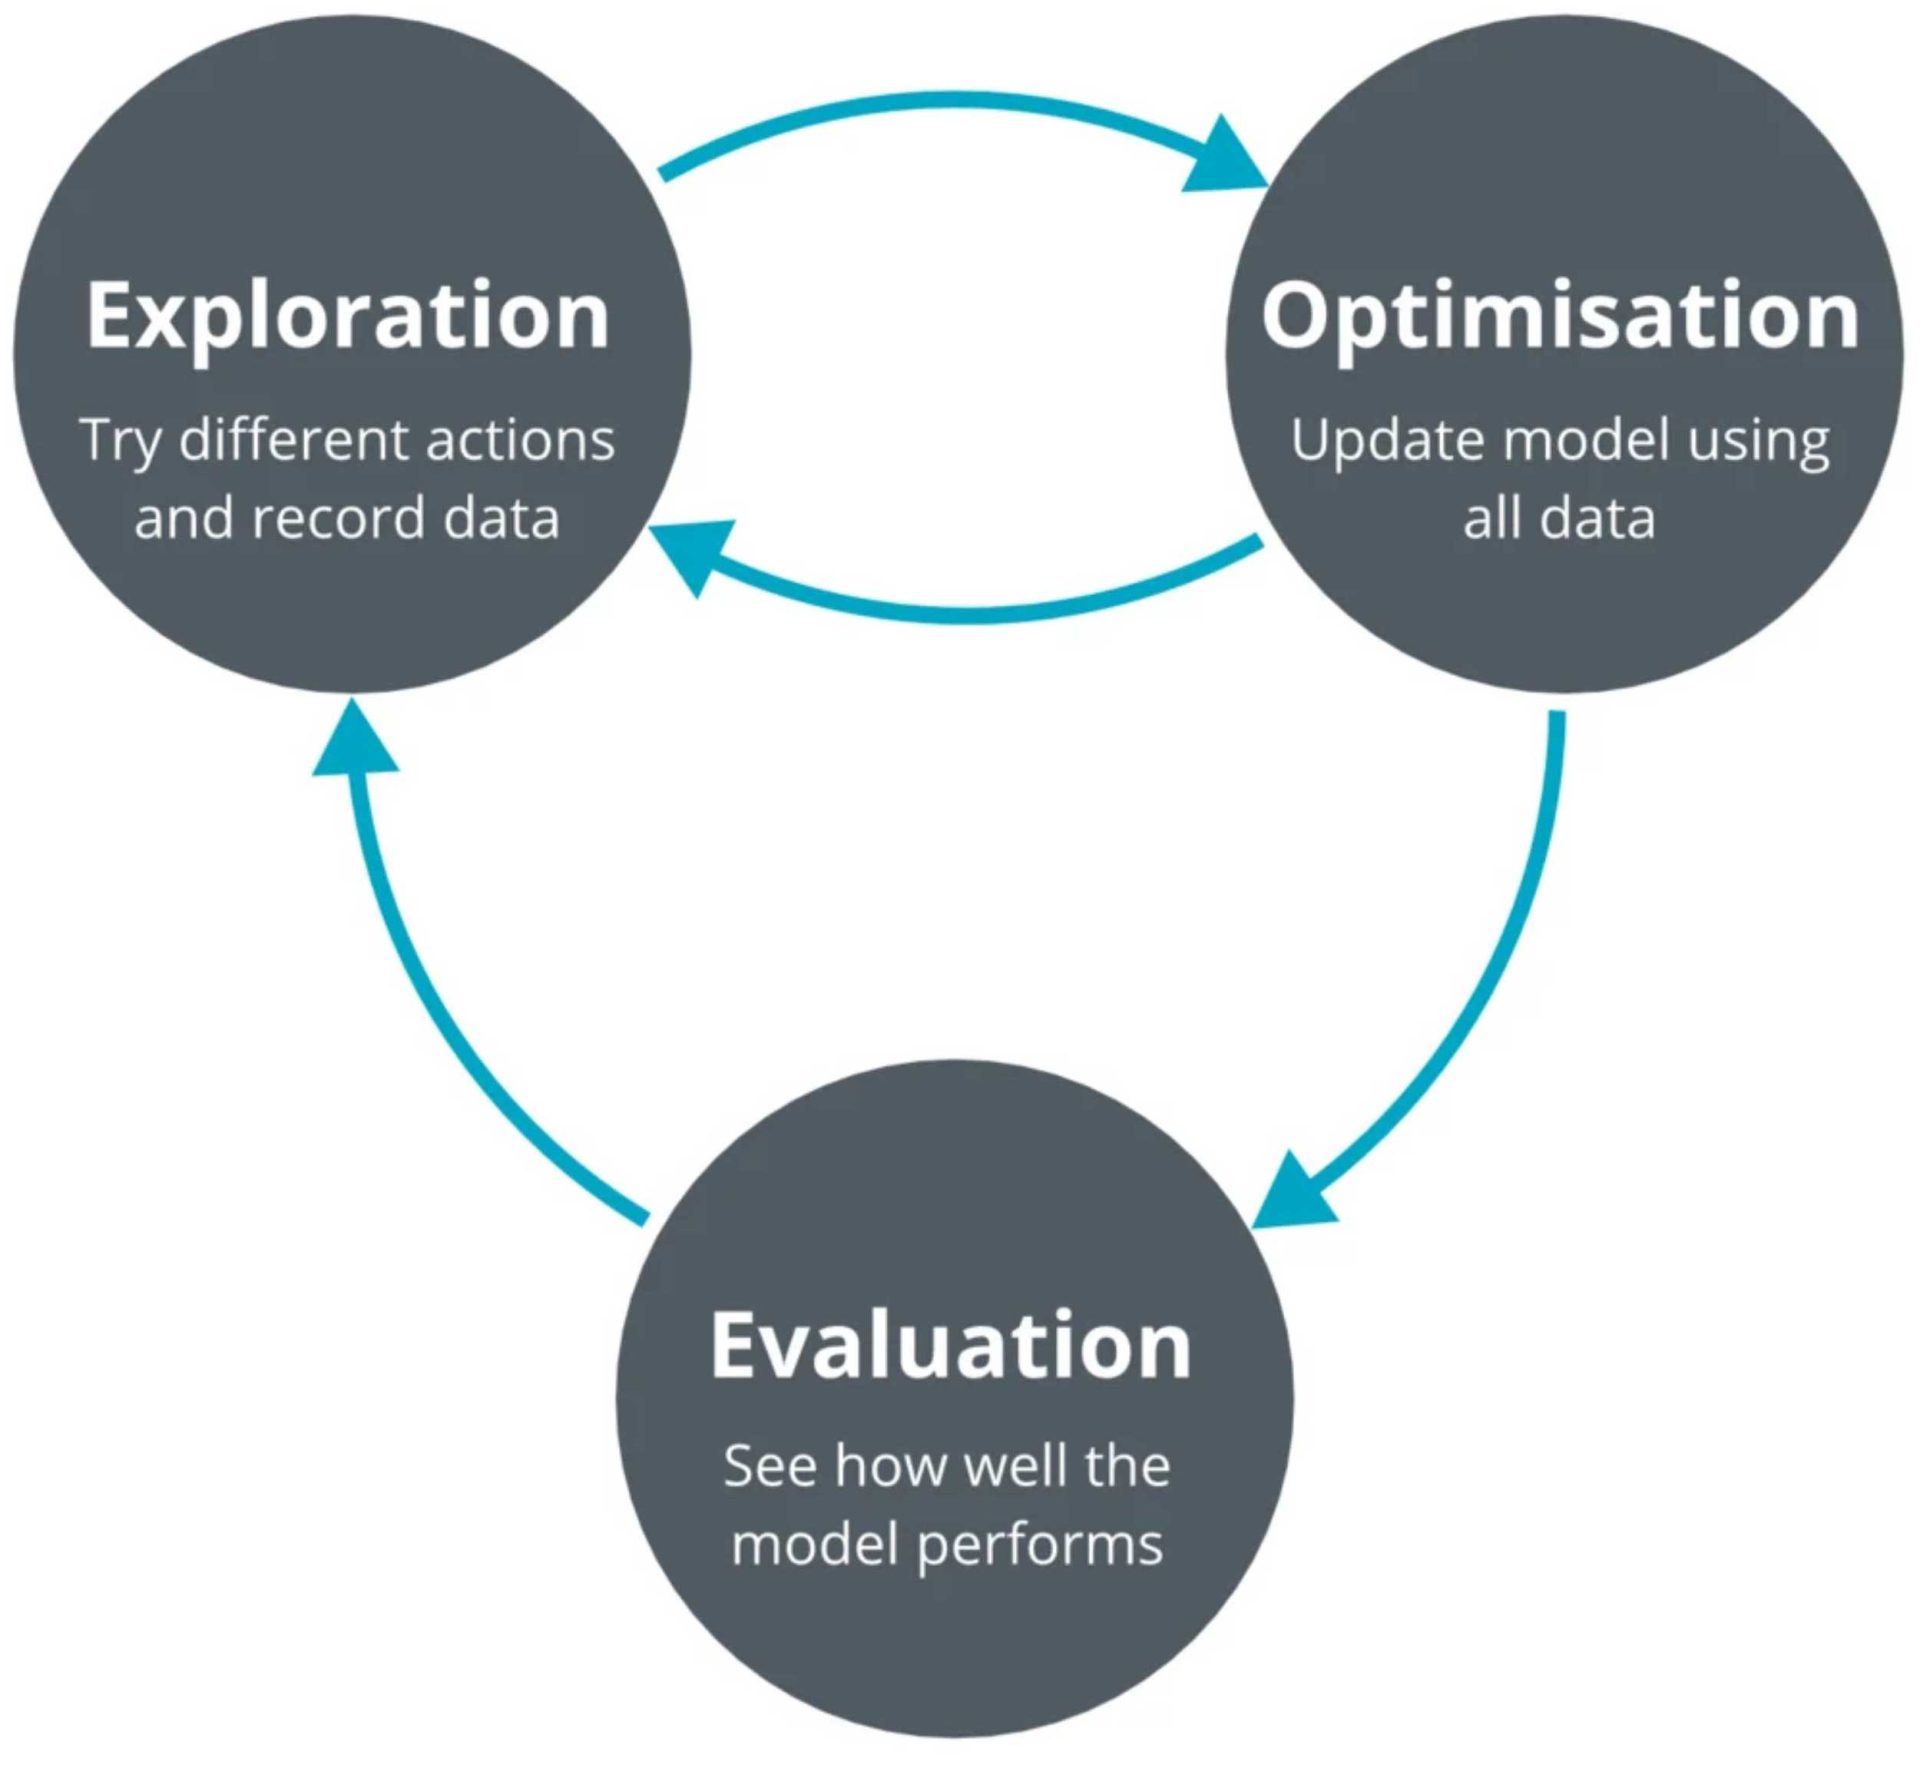
すべての処理は、車載の1台のグラフィックス・プロセッシング・ユニット(GPU)上で行われました。
危険を伴う現実の環境で本物のロボットを動かすには、多くの新たな課題が生じます。当面のタスクをより深く理解し、適切なモデルアーキテクチャとハイパーパラメータを見つけるために、シミュレーションで多くのテストを実施しました。
上記は、さまざまな角度から見た車線追従シミュレーション環境の例です。アルゴリズムには、ティール色の枠で囲まれた画像、つまりドライバーの視点のみが見えています。各エピソードでは、追従すべき曲線車線、道路の質感、車線表示をランダムに生成します。エージェントは車線を外れるまで探索を行い、外れた時点でエピソードは終了します。その後、収集されたデータに基づいて方策が最適化され、このプロセスを繰り返します。
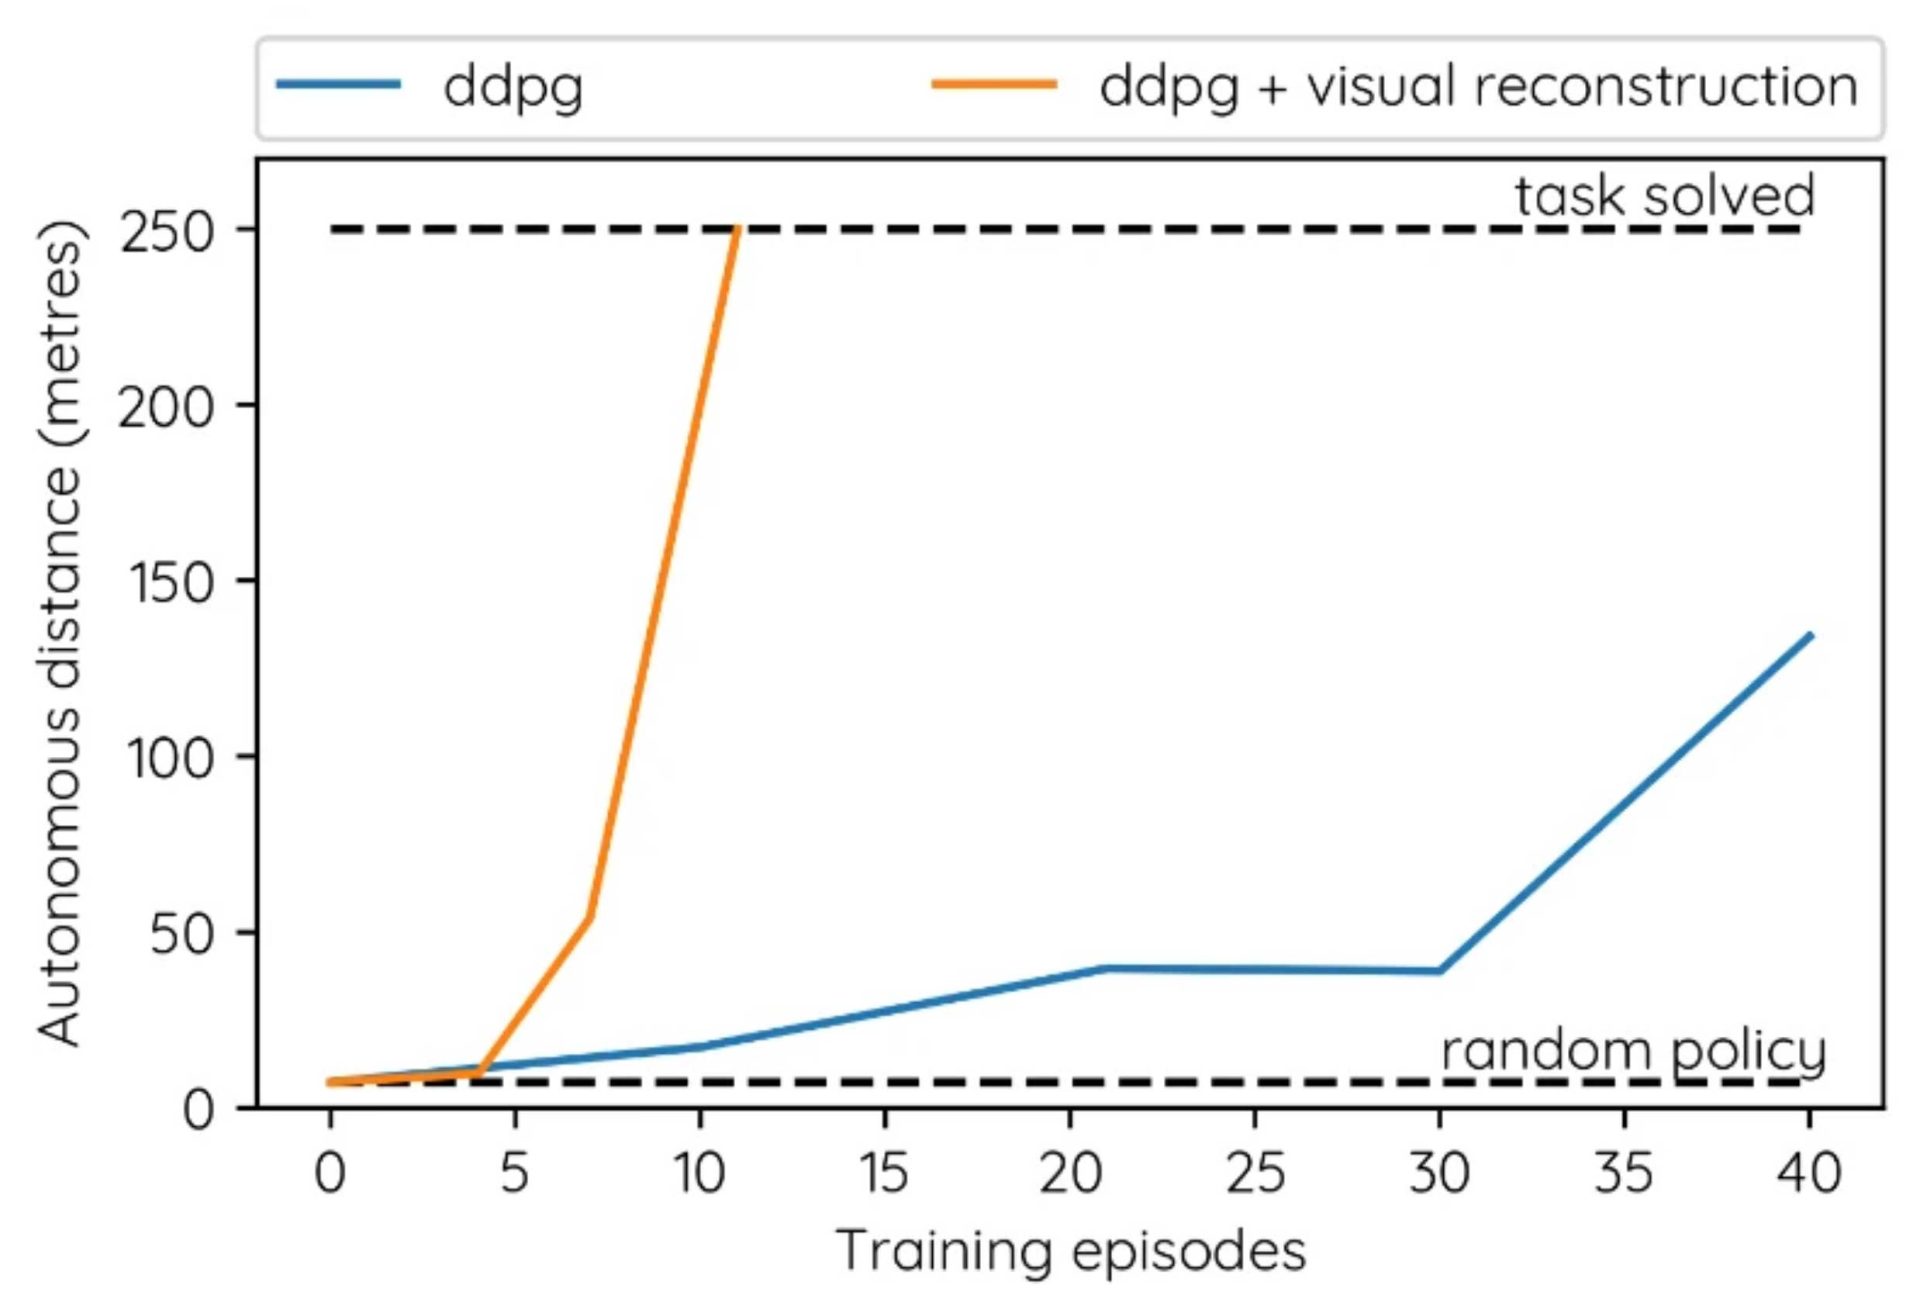
シミュレーションテストを用いて、非常に少ないトレーニングエピソード(つまり少ないデータ量)で一貫して車線追従タスクを解決できる設定が見つかるまで、さまざまなニューラルネットワークアーキテクチャとハイパーパラメータを試しました。例えば、オートエンコーダの再構成誤差を用いて畳み込み層をトレーニングすることで、学習の安定性とデータ効率が大幅に向上することがわかりました。詳細は技術レポート全文をご覧ください。
このアプローチがもたらす潜在的な影響は計り知れません
当初の運転アルゴリズムの質が人間のドライバーの95%である自動運転車フリートを導入することを想像してみてください。そのようなシステムは、デモビデオにあるランダムに初期化されたモデルのようにふらつくことはなく、信号機、ラウンドアバウト、交差点などにもほぼ対応できるでしょう。丸一日の走行と、人間のセーフティドライバーの介入によるオンラインでの改善を経て、システムは96%に向上するかもしれません。1週間後には98%、1ヶ月後には99%に。そして数ヶ月後には、多くの異なるセーフティドライバーからのフィードバックの恩恵を受け、システムは人間を超える能力を持つようになるかもしれません。
今日の自動運転車は、「良好だが十分ではない」パフォーマンスレベルで停滞しています。ここで私たちは、平凡な運転アルゴリズムを実用レベルまで迅速に向上させるための、初めての実行可能なフレームワークを提示しました。賢い試行錯誤を通じてタスクを迅速に解決する能力こそが、人間を進化と生存を可能にする驚異的に多才な機械にしてきたものです。私たちは、自転車の乗り方から料理の仕方まで、模倣と多くの試行錯誤を組み合わせて学習します。
DeepMindは、深層強化学習の手法が囲碁、チェス、コンピュータゲームを含む多くのゲームにおいて、ほぼ常にルールベースのシステムを凌駕し、人間を超えるパフォーマンスを発揮できることを示しました。私たちはここで、同様の哲学が現実世界、特に自動運転車においても可能であることを示しています。注目すべき重要な点は、DeepMindのAtariプレイアルゴリズムがタスクの解決に数百万回の試行を必要としたことです。私たちが20回未満の試行で一貫して車線追従を学習できたことは、驚くべき成果です。
20分でゼロから車線追従を学習しました。
1日あれば、何ができるようになるか想像してみてください。
Wayveには、ロボットの知能を構築するために巨大なモデルや豪華なセンサー、終わりのないデータは必要ないという哲学があります。必要なのは、上記のビデオのように、迅速かつ効率的に学習する賢いトレーニングプロセスです。自動運転の問題に対する手作業の設計アプローチは、満足のいかないパフォーマンスの限界に達しています。Wayveは、よりスマートな機械学習によって自動運転の能力を解き放とうとしています。
特別な感謝を込めて
素晴らしいロボット車両を製作してくれたStreetDrone、車両試験に保険を提供してくれたAdmiral、そして車線追従研究のために私有地への立ち入りを許可してくれたケンブリッジ・ポロ・クラブに感謝いたします。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む