








2 12月 2019 | リサーチ
学習型都市走行
本年2019年2月、当社はユーザー定義ルートに沿って車両全体を制御する初のend-to-end学習型運転システムを実証しました。これは、自動運転という大きな課題に対し、HDマップのようなインフラや高価なセンサーペイロードに依存せず、これまで走行したことのないルート(交通状況との相互作用を含む)でも複雑な運転ができるという、異なるアプローチが可能であることを示した点で、モバイルロボティクス向けAI開発における画期的な一歩となりました。
本稿では、この実証に至るまでの詳細の一部をご紹介します。詳細については、arXivでプレプリント論文を公開しており、NeurIPSのML4ADワークショップで発表する予定です。
この技術的な世界初の発表以来、当社は企業として成長を続けています(The TimesおよびVentureBeatの記事をご覧ください)。資金調達ラウンドを成功させ、本社をケンブリッジからロンドンに移転し、技術開発の基盤を改造ルノー・トゥイージーからジャガーI-PACE電気自動車のフリートに完全に再構築しました。そして、最先端の学習型自動運転の技術的限界を押し広げ続けています。
問題の構造化方法
機械学習手法は、大きく分けて教師あり学習、教師なし学習、または強化学習に分類できます。制御ポリシーを学習する文脈では、主要な学習シグナルは、エキスパートによるデモンストレーションデータ、またはオンポリシーフィードバックおよび介入データから得られます。当社の最初の技術デモンストレーションでは、スパースなセーフティドライバーの介入を用いて、強化学習によってゼロから車線維持を学習できることを示しました。
ここでは、人間による運転を模倣して学習することに焦点を当てました。これはしばしば模倣学習と呼ばれるアプローチです。この拡張として、条件付き模倣学習があり、これは観測された状態に加えて、特定の入力が与えられた場合に異なる行動を実行するようにニューラルネットワークを訓練します。当社はこれを利用して、ユーザー定義ルートに沿って車を誘導します。
要するに、これは人間の運転データを収集し、この行動を模倣するように機械学習モデルを訓練することを意味します。具体的には、RGB画像から直接単純なモーションプランを学習し、そのプランを車で実行します。
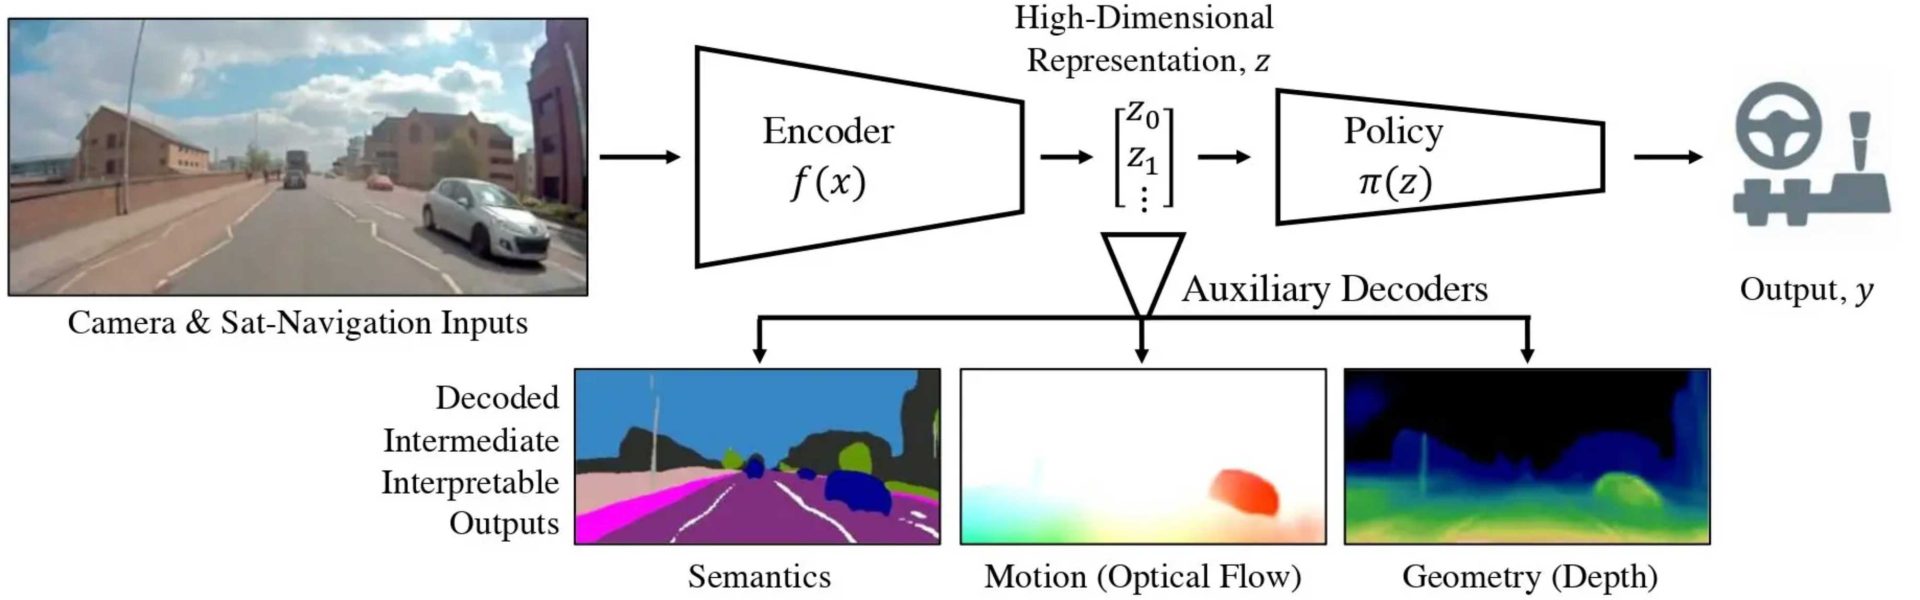
上記の図で示したシステムを、わずか30時間の運転データで訓練し、訓練データには含まれていない2つの都市ルートで35kmの自動走行テストを実施しました。また、テストルート走行中に、意図的にテスト車両を停止させるために、敵対的なペースカーと相互作用させる一連の運転テストも実施しました。
このシステムは、都市環境で他の交通と相互作用しながら、ユーザーが指定したルートに沿って、学習による車両全体の制御(すなわち、横方向と縦方向の両方)を実証した初のものです。
当社は、これまでのいくつかの研究に触発されました。
- Nvidiaによる、交通のない新しい道路でのend-to-end深層学習によるステアリングのみの制御と解釈可能性の実証、
- シミュレーションでの条件付き模倣学習と、おもちゃのRCカーを用いた制約された環境での車両全体の制御の実証、
- よりリッチな学習型ルート埋め込みを用いた、ステアリングのみの制御と位置特定予測の学習の実証、
- モーションプランニングなど、一般的な自動車両ソフトウェアスタックの一部に対する学習型アプローチ、
…その他。
何が学べたか?
この根本的に新しい自動運転アプローチについて、私たちは多くのことを学びました。3つの重要な結論と、改善のためのアイデアの数々を得ました。
1) データ分布は非常に重要である
運転データは均一に分布しておらず、素朴な訓練ではデータに存在する支配的なモードに収束してしまいます。素朴な訓練の結果、モデルは平均速度で直進するようになります。当社が使用した30時間の訓練データの分布は、以下のヒートマップとヒストグラムに示されています。直進走行と停車中の交通に費やす時間は相当なものです。
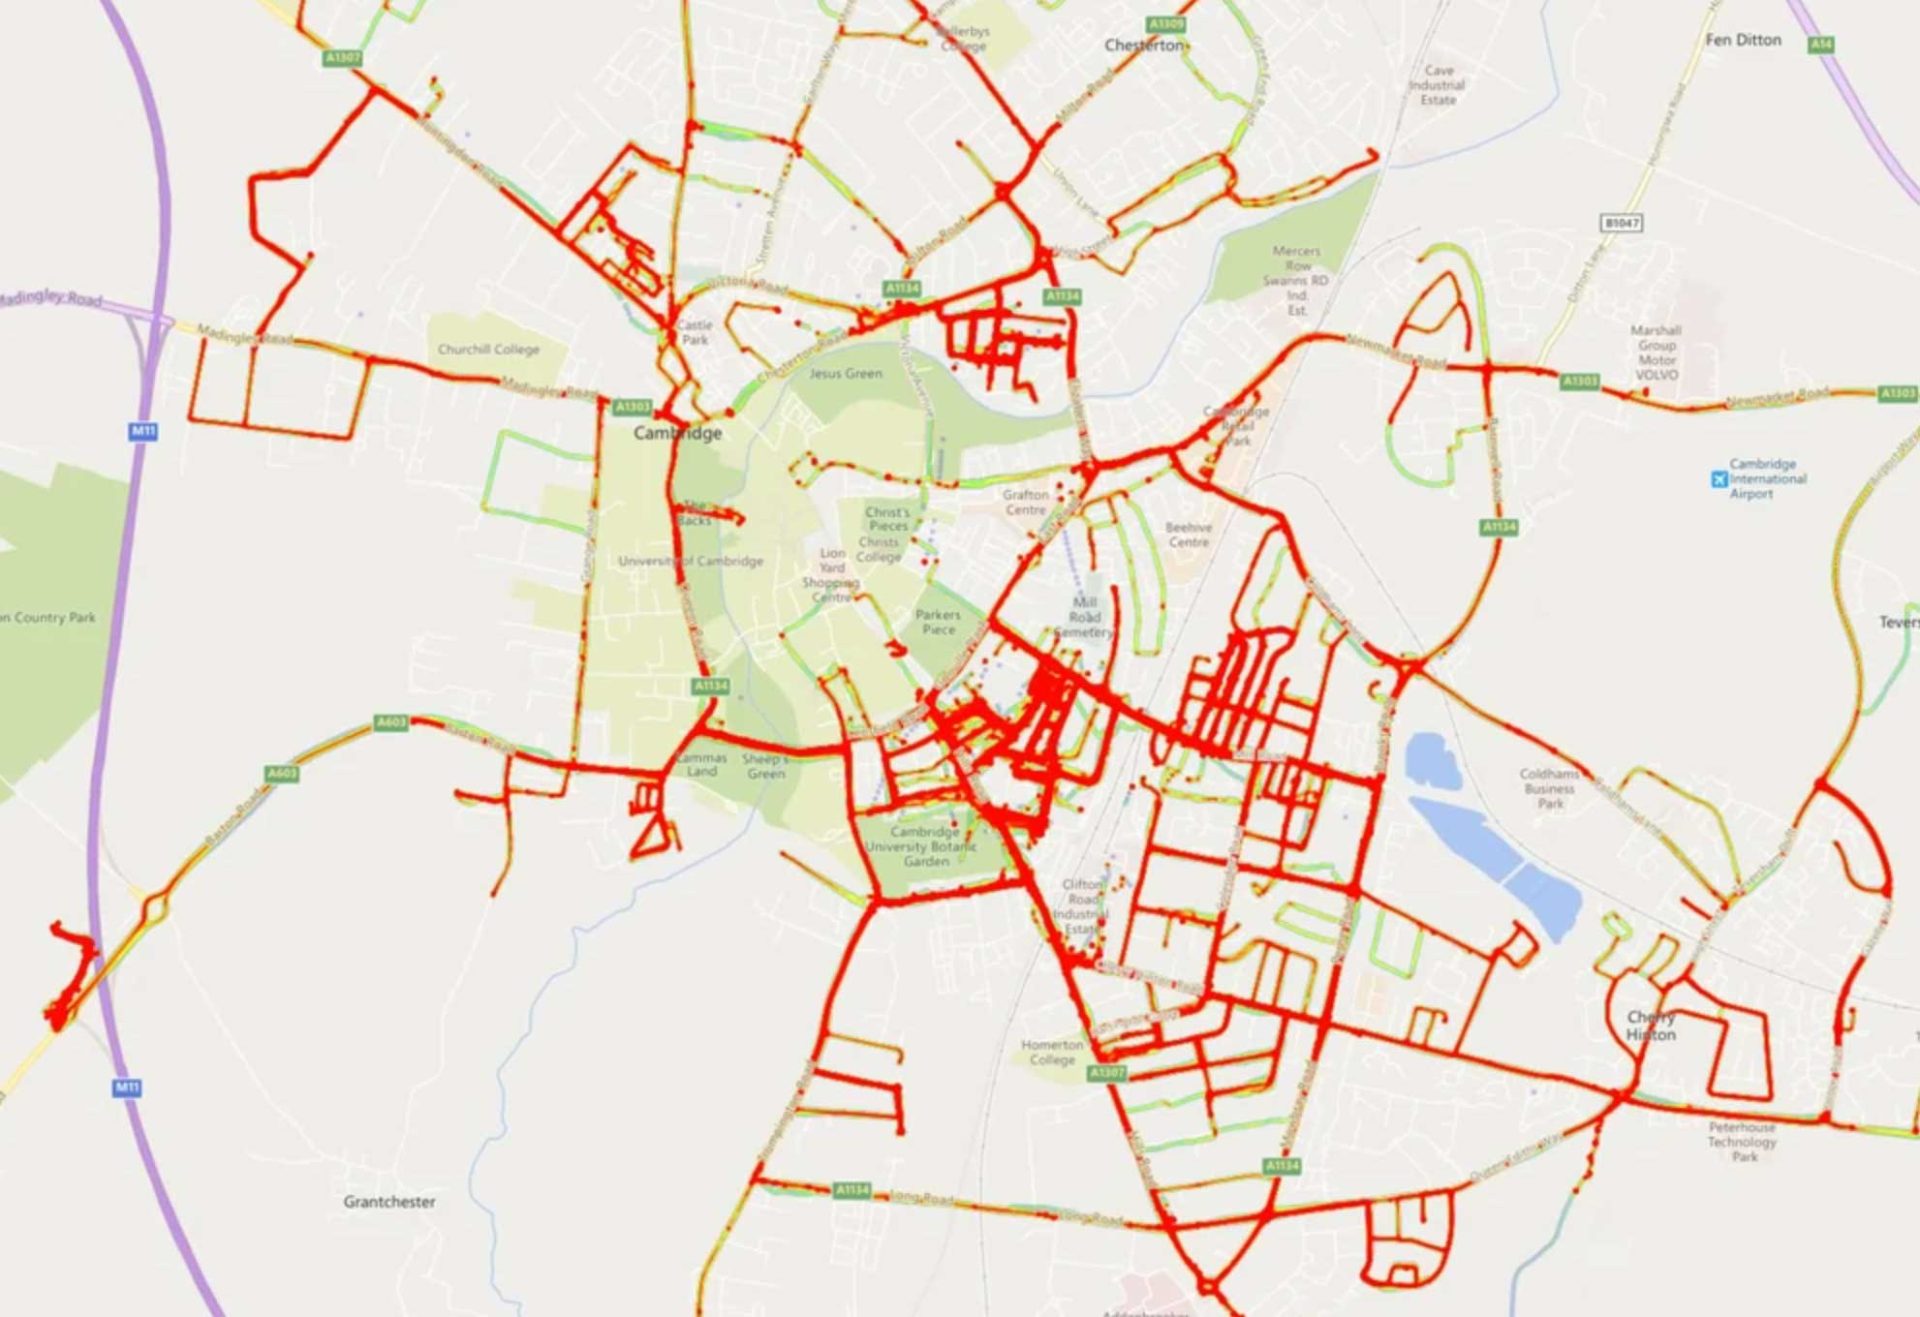
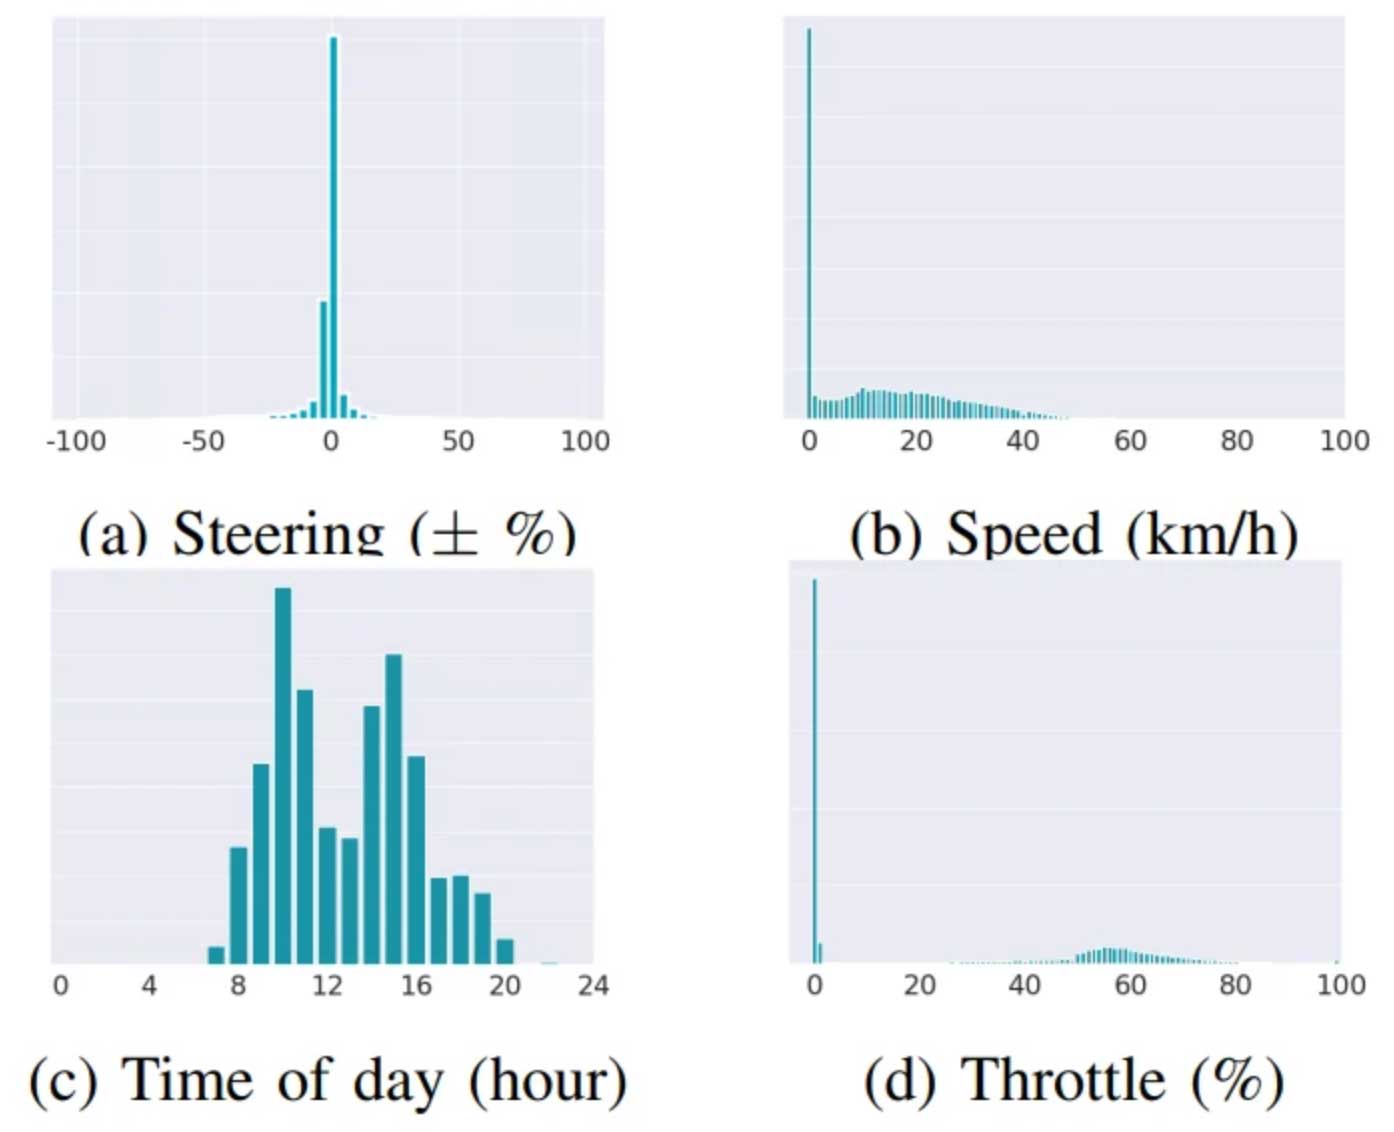
この問題に対処するため、訓練セットにデータ駆動型バランス調整を適用し、異なる運転操作に対してモデルが同等に反応するように訓練しました。この方法により、これまでの研究で使用されていたデータ拡張手法(データ収集中にオフセットカメラを使用して修正行動を合成する方法)が不要になります。
2) 堅牢なコンピュータビジョン表現が重要である
現実世界で、実際の画像を用いて堅牢な性能を達成することは困難です。この課題の大部分は、外観の変化によるデータの多様性に起因します。同じシーンでも、時間帯、天候、その他多くの要因によって大きく異なるように見えることがあります。この多様性はデータ駆動型アプローチにとって課題であり、学習モデルが訓練セットに過学習し、テストセットに汎化できないことが非常に容易に起こります。ロボティクスでは、「テスト」データは現実世界であり、ほとんどのML問題で典型的な静的データセットではありません。当社の車が走行するたびに、世界は新しく、ユニークです。
訓練するモデルが現実世界に汎化できることは極めて重要です。原則として、無限のデータがあれば、現実世界にうまく汎化する運転システムを学習できるでしょう。このアプローチは、DeepMindがAlphaStarで行ったシミュレーション作業や、OpenAIがロボットで物体を操作する学習で、何時間も放置できるような状況で見られます。これらの状況では、対象のタスクに対して膨大な量の訓練データを生成することが可能です。しかし、実際には、これは現実世界のほとんどの問題には当てはまりません。
当社はこの問題をコンピュータビジョンに目を向けることで解決します。
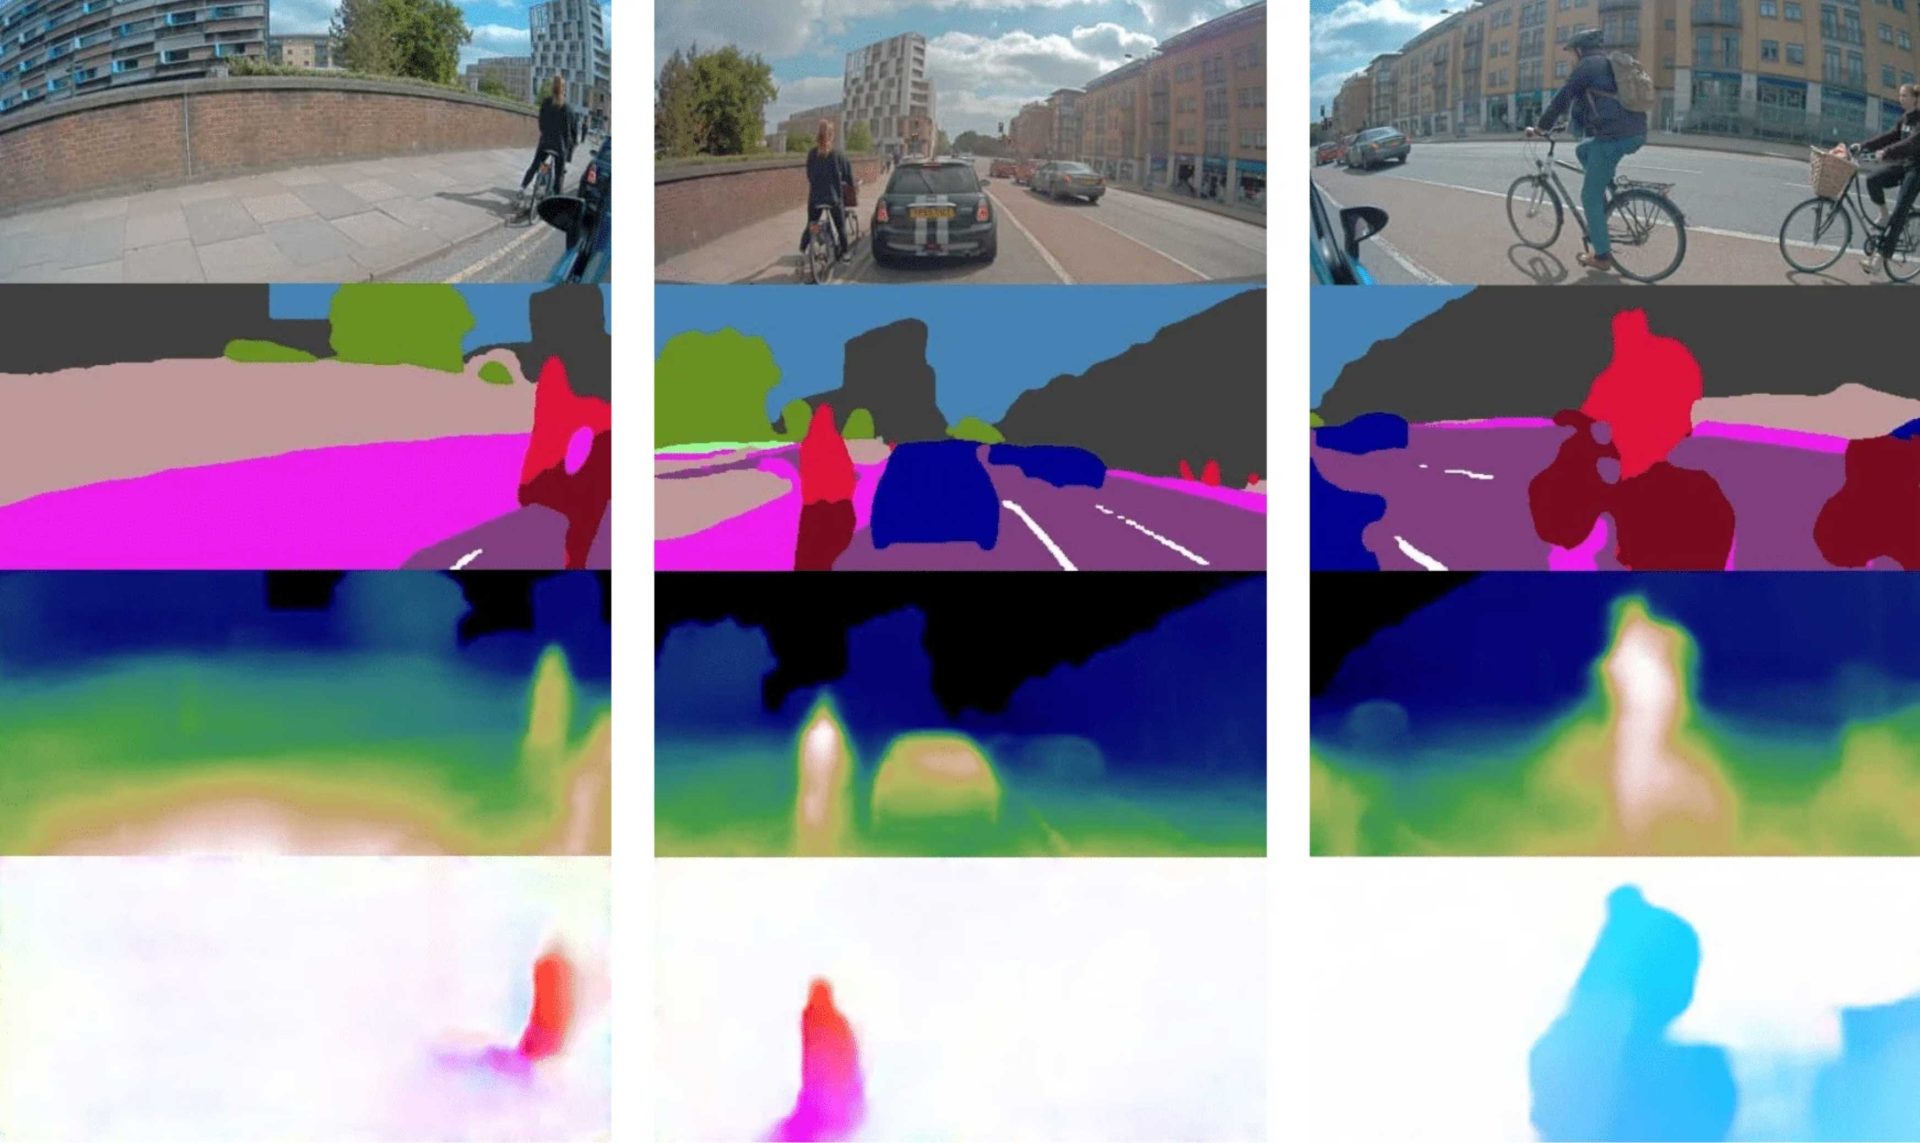
運転のための高次元表現(最初の図のZ)の堅牢性を高めるため、主要な共有エンコーダと補助的な独立デコーダを、運転に有用であることが分かっているいくつかのコンピュータビジョンタスク用に訓練します。
- 周囲には何があるか? セマンティックセグメンテーション。
- シーンの幾何学的構造はどうか? 単眼深度推定。
- シーンの異なる部分はどのように動いているか? オプティカルフロー推定。
当社の実世界テストでは、この学習型視覚表現が、現実世界での効率的な運転を実現するために不可欠であることが示されました。
3) データ効率のために複数の学習シグナルを使用する
フィールドロボティクスは非常に時間がかかり、テストが効率的かつ効果的であることを保証するために、多くの事前計画が必要です。この問題の一部は、効果的なフィールドテストロジスティクスによって軽減できます。当社は、このブログにあるティム・バーフット教授のフィールドトライアルの原則を好んでいます。エンドツーエンドの文脈では、フィールドトライアルにはデータ収集と閉ループ評価の両方が含まれます。
訓練とテストの両方で車両時間を最大限に活用するため、当社は効率的な学習を優先しています。これは、車両の使用状況を判断し、厳密なテストを行い、手持ちのデータから最大限の成果を引き出すことを意味します。この分野の先行研究では、RGBピクセルを車両の動作にマッピングするエンドツーエンドの訓練が行われてきました。RGBデータはエントロピーが高いため、この方法ではデータ効率の良い堅牢な制御ポリシーを学習することは困難です。このような状況では、一部の著者は画像を大幅にトリミングしたり、問題をシミュレーションに限定したりしています。
特に、複数の学習シグナルを用いることでデータ効率が向上することを発見しました。ここでの例は、当社が訓練するコンピュータビジョンタスクにおける学習シグナルです。しかし、これは単一のタスクに限定されません。利用可能な学習シグナルの例としては、以下が挙げられます。
- 人間のエキスパートドライバーの模倣(教師あり学習)、
- セーフティドライバーの介入データ(負の強化学習)と修正行動(教師あり学習)、
- 幾何学、力学、動き、将来予測(自己教師あり学習)、
- ラベル付きセマンティックコンピュータビジョンデータ(教師あり学習)、
- シミュレーション(教師あり学習)。
この追加の学習シグナルの結果、当社は30時間のラベル付き制御データで、単純な都市走行のための有用な運転ポリシーを学習することができました。これは比較的少量の運転データであり、その一因として、学習型コンピュータビジョン表現の事前訓練が挙げられます。人間は運転を学ぶ前に16〜17年間の視覚予測モデルを学習していますが、通常、仮免許を取得するまでの運転訓練はわずか約30時間です。
当社にとって興味深かったのは、データが性能に与える影響を検討することでした。訓練コーパスを減らすことでモデルの性能を低下させ、データが介入率に与える影響を調べました。深層学習はデータに対して非常にうまくスケールし、多くの場合対数的な関係があることが知られています。当社データでも非常に強い相関関係が観察されました。
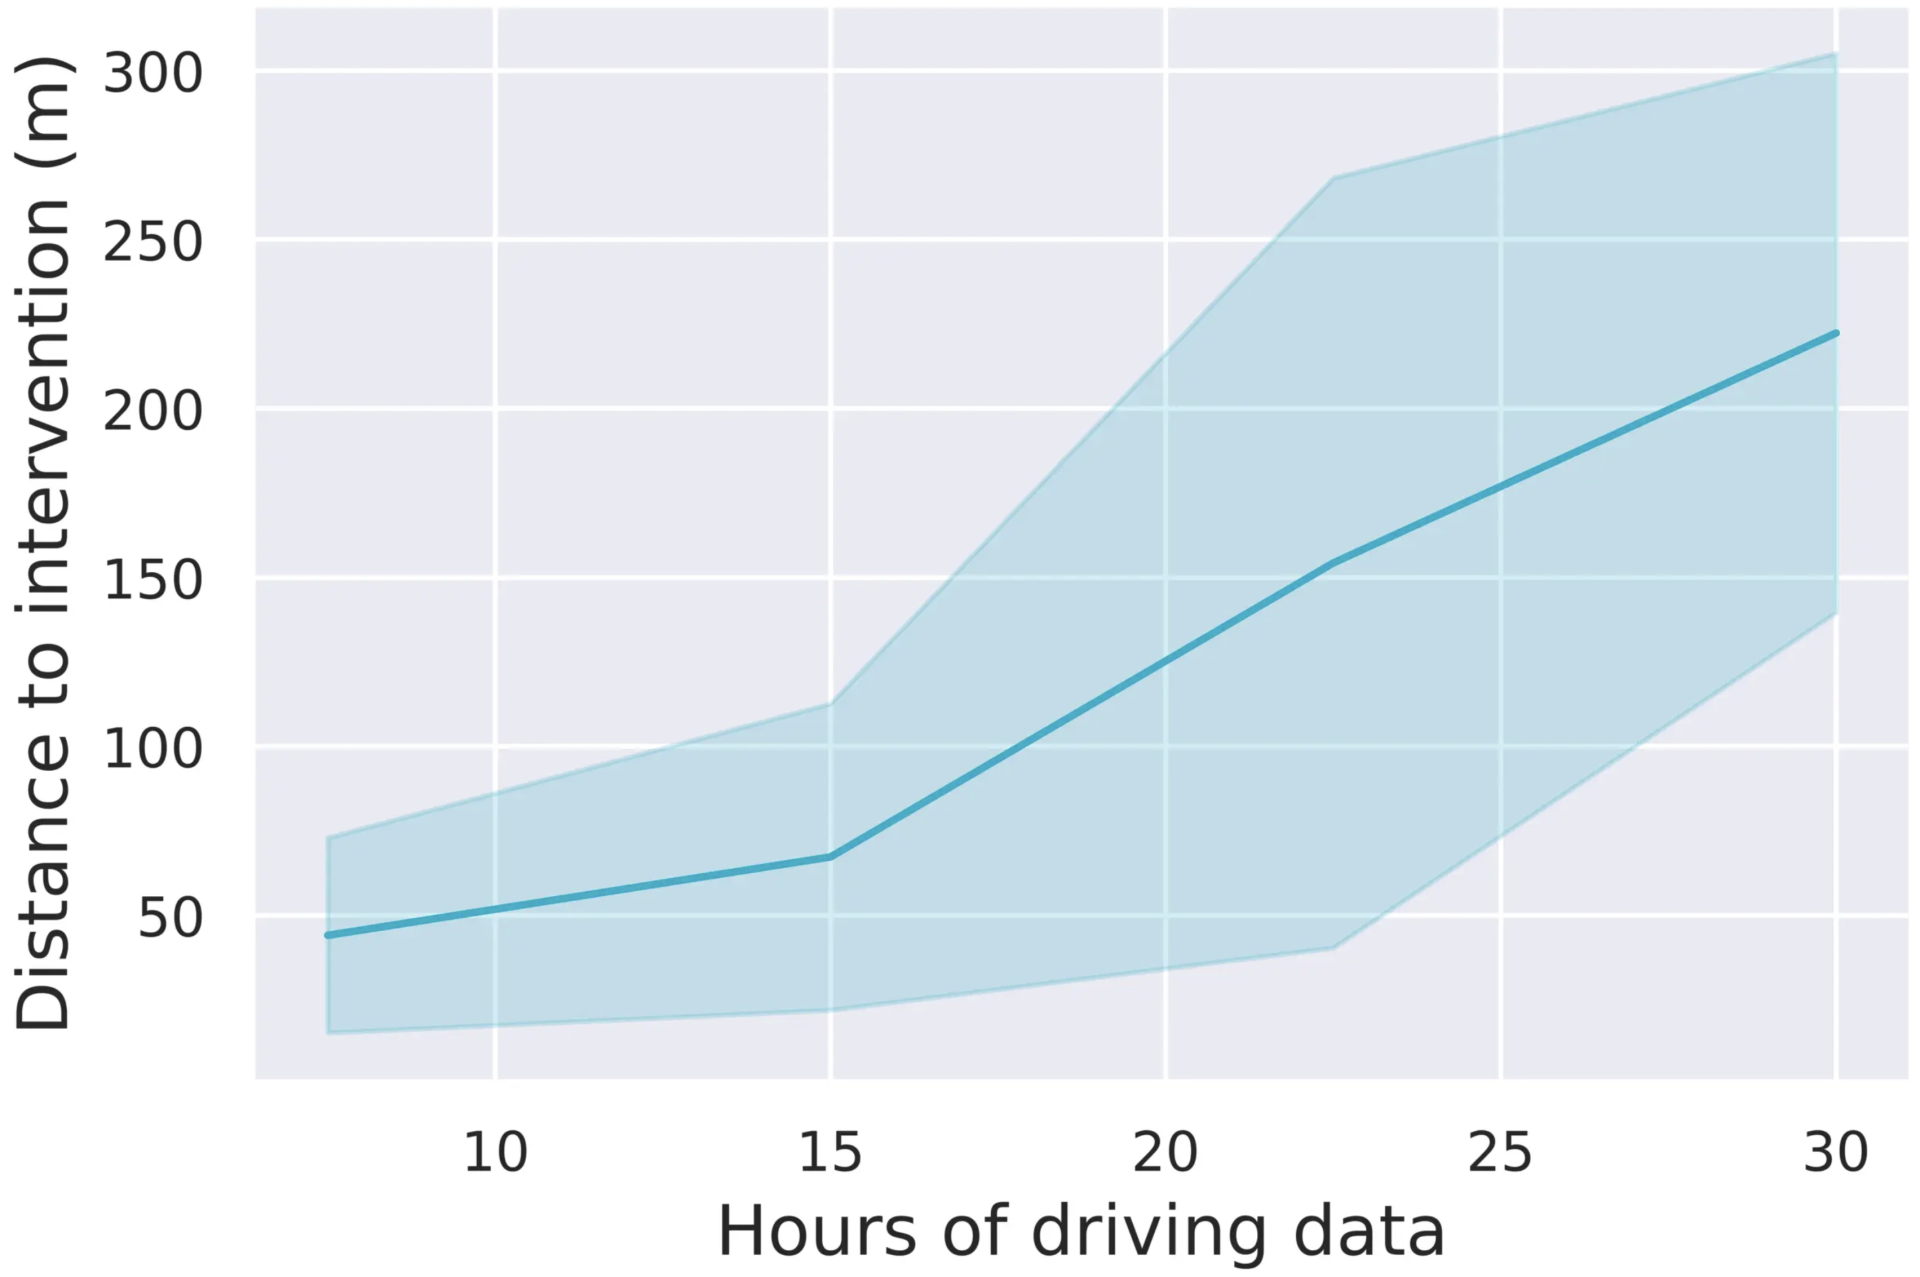
これは、データ多様性の増加が性能向上につながるという明確なシグナルを与えてくれるため、非常に興味深いことです。現在のところ、人間のドライバーに近い性能レベルには達しておらず、性能の漸近線も不明ですが、これは性能向上のために2つのレバーがあることを示唆しています。1) アルゴリズムの革新、2) データです。
どのような新たな課題に注力しているか?
ここでテストしたシステムは、これらの学習型システムが実際に機能するという重要な実証点を示しました。この技術には、今後多くの興味深い課題があります。特に、学習型運転システムが人間の運転性能に匹敵する(またはそれを超える)レベルに到達するためには、以下の要素が必要であると当社は考えています。
1. 予測的および時間的モデル能力
マルチモーダルなシーン理解に時間的予測を適用することは、例えば交差点での潜在的な交通行動の評価や、遮蔽された自転車との安全な運転など、運転にとって不可欠です。
2. 運転性能の効率的なオフライン評価
現在、オープンループ指標(すなわち、オフラインデータセットでの評価)は、閉ループ性能(すなわち、制御ループを閉じて評価すること)の貧弱な指標であると考えられています。過去数年間で機械学習とコンピュータビジョンにおいて見られた大きな進歩は、データセットと効果的なベンチマークの存在に大きく起因しています。ベンチマークが整備されれば、研究コミュニティは課題解決に非常に優れています。ImageNet、Cityscapesなどがその例です。現在、自動運転のための学習型視覚制御、または視覚制御における他の類似問題に対するこのような性能ベンチマークは存在しません。CARLAシミュレーターはこの方向で大きな進歩を遂げていますが、研究コミュニティとしては、現実世界の運転問題を完全に代表する標準化されたベンチマークをまだ持っていません。当社はこれを対処すべき重要なギャップと見ています。
3. デモンストレーションと失敗の両方から学習する
ここでは、人間によるデモンストレーションからの学習のみに焦点を当てましたが、以前は介入データのみから学習する能力を実証しました。実際には、堅牢な制御ポリシーを効率的に学習するためには、両方のアプローチが必要です。
これらの分野における当社の今後の進捗にご期待ください!
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む