








5 5月 2026 | リサーチ
LA-Pose:1000万件の走行動画がカメラ姿勢推定について教えてくれたこと
当社は1020万件のラベルなし走行動画で動きを学習し、その結果、ごく一部のラベル付きデータで最先端の姿勢推定を凌駕しました。
カメラ姿勢を学習するあらゆる真剣なアプローチ、つまり車両が空間をどのように移動したかを正確に知ることは、常に同じボトルネックに依存してきました。それは、高価で慎重にラベル付けされた3Dグラウンドトゥルースです。LiDARリグ、再構築パイプライン、シミュレーションエンジン。これらの製造コストが高いデータセットは、必然的に小規模です。それらで訓練されたモデルは、その限界を受け継ぎます。
私たちはそのループから抜け出す方法を求めていました。モデルにラベル付き3Dデータから姿勢を学習させる代わりに、少量の情報(潜在行動)を使用して次のフレームを予測するようにモデルを解放しました。その驚くべき結果として、この潜在行動はカメラのエゴ姿勢をエンコードし、ラベルなしデータをスケールアップするにつれて改善されます。
車両は、その定義上、常に世界中を移動しています。すべてのフレームシーケンスには、必要な信号、つまりある瞬間から次の瞬間にかけてシーンがどのように変化したかがすでに含まれています。これらの変化は、車が左折しているか、加速しているか、停止するために減速しているかにかかわらず、ピクセル自体にエンコードされています。私たちはそれにラベルを付ける必要はありません。
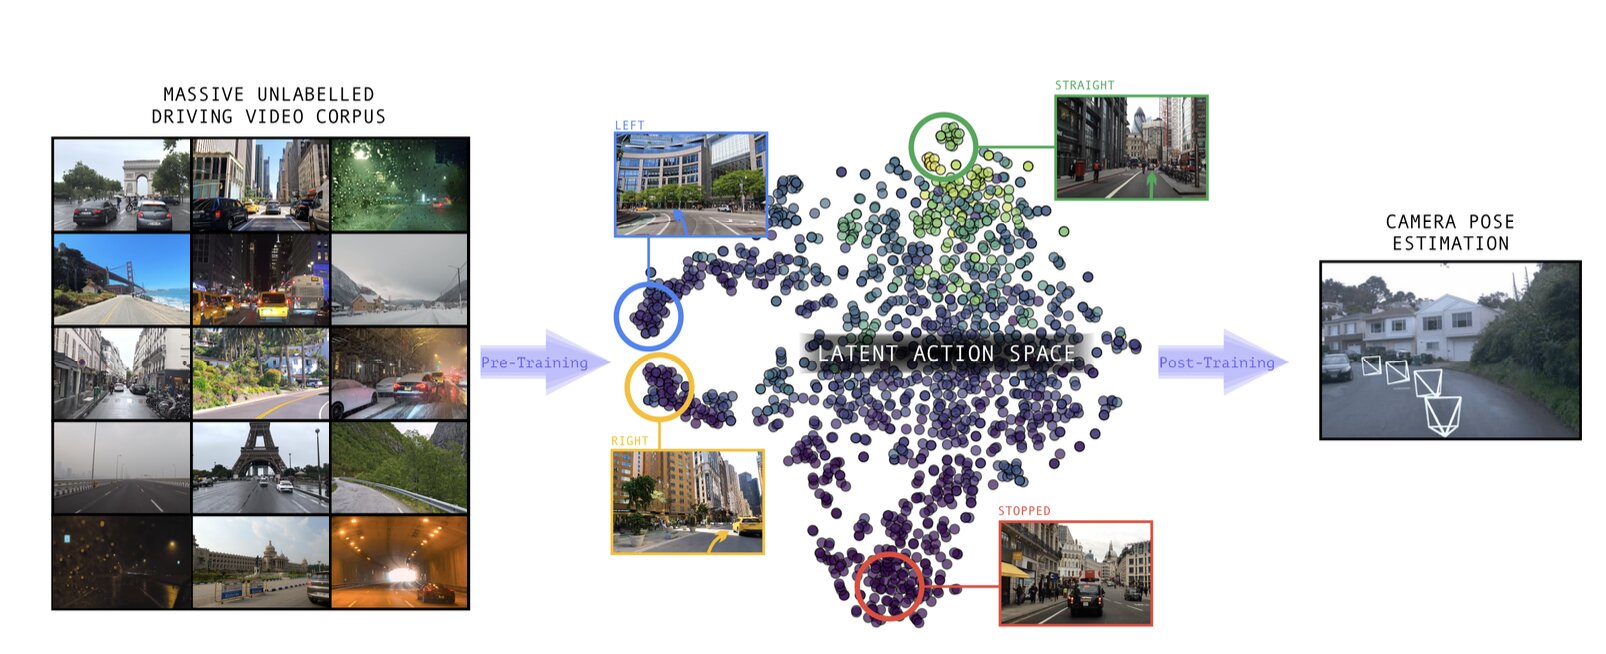
LA-Poseは、1020万件のラベルなし走行クリップで訓練された逆動力学モデルを使用して、私たちが潜在行動と呼ぶものを学習します。これは、連続するフレーム間で世界がどのように変化したかをコンパクトに表現したものです。モデルには車両の速度や進行方向は一切伝えられません。モデルはそれらを自己教師あり学習で推論することを学習します。
これらの表現をT-SNE空間で可視化すると、驚くべきことが起こります。潜在行動は、明確なクラスターに組織化され、実際の運転行動(直進、左折、右折、停止)にきれにマッピングされます。単一の姿勢ラベルなしに、スケールから構造が出現します。これが事前学習段階です。これにより、モデルは動きがどのように見えるかを学習します。
動きからメトリック空間へ
第2段階は、これが自律走行に役立つ段階です。事前学習された逆動力学モデルを凍結し、Waymo、nuScenes、Argoverseからの少量のラベル付き走行データを使用して、軽量な姿勢推定ヘッドをその上に訓練します。このヘッドは、これらの潜在的な動きの表現を、単一の順方向パスで正確な3D推定(並進、回転、視野、メトリックスケール)に変換することを学習します。
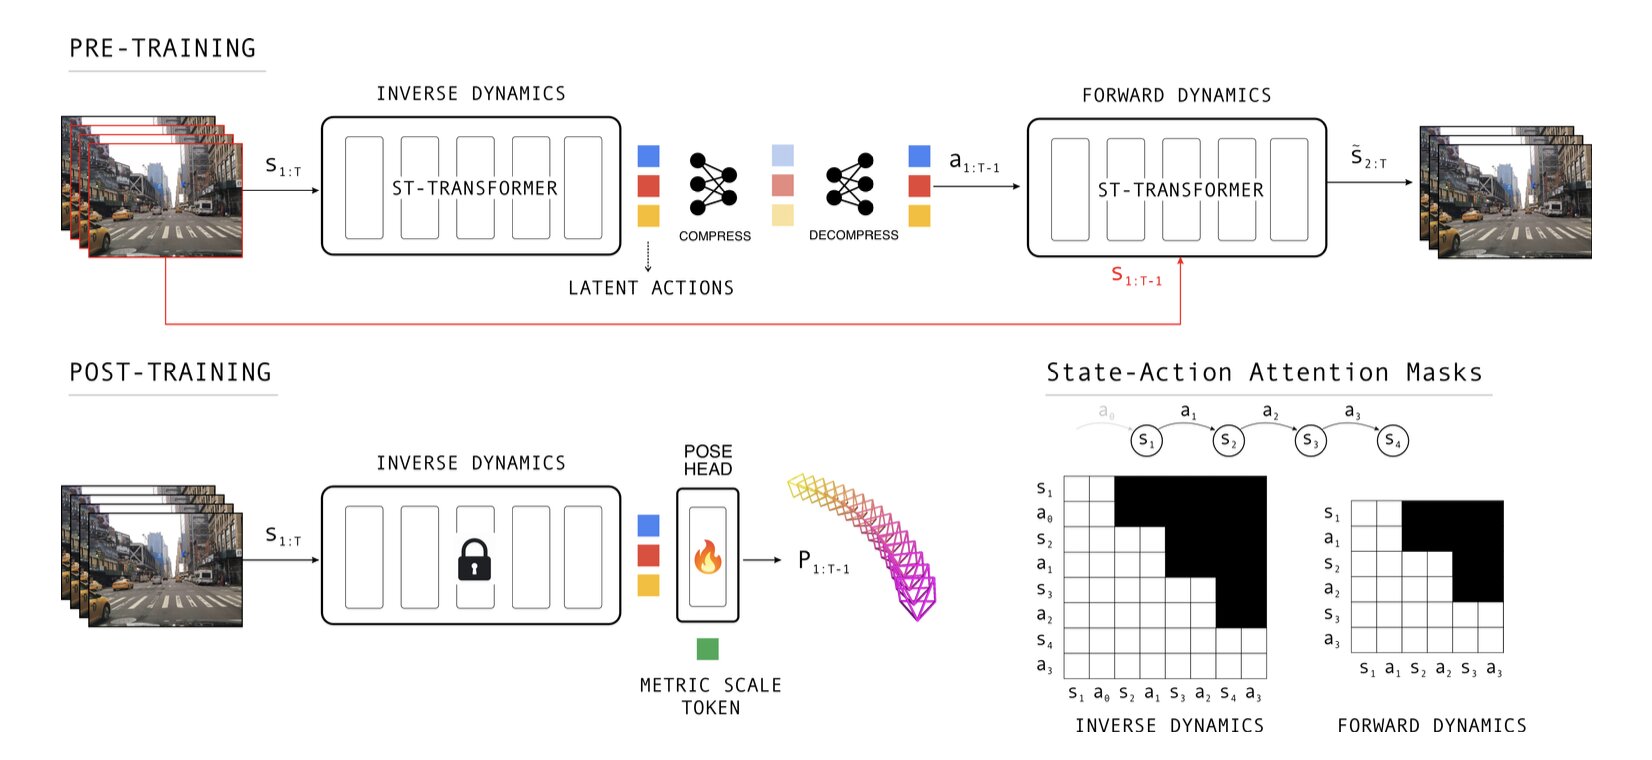
LA-Poseは、最先端のフィードフォワード手法よりも10%以上高い姿勢精度を達成し、必要なラベル付きデータは桁違いに少なくて済みます。モデルが訓練中に一度も見たことのないデータセットであるPandaSetでも、すべてのベースラインを上回ります。このゼロショット汎化こそが、展開において最も重要なことです。
なぜ小さな潜在行動を使用するのか?この点を明確に示す発見がありました。50次元の潜在ボトルネックは、1536次元のボトルネックよりも優れた下流の姿勢推定を生成します。これは、より大きな空間の方が動画をより正確に再構築できるにもかかわらずです。この圧縮により、モデルは外観を破棄し、動きを保持することを強制されます。この制約が、表現を有用なものにしているのです。
私たちが知る限り、逆動力学自己教師あり学習が姿勢推定を推進するために使用されたのはこれが初めてです。私たちは、これが他の人々が幾何学的知覚がスケールから他に何を学習できるかを探求することを奨励することを願っています。
これが私たちの構築方法にとって重要な理由
Wayveの車両は、大きく異なる条件下で何百もの都市を走行してきました。そのデータは存在します。問題は、別のLiDARリグを稼働させたり、別のラベル付きデータセットをゼロから構築したりすることなく、その経験を新しい都市やシナリオに汎化できるかどうかでした。
ほとんどの3D知覚システムはそれができません。それらは厳選されたデータセットと校正されたハードウェアで訓練されています。そのため、見たことのある条件下では正確ですが、見たことのない条件下では脆弱です。
LA-Poseは異なる賭けです。それは、大規模なラベルなし動画が豊富な幾何学的事前知識を構築するのに十分な信号を含んでおり、少量のターゲットを絞った教師あり学習がそれらの事前知識をメトリックな現実に根付かせることができるというものです。これにより、経済性と改善の軌跡の両方が変わります。
まだやるべきことはあります。例えば、LA-Poseは現在、後退動作で性能が低下します。訓練後のデータでは後退が十分にまれであるため、モデルがそれを完全に学習していないことがわかりました。事前学習と訓練後のコーパスの両方をスケールアップすることが次の自然なステップであり、運転を超えてロボットが収集した動画や手持ちの動画にまで拡張することで、逆動力学モデルがはるかに豊かな動きを学習し、より良く汎化できるようになります。
しかし、核となるアイデアは変わりません。動きこそが信号です。そして、それはすでにどこにでも存在します。
論文とデモは la-pose.github.ioで入手可能です。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む