








10 1月 2023 | リサーチ
多様なシミュレーション環境における運転パフォーマンスの評価
モデル評価は、一般にAV2.0と呼ばれるエンドツーエンドの自動運転分野において、未解決の大きな課題です。本稿では、モデルの評価能力を向上させるために、マルチエージェント強化学習を用いて、公道における現実世界の動的な振る舞いの多様性をどのようにシミュレートしているか、当社の最新の研究成果をご紹介します。
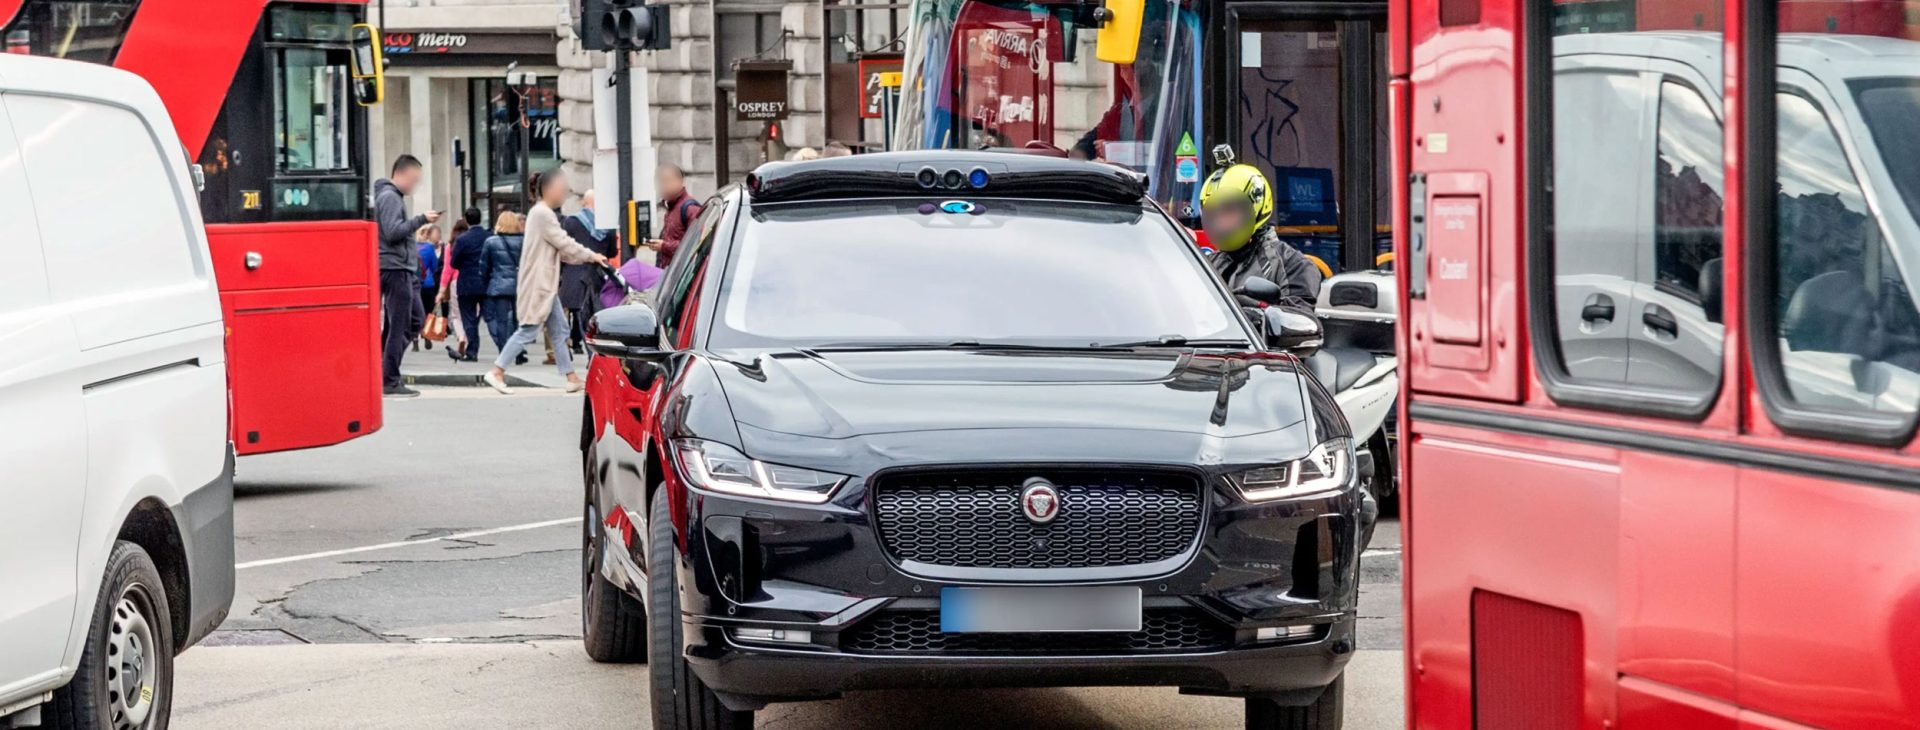
自動運転における課題の核心は、「オープンワールド」のあらゆる複雑さの中で状況を理解し、安全に行動する能力にあります。この複雑さはどこから来るのでしょうか?それは私たち人間です。人間は、運転、サイクリング、歩行、あるいはスクーターでの移動において、予測不能で一貫性がなく、時には危険な行動をとることがあります。無意識のうちに、私たちは移動しながら常に他者と相互作用しています。私たちの行動は、自身の目的、慣習、法律、安全性、その他の考慮事項によって形成されます。こうした相互作用から生じる複雑な挙動こそが、自動運転車両にとって現実世界を非常に困難な環境にしている要因です。自動運転システムには、あらゆる状況、特に安全性が重要となる場面で優れた性能を発揮することが求められます。
このブログ記事では、マルチエージェント強化学習という刺激的な分野における最新研究の初期成果と、それがどのようにWayve Infinity Simulatorに現実世界を象徴する不可欠な要素である「創発的な挙動の複雑性」をもたらすのかを探ります。これにより、シミュレーションは運転知能モデルのパフォーマンスを評価し、私たちの道のりを加速させるための、これまで以上に強力なツールとなります。
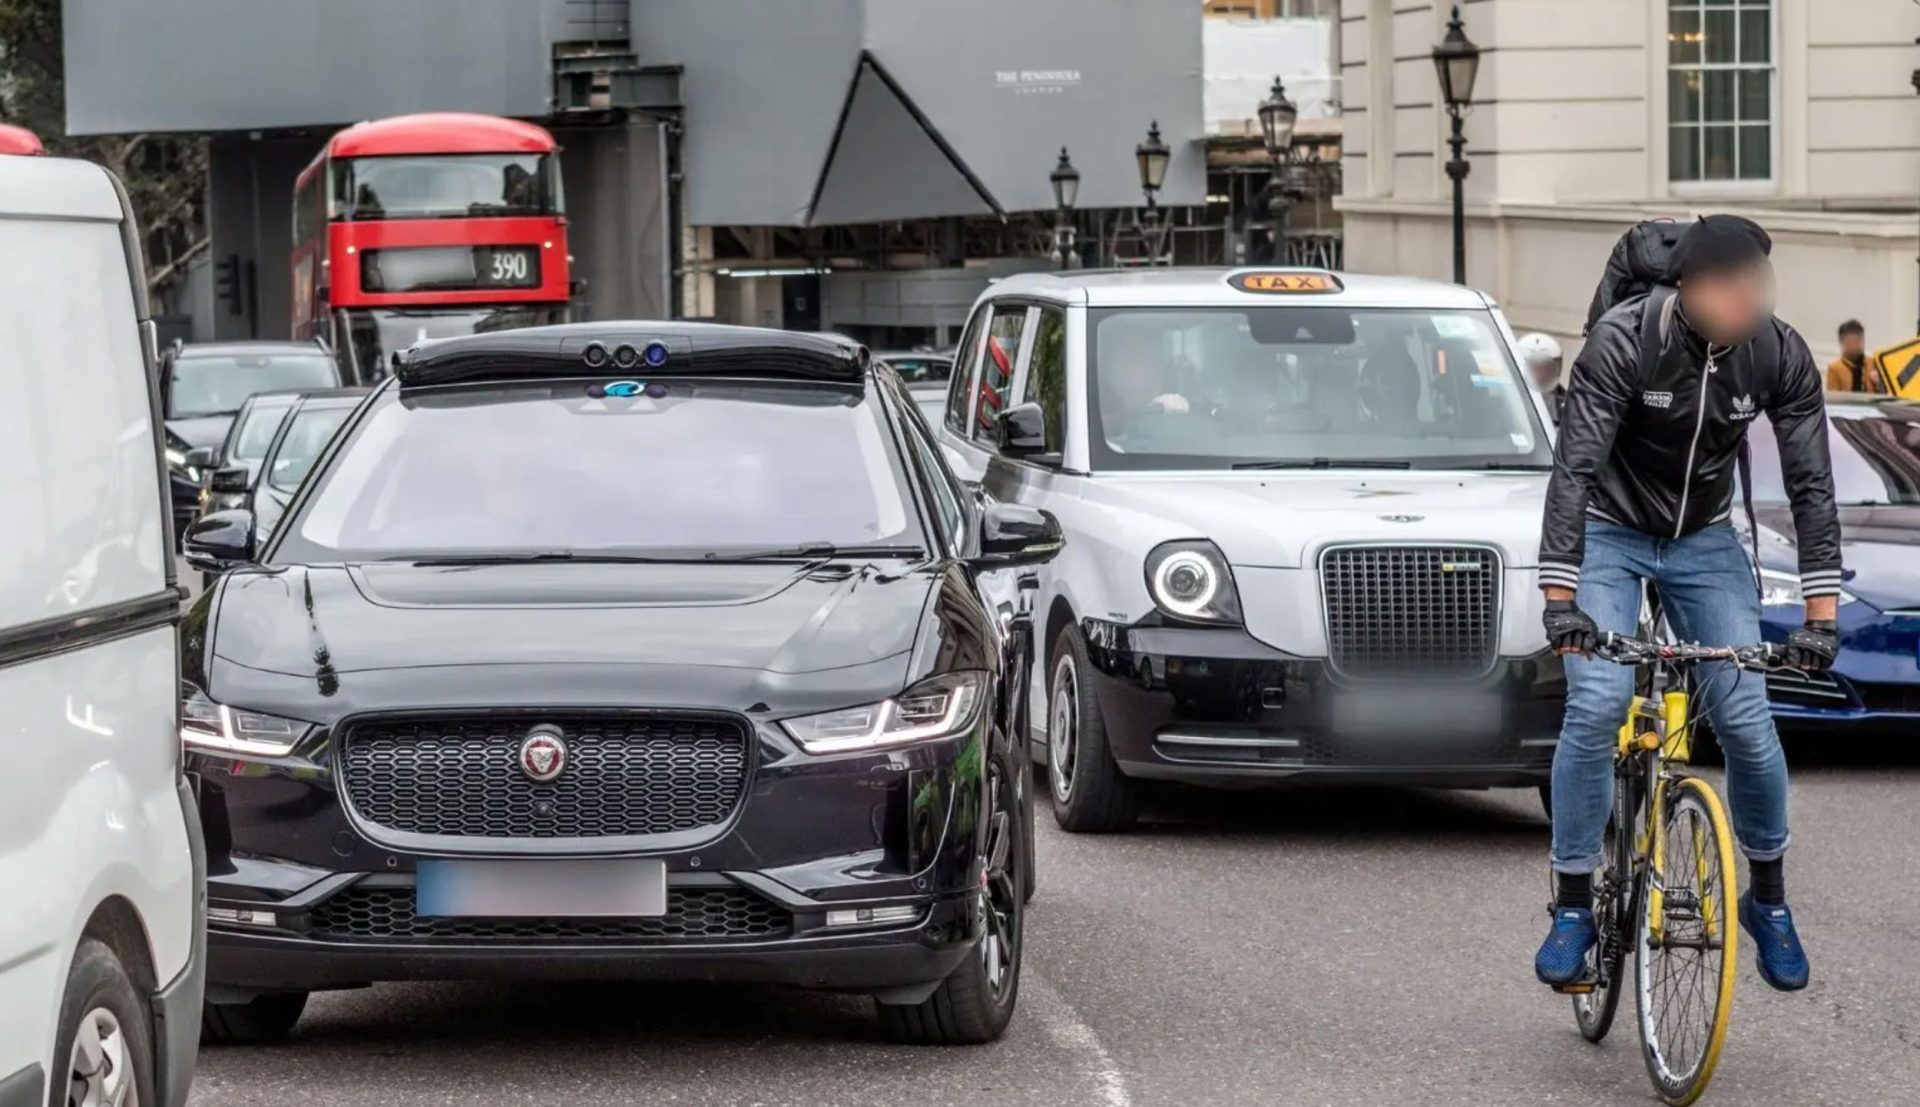
この挙動は、数百もの動的なアクター(「エージェント」)から生じます。各エージェントは、現実世界の目標、慣習、法律、安全性の考慮事項を近似した報酬信号に基づき、共有された世界でどのように行動するかを独立して決定します。
現実世界と同様に、当社のシミュレーターにも、優良なドライバーや未熟なドライバー、慎重なタイプや攻撃的なタイプ、法を遵守する者や違反する者など、多くのエージェントを配置する必要があります。
以下のビデオは、歩行者、乗用車、バス、交通弱者を含む、現実的な密度で他のエージェントが存在する環境を、学習済みの強化学習(RL)エージェントが走行する一人称視点の映像です。自車(エゴビークル)に加え、動的な交通のすべてが、RLで学習した多様なエージェント群によって制御されています。ビデオは実時間の2.5倍速で再生されています。
次のビデオは、道路上の歩行者に対するRLエージェントの反応性をストレステストするため、歩行者の活動密度を人為的に高めた環境で、学習済みRLエージェントが走行する一人称視点の映像です。ビデオは実時間の2.5倍速で再生されています。
ここでは、穏やかなRLエージェントと攻撃的なRLエージェントが混在し、様々な車や自転車を制御している混雑した交差点をシミュレートする様子をご覧いただけます。ここで示される挙動は必ずしも交通規則に従っているわけではありませんが、現実世界で遭遇する可能性のある良い運転行動と悪い運転行動の両方を描いています。このようなシーンを作成することで、運転モデルを評価するためのより困難な環境を構築できます。ビデオは実時間の2.5倍速で再生されています。
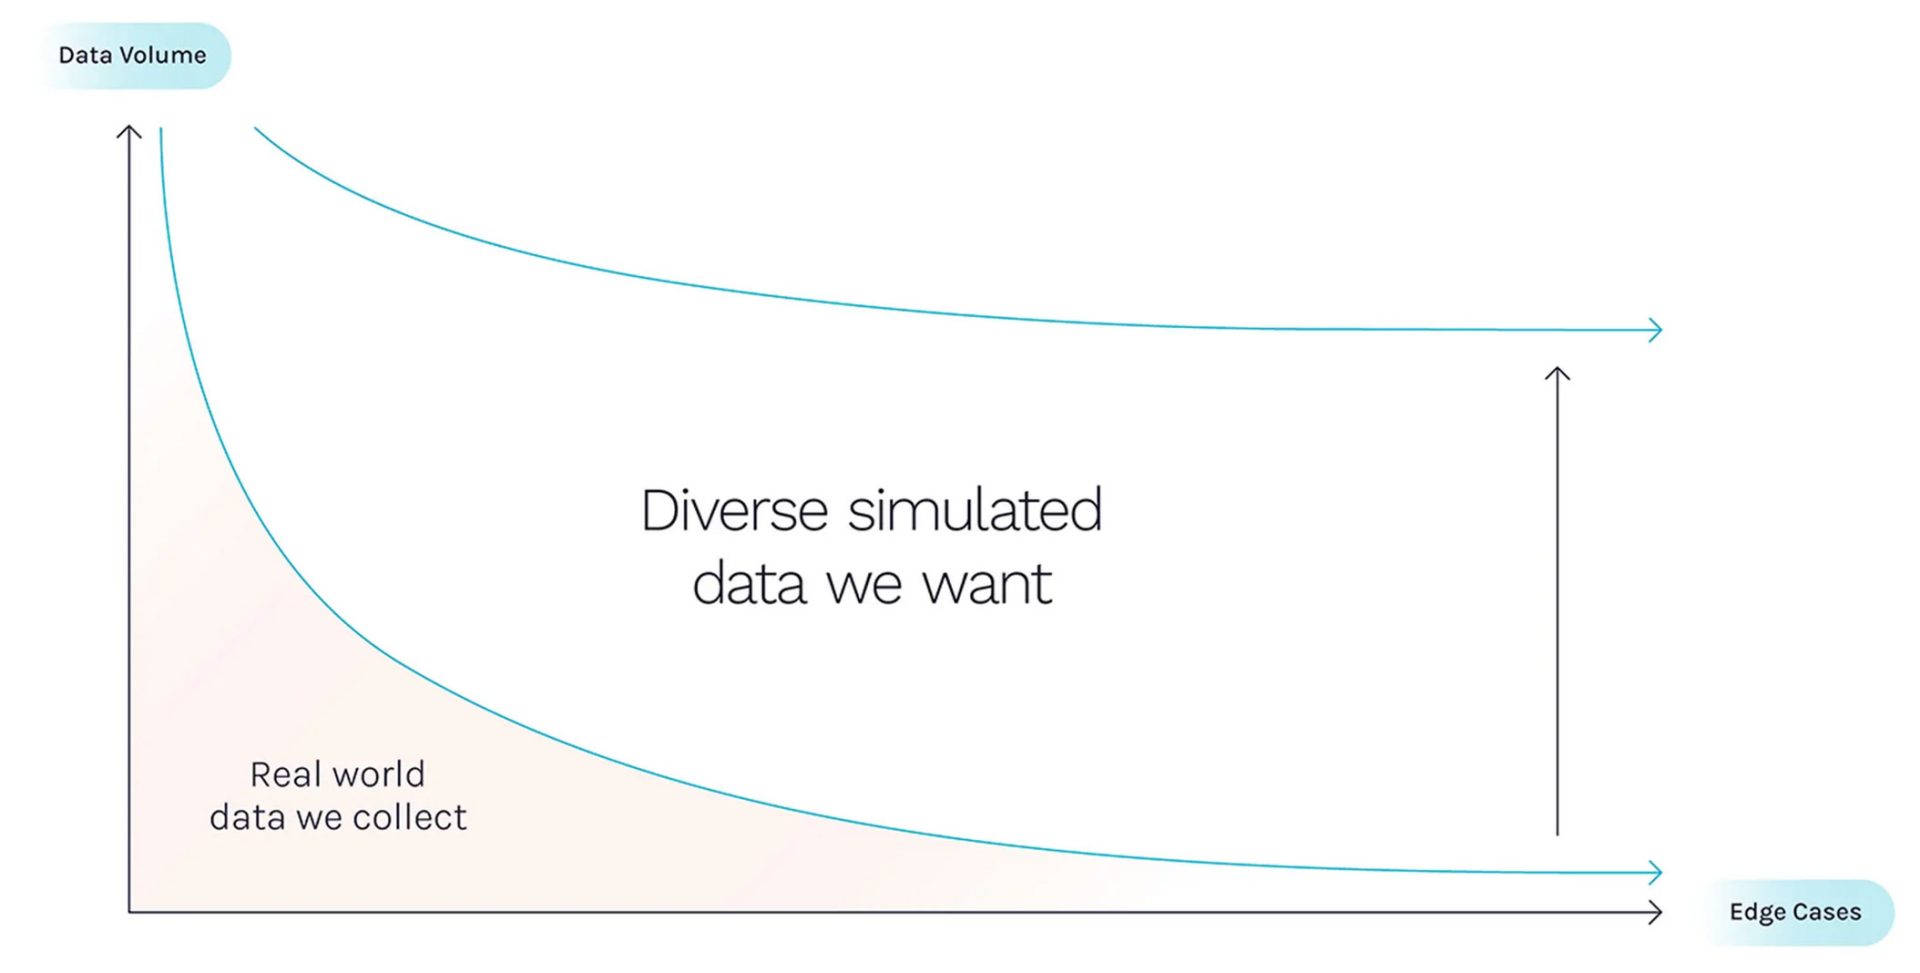
私たちは、エンドツーエンドで学習された運転モデルが、他の移動エージェントによって作り出される困難な状況を含め、あらゆる状況で適切に振る舞うことを望んでいます。人間のセーフティドライバーによる厳重な監視の下で、現実世界でモデルを評価することは、当社のテストパイプラインの最終段階です。しかし、その段階に至る前に、まずはシミュレーションでテストを行う必要があり、そのためにはシミュレーション内で多様な挙動を再現しなければなりません。エージェントの集団化は、良い運転と悪い運転の両方を網羅し、手作業でプログラムすることが不可能な、珍しく奇妙で稀なエッジケースである「ロングテール」を含む多様な挙動を効率的に生成するための鍵となります。
Wayveのアプローチ
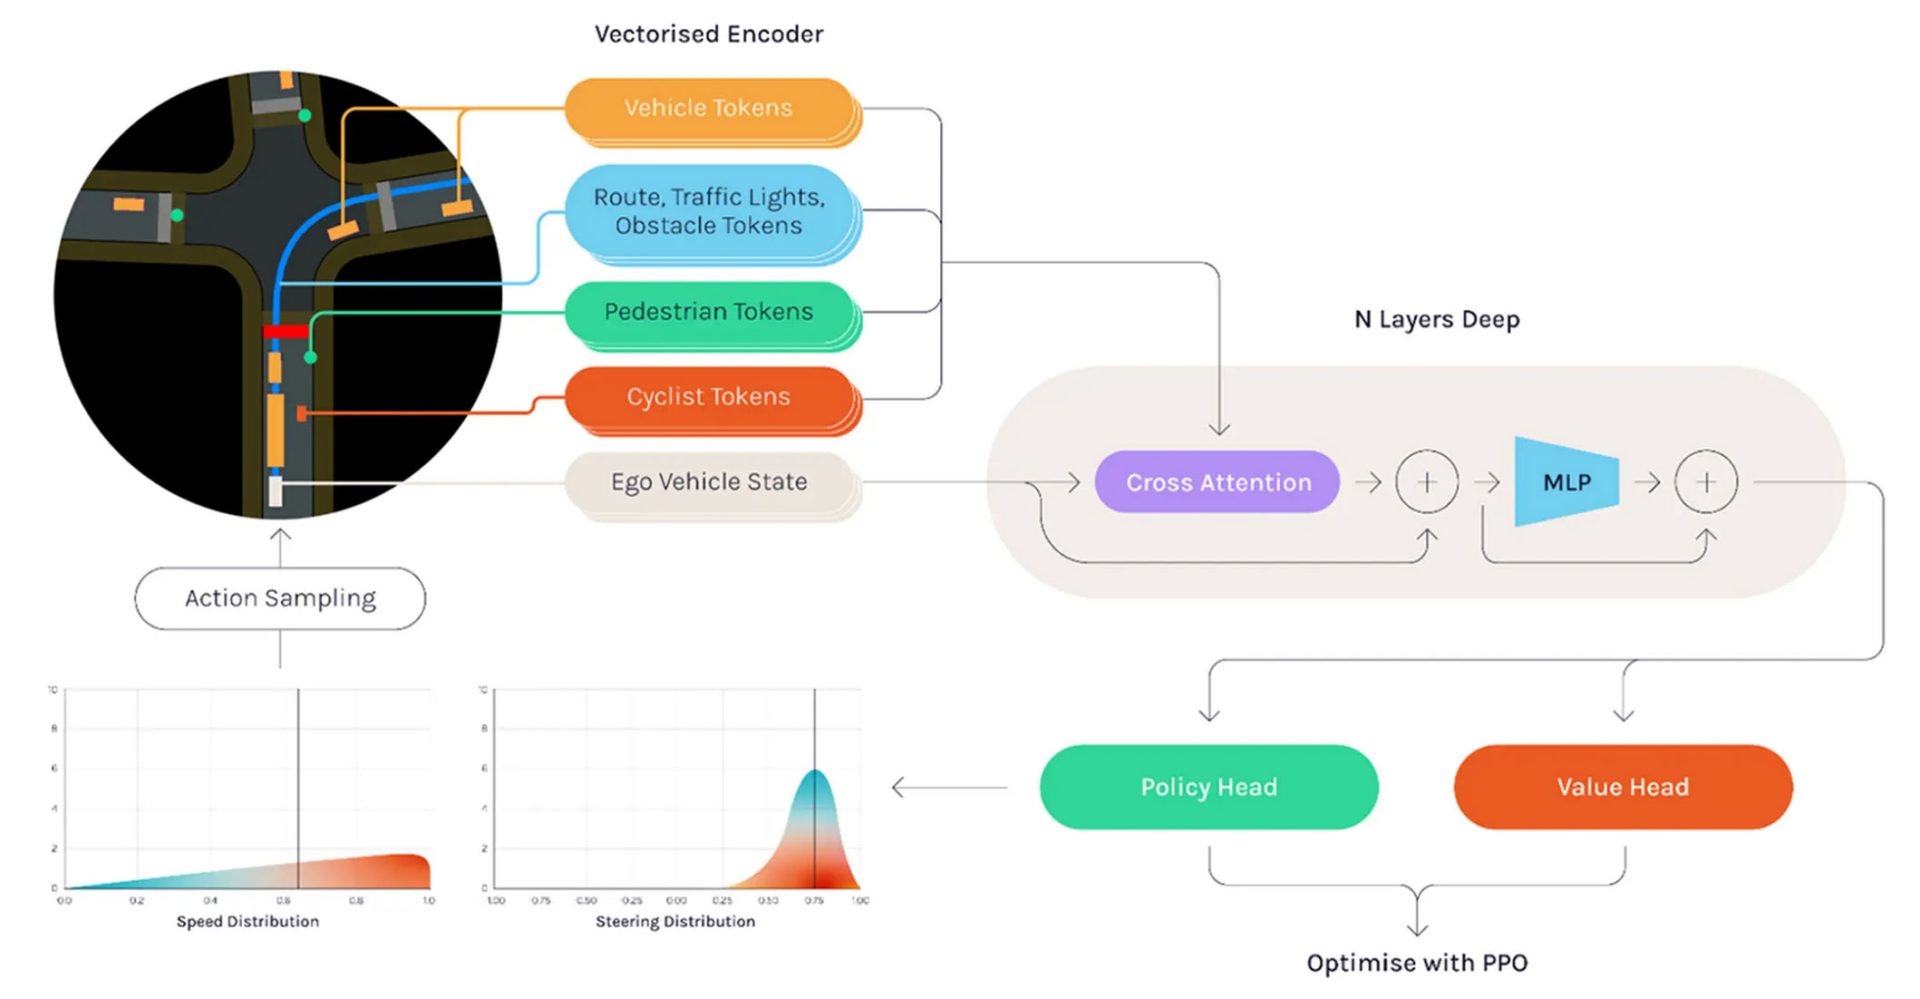
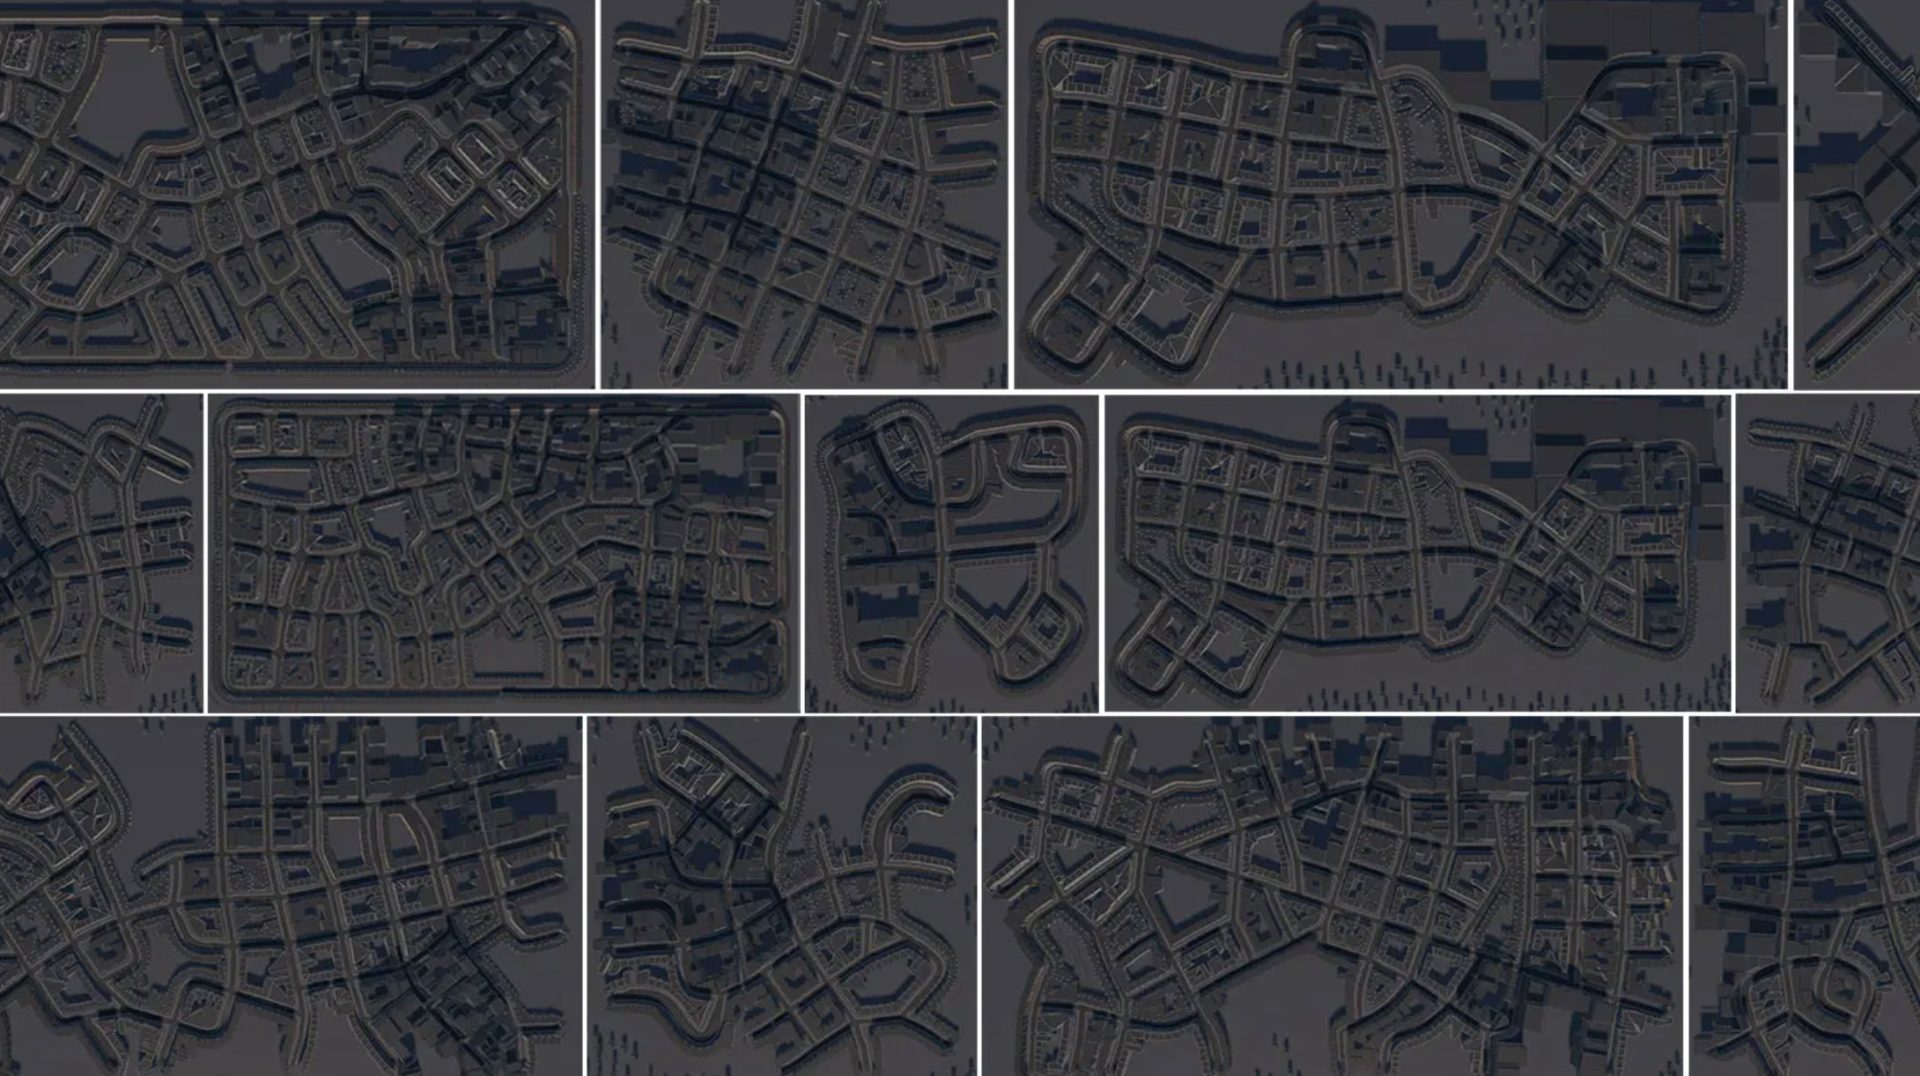
当社では、シミュレーション内の大半のエージェントを制御するために、強化学習で訓練された深層ニューラルネットワークを使用しています。エージェントは、行動に必要なすべての情報について「特権的」な情報を受け取ります。これには、静止障害物、信号機、近隣のエージェントの状態に関する完全な情報が含まれます。これにより、シーン全体をレンダリングする必要があるエージェントと比較して計算速度が大幅に向上し、環境ごとに数百のエージェントを効率的に実行できるようになります。各エージェントのニューラルネットワークは、Transformerアーキテクチャの高性能版であるPerceiverに着想を得たアーキテクチャを採用し、複数のクロスアテンションブロックに基づいています。このアーキテクチャを訓練するために、各エージェントのベースとなる強化学習アルゴリズムとして、広く普及しているPPOアルゴリズムの拡張版であるPhasic Policy Gradientを使用しています。報酬については、エージェントのタイプに応じて、シンプルながらも意味のあるものを手動で設計しています。
このビデオは、強化学習ポリシーを使用して数百のエージェントが街中をスムーズに走行している、大規模なシミュレーションタウンの俯瞰映像です。
当社は、マルチエージェント強化学習の最新の進歩を利用して、多様で高性能かつ現実的な挙動を実現するシミュレーションエージェントを作成しています。StarcraftやDotaのような対戦型ゲームに取り組んでいる他の研究グループは、多様な対戦相手と対戦するようにネットワークを訓練することが、人間を超えるパフォーマンスを達成するために不可欠であることを発見しました。しかし、人間が設計した既存のゲーム内での挙動を解決した従来の研究とは異なり、当社のアプローチでは世界そのものも構築する必要があります。
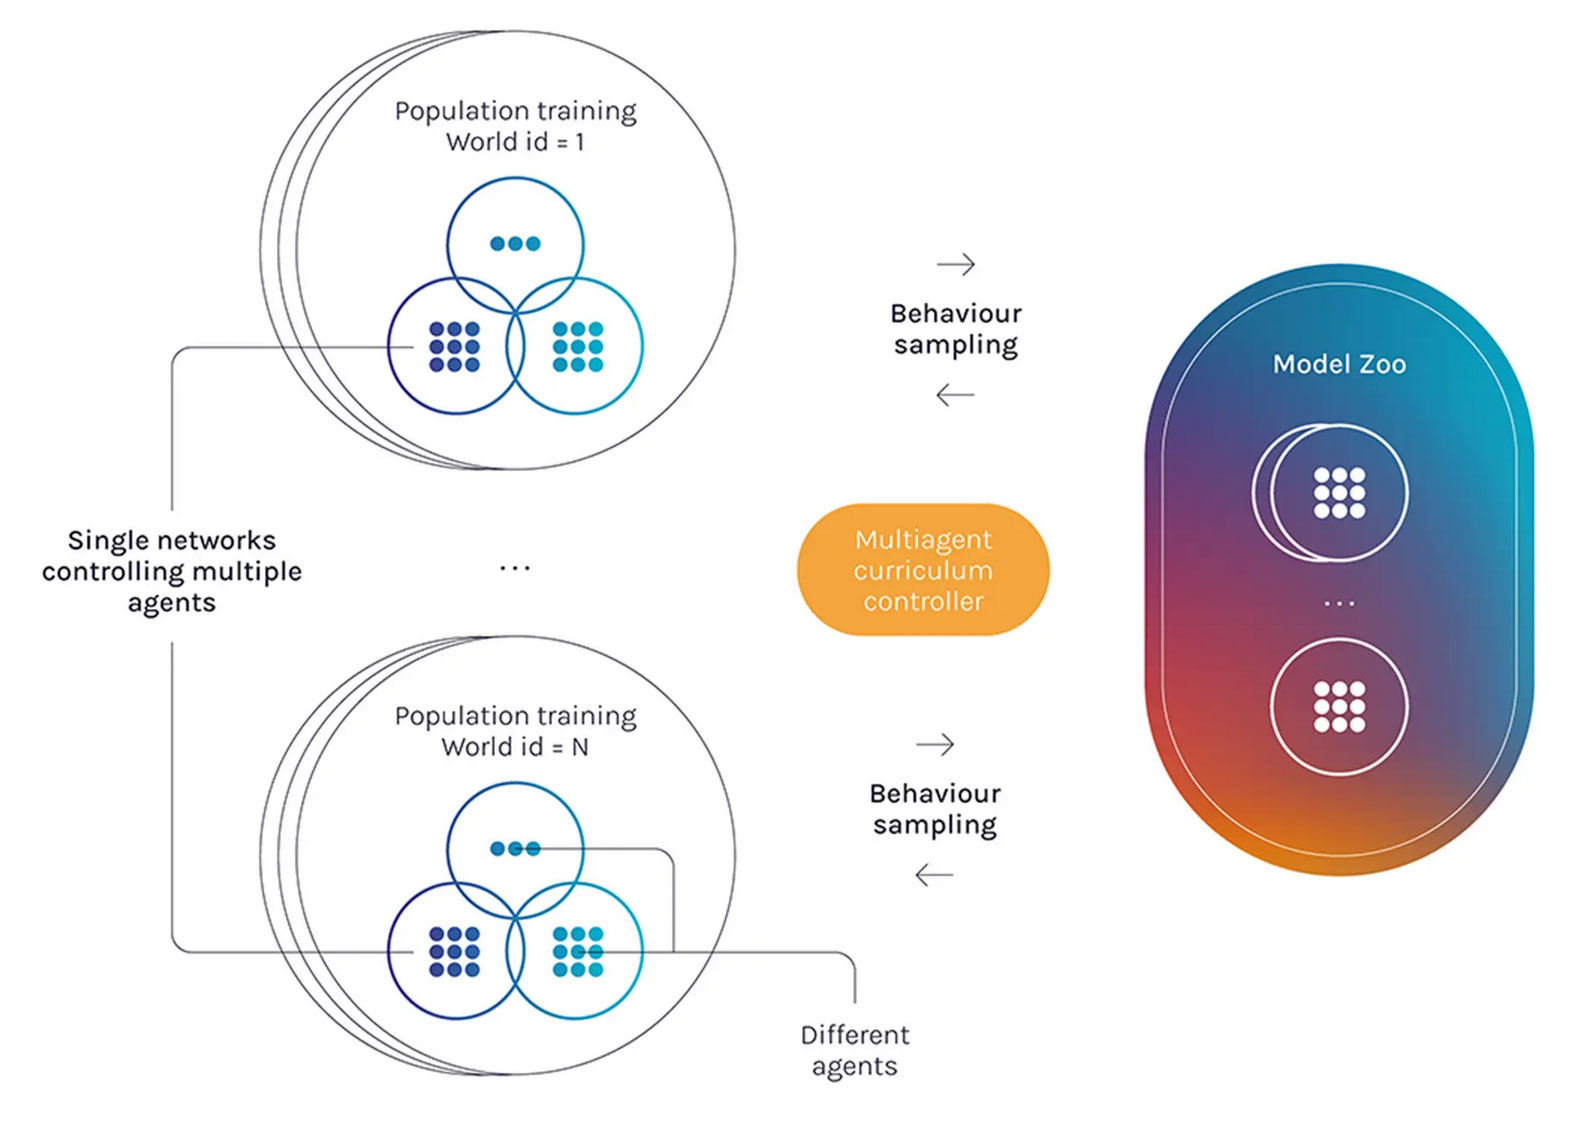
マルチエージェントのポピュレーションベースのアプローチを基盤として、多様性とリアリズムの目標に基づいて母集団をインテリジェントにサンプリングする訓練および評価スキームを作成しています。これにより、最適、希少、および敵対的なエージェントの比率を制御しながら、複雑さとリアリズムを段階的に高めた訓練カリキュラムを作成することが可能になります。
当社は、1環境あたり500以上のエージェントが存在する50の異なる世界で訓練を行っています。各世界の約20の異なるニューラルネットワーク(「モデルズー」)間でエージェントのポリシーを束ねることで、自動車とサイクリストを共同で訓練しています。(現在は適応的ではないランダム化された歩行者の挙動を使用していますが、将来的には強化学習のアプローチを歩行者の挙動にも拡張する予定です)。エージェントの動的特性、視覚的特性、および報酬特性を変化させることで、大規模で豊かなシミュレーションの全体的な複雑さをさらに高めています。また、マルチエージェント強化学習アプローチの複雑さをサポートするために大規模な分散計算インフラを構築し、多様な挙動のセットをゼロから1日足らずで訓練することを可能にしました。
その結果、運転環境として大幅に興味深いシミュレーション世界が実現しました。そこには多数の運転スキルやスタイルを持つエージェントが存在し、従来よりも現実世界に近い創発的な複雑さが生まれています。
評価
上述のように、複雑で創発的な挙動を大量かつ迅速に生成できるようになったことで、それを利用して運転知能モデルの品質を評価できるようになりました。これまでは、すべてのエージェントが世界に関する特権的なセンシングを使用するRLエージェントである世界について説明してきました。評価にあたっては、シミュレーション世界内のこれらのエージェントのうちの1つを、当社のエンドツーエンドニューラルネットワークに置き換えます。このエージェントは、特権を持たない、完全にシミュレートされたカメラやその他のセンサー入力を使用して走行します。周囲の他のエージェントは、前述の多様なRLエージェントによって制御されたままであり、運転知能をテストするための豊かで困難な反応型環境を提供します。
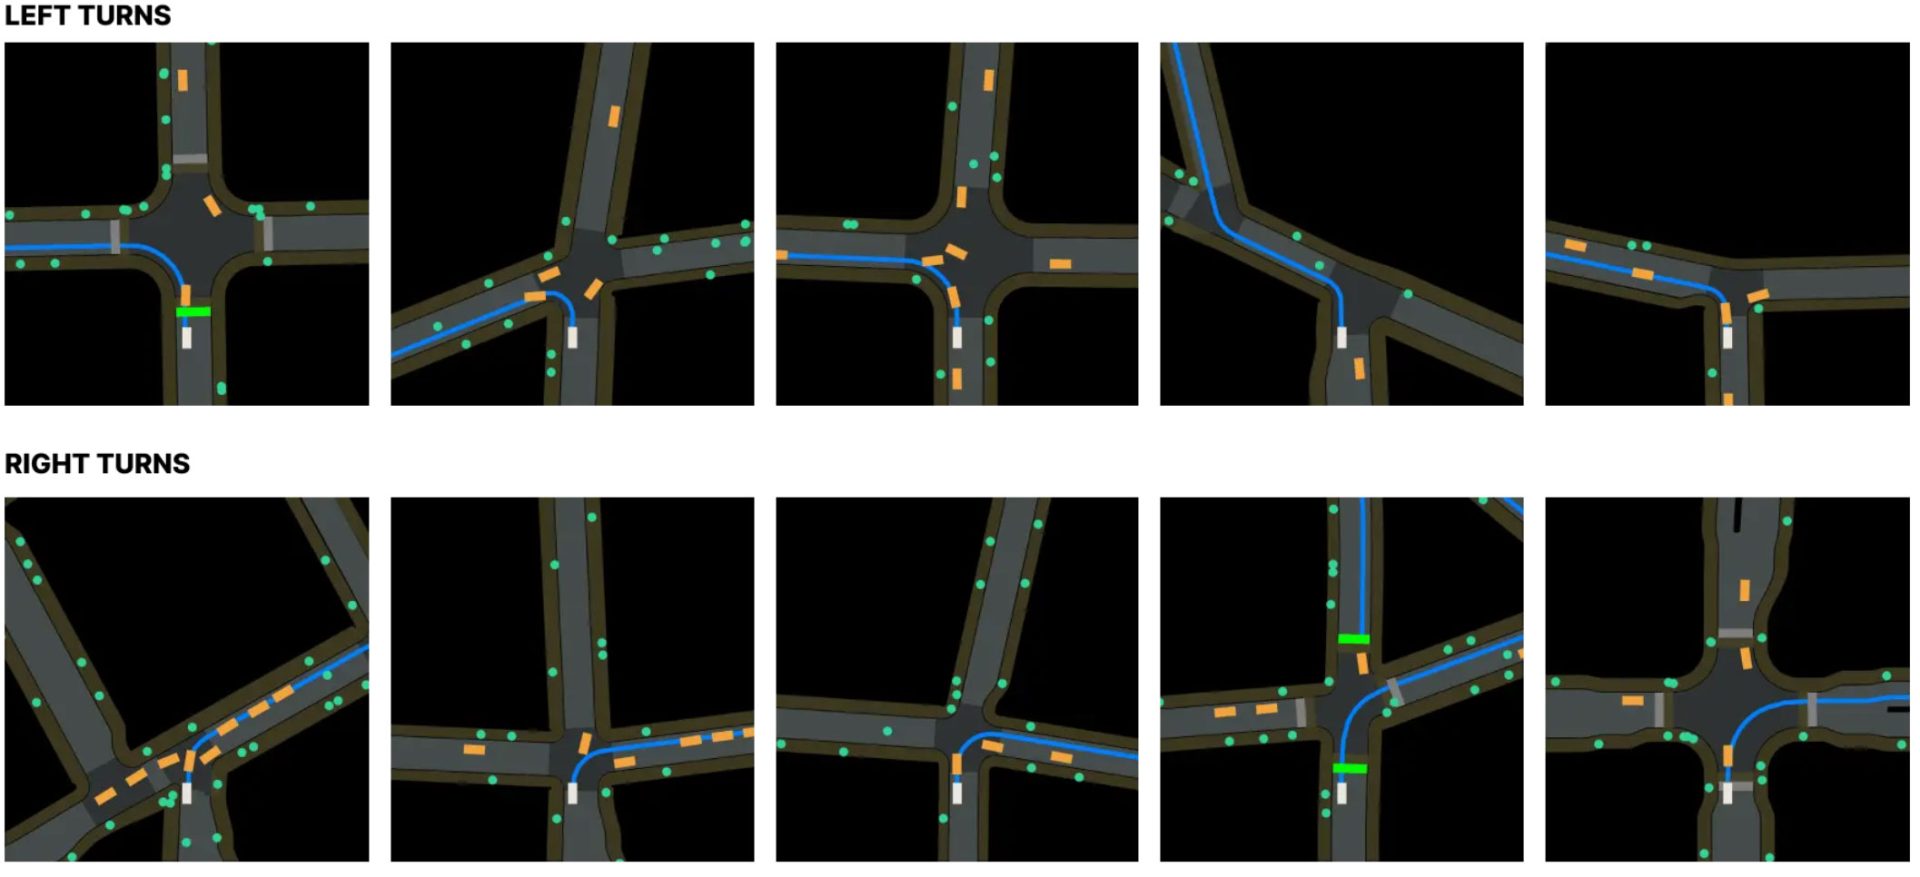
最も興味深い点は、評価のための膨大な範囲の「初期条件」(開始点)を低コストでサンプリングできるようになったことです。これらの初期条件を、関心のある特定の行動能力に合わせて簡単にフィルタリングできます。例えば、次の図は、生成可能な困難な評価ケースの多様性を示しており、左折または右折の能力でフィルタリングされています。これらの一つひとつが、当社のモデルを評価するための開始点となります。
今後の方向性
このアプローチで可能なことのほんの一部に着手したに過ぎず、さらなる拡張に向けて懸命に取り組んでいます。現実世界の多様性と複雑さに合わせるためには、乗客を乗せるために停車するバス、二重駐車している配送車両、予期せず開く車のドア、道路を横切る犬、デリバリースクーターなどを組み込む必要があります。現実世界の行動データセットを混合してリアリズムを高めることも、私たちが追求しているもう一つの研究方向です。マルチエージェント強化学習アプローチの素晴らしい点は、単一の学習フレームワークが、これらすべてのケースに効率的にスケールアップできる可能性を秘めていることです。
応用に加えて、強化学習アルゴリズムの収束の高速化、訓練の安定性と効率性の確保、そしてエージェントのリアリズムと多様性の測定を確実にするための基礎研究も進めています。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む