








5 11月 2018 | リサーチ
ディープラーニングによるコンピュータビジョンの進化
2015年に私たちがシーン理解の研究を開始した際、ディープラーニングを用いた初期のセマンティックセグメンテーション・アーキテクチャの一つであるSegNetを提案しました。しかし、わずか数年の間における最先端のシーン理解の進歩には目を見張るものがあります。2018年現在、単一のディープラーニングモデルから意味論(セマンティクス)、幾何学(ジオメトリ)、そして動きを理解できるようになりました。モデルの精度、堅牢性、パフォーマンスは以前よりも格段に向上しています。本ブログでは、シーン理解のためのディープラーニングの進展について考察し、新しい2018年版ウェブデモを公開します(以下を参照)。
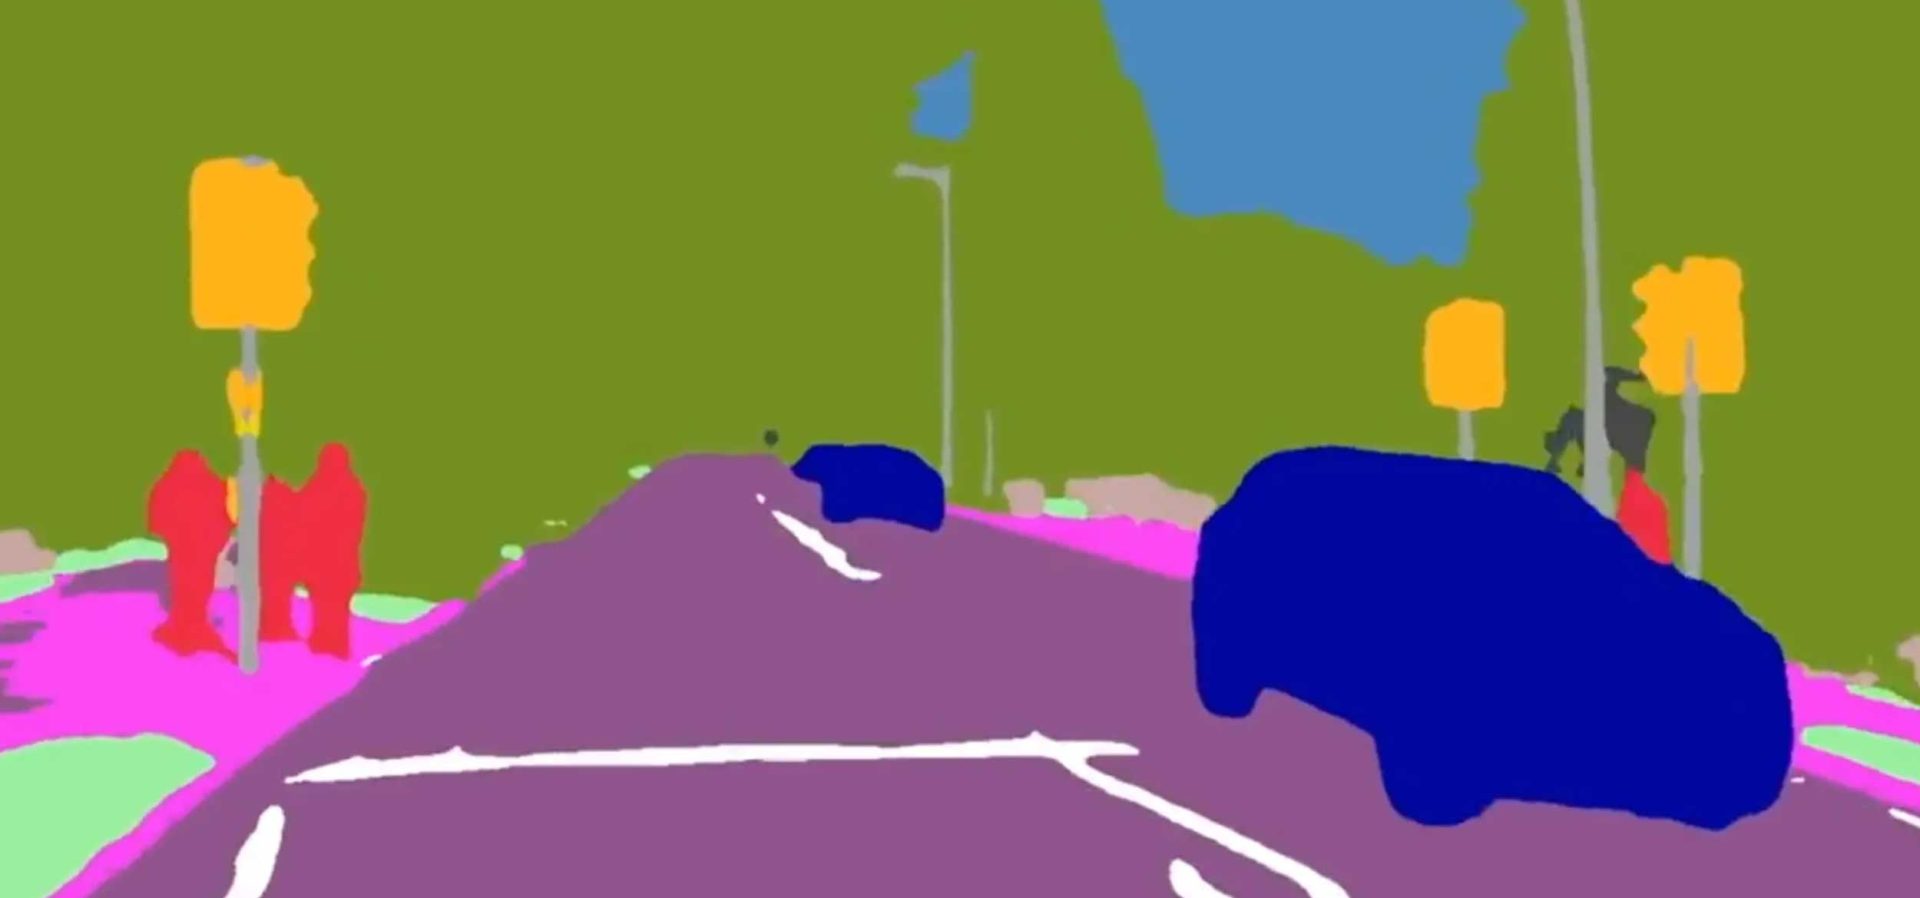
当社の新しいモデルは、入力されたビデオフィードを、意味論、幾何学、動きを表す単一の高次元テンソルにエンコードします。このテンソルを使用して、運転の意思決定を行うことができます。また、モデルが何を理解しているかを可視化するために、さまざまな出力にデコードすることも可能です。こちらの可視化では、以下を表示しています(左上から時計回り):
- 単眼フロントカメラからアルゴリズムへの入力ビデオフィード
- 各ピクセルのセマンティッククラスとシーンの空間配置を予測するセマンティックセグメンテーション
- 世界の動きを示すオプティカルフロー予測(色は動きの方向を、色の強度は動きの大きさを表す)
- 単一の単眼画像から予測されたシーンの幾何学的構造を示す単眼深度予測(ステレオカメラやLIDARは不使用)
これらのモデルが自動運転車両上でリアルタイムかつ堅牢に動作することも実証できます。このビデオでは、小型のモバイルGPU(NVIDIA Drive PX2)を使用し、当社の車両上で単一のディープラーニングアルゴリズムが25Hzでリアルタイム動作している様子を紹介しています。
コンピュータビジョンによるリアルタイムのシーン理解
今日のコンピュータビジョンで何が可能かをさらに詳しく説明するために、ウェブブラウザ上で(モバイル端末でも!)小規模なディープラーニングアルゴリズムをライブ実行するウェブデモを作成しました。ビデオ情報やLiDARスキャンを必要とせず、画像を3Dセマンティックポイントクラウドに変換します。
このウェブデモを制作するために、PyTorchで構築した認識モデルをKerasに変換し、さらにブラウザで直接実行できるようにKerasモデルをTensorFlow.jsに変換しました。その後、モデルの深度出力からポイントクラウドを生成し、深度値を3Dワールド空間に投影して、Three.jsでレンダリングしています。
次なるステップは?
ビジョンがインテリジェントなロボットの意思決定において真に普及するために、私たちは3つの主要な研究課題を強調したいと思います。
1. 世界に汎用化できる堅牢な表現
世界で遭遇するあらゆる可能性のある事例に対して、教師ありラベルに頼ることは不可能です。実世界のコンピュータビジョンシステムにとって最大の課題の一つは、限られたデータから、未知の状況にも汎用化できる表現を効率的に学習することです。これは自動運転において特に顕著であり、存在する道路シーンの多様性は膨大です。自己教師あり学習、マルチタスク学習、シミュレーションなど、堅牢な表現を学習するための有望なアプローチが数多く存在します(これについては近日中に詳しく説明します!)。
2. 認識と行動の統合
私たちは、タスクを達成するために認識アルゴリズムと意思決定アルゴリズムを共同で最適化することから、最も効果的なシステムが生まれると考えています。現在、これらのシステムは別々に検討されることが多いのが現状です。エンジニアは、3D物体検出や車線セグメンテーションなど、あらかじめ定義された世界の表現を抽出するための認識システムを構築しようとします。
しかし、それだけではおそらく不十分です。他車両の位置や向きだけでなく、その挙動、意図、ウィンカー、その他多くの微妙な手がかりを理解する必要があります。これらの状態をハンドエンジニアリング(手動設計)で表現することは極めて困難です。認識システムは、複雑でおそらく高次元な状態を学習する必要があり、セマンティクス、動き、ジオメトリを表現する必要があります。
3. 自動運転およびモバイルロボティクスへの応用
ロボティクスプラットフォームにコンピュータビジョンシステムを導入することは、多くの安全上の課題をもたらします。これらのアルゴリズムを力まかせのテストによって開発・検証することはできません。代わりに、不確実性を定量化し、意思決定における重要性(サリエンス)を理解し、中間表現を解釈し、複数のセンサーを用いてリアルタイムで推論を行う必要があります。
また、私たちは精度よりも堅牢性を重視しています。例えば、人間が運転する場合、他車の位置をミリ単位で知る必要はありません。単に車を検知できるかどうか、そしてシーン内での大まかな空間配置が分かれば十分です。私たちが構築するアルゴリズムも同様で、LiDARレーザースキャナーによるミリ単位の正確なジオメトリよりも、堅牢性を重視しています。
結論
ここ数年で、コンピュータビジョン技術は実環境で堅牢に動作するレベルまで成熟しました。私たちは、カメラのみによる認識が未来のインテリジェントロボットを動かすことになると確信しています。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む