








5 9月 2018 | リサーチ
運転を夢見る
白昼夢を見ている間、人間は過去の要素を再結合することで、起こりうる将来の経験をシミュレートすると考えられています。これは想像力として知られています。 想像力は過去の経験の正確な再現ではなく、世界がどのように機能するかという私たちのモデルを考慮すると、新しく実現可能なもののシミュレーションです。神経科学では、この仮説は構成的エピソードシミュレーション(Schacter & Addis, 2007)として知られており、新しいスキルを学ぶ上で重要な役割を果たすと考えられています。このプロセスにおける重要な仕組みは、世界に対する私たちの内部的な予測モデルです。幼い頃から、人間は実データから世界の内的なシミュレーター(予測モデル)を学習します。私たちの脳は、このシミュレーターを使って、ボールをキャッチすることから複雑なセーターを編むことまで、あらゆる種類のタスクを実行することを学習します。
この投稿では、予測と想像力というこれらのアイデアを、車に自動運転を教えるためにどのように使用するかを示します。
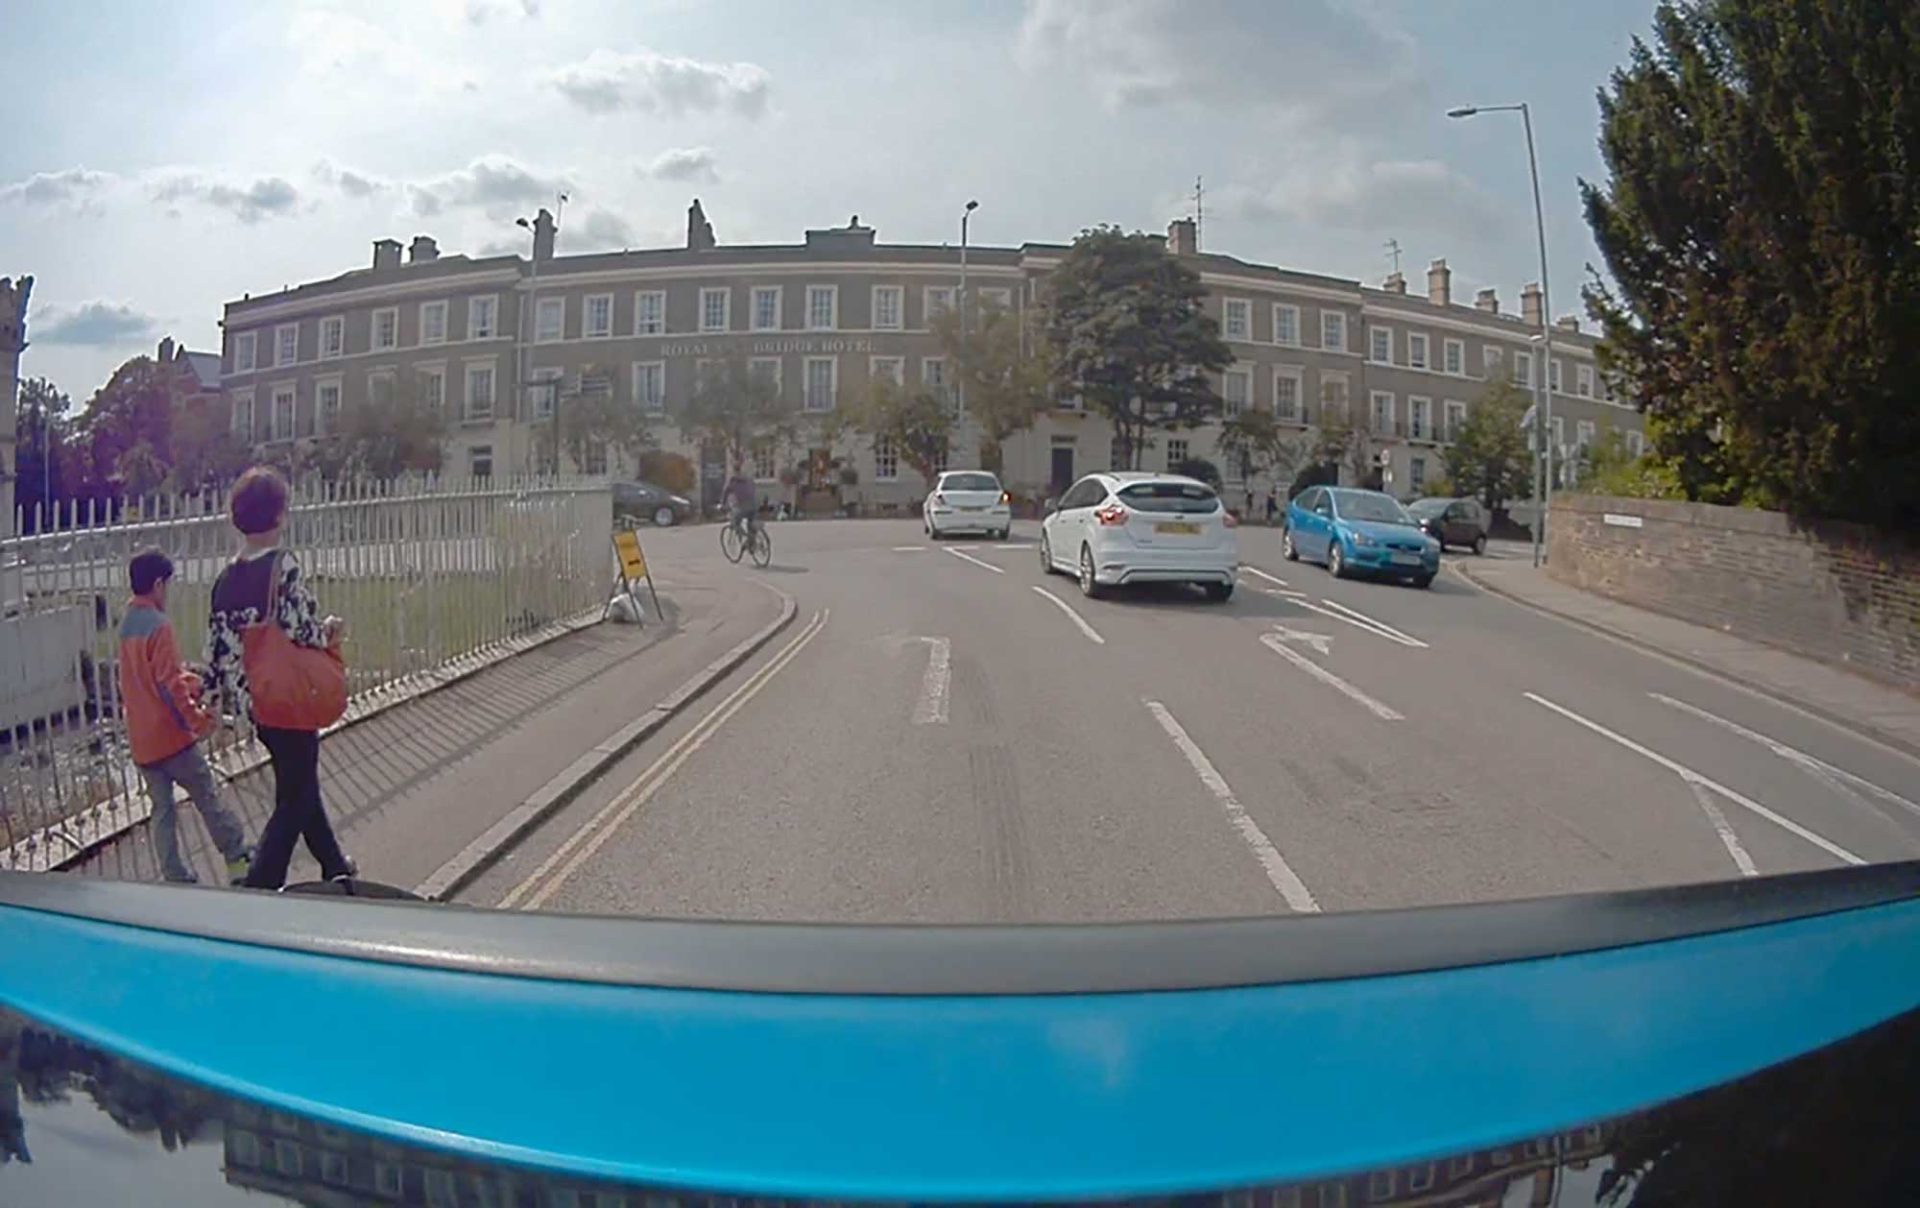
車の運転についてはどうでしょうか?
上のシーンをご覧ください。この静止画に基づいて、この瞬間にどのように加速し、ブレーキをかけますか?言うのはほとんど不可能です!前の車は加速していますか?減速していますか?時間的な情報を追加してみましょう。
ここで私たちの予測モデルが本格的に機能し始めます。私たちはシーン内の関連する他のエージェントの動きを観察し、彼らがどこに向かっているかを予測し、情報に基づいた運転の意思決定を行います。遠くの車について心配する必要はありません。それらは私たちの短期的な意思決定に影響を与えません。人間が複雑な都市のシーンで運転するのが得意なのは、動きを予測し、関連することに焦点を当て、そうでないものを無視する能力があるからです。
晴天時のデータのみで訓練されたにもかかわらず、同じシステムが雨天時でも正常に走行できます(注:牛よけ柵を横断中にステアリングモーターのトルク安全限界を超え、介入が必要となりました)。
運転の意思決定に関連することに焦点を当てることで、当社のシステムは水たまりによる反射やカメラレンズ上の水滴に気を取られることはありません。実際、運転に関連することのみに焦点を当てることが、当社の手法を訓練中に見られなかった新しい状況にも適用可能にするものと信じています。
当社のシステムをどのように訓練したかの概要を以下に示します。まず、収集されたデータで予測モデルを訓練します。
私たちは車に夢の中で運転するように訓練しました
完全に想像力の中で訓練された強化学習システムが実世界で車を運転する
この車は、モデルベースの深層強化学習システムによって運転されています。このアルゴリズムは、オフラインで収集された実世界データから予測モデルを学習します。これにより、モデルは予測モデルによって想像された新しいシナリオを使用して運転を学習できます。私たちが採用した訓練パイプラインは、自律走行車に単眼カメラ入力を使用して、World Models (Ha & Schmidhuber, 2018)に基づいていました。
私たちは、この夏のケンブリッジでの熱波の間に、晴れた明るい日に収集されたデータでシステムを訓練しました。以下に、収集したランダムな運転エピソードの例を示します。
私たちのモデルはこれまで雨を見たことがありませんでした
それにもかかわらず、システムは最近の夏の雨嵐の間も問題なく機能しました。
晴天時のデータのみで訓練されたにもかかわらず、同じシステムが雨天時でも正常に走行できます(注:牛よけ柵を横断中にステアリングモーターのトルク安全限界を超え、介入が必要となりました)。
運転の意思決定に関連することに焦点を当てることで、当社のシステムは水たまりによる反射やカメラレンズ上の水滴に気を取られることはありません。実際、運転に関連することのみに焦点を当てることが、当社の手法を訓練中に見られなかった新しい状況にも適用可能にするものと信じています。
当社のシステムをどのように訓練したかの概要を以下に示します。まず、収集されたデータで予測モデルを訓練します。
これはシーケンスモデリングタスクです。変分オートエンコーダを使用して画像を低次元の状態にエンコードします。次に、現在の状態と行動が与えられた場合に次の確率的状態を推定する予測モデルを形成する確率的リカレントニューラルネットワークを訓練します。エンコーダと予測モデルは実世界データで訓練します。
次に、運転ポリシーを初期化し、シミュレートされた経験で予測モデルを使用してどのように機能するかを評価します。
多くのシミュレートされたシーケンスにわたって、経験を想像することで訓練できます。訓練中には、学習されたポリシーを観察するために想像されたシーケンスを視覚化することもできます。
最初のアニメーションは、未訓練のポリシーが運転を想像している様子を示しています。予測モデルが、この未訓練のポリシーが道路から逸脱すると想像していることがわかります。対照的に、2番目のアニメーションは、道路のカーブをうまく想像して運転できる完全に訓練されたポリシーを示しています。
私たちは、多くの想像された運転シーケンスを通じて、運転を夢見ることでポリシーを改善し、どんどん上達させています。
私たちのアルゴリズムは運転を夢見、夢を見るたびに上達します
データ駆動型シミュレーターを学習することは、手作業で設計するよりも計算上も統計上もスケーラブルです。私たちの「1日で運転を学習する」という研究では、単一のロボットカーの限られたオンボード計算を使用して、探索と最適化を繰り返しました。しかし、予測モデルを使用することで、ロボット車両とは独立して、大規模並列サーバーで運転を夢見ることができます。さらに、従来のシミュレーションアプローチでは、幅広い運転シナリオをカバーするために、人々が個々の状況を手作業で設計する必要がありました。データから予測モデルを学習する私たちのアプローチは、シナリオ生成のプロセスを自動化し、人間のエンジニアをループから外します。
通常、シミュレーターのソリューションと実世界の間には外観と挙動にずれがあり、シミュレーションで得られた知識を直接活用することは困難です。私たちのシステムにはこの制限がありません。実世界データで直接訓練しているため、シミュレーションと実世界の間にはほとんど違いがありません。
最後に、学習されたシミュレーターは微分可能であるため、勾配降下法を使用して運転ポリシーを直接最適化できます。
この投稿で概説したフレームワークには、強力な時間的予測モデルが必要です。これまでのコンピュータビジョン研究はまだ表面をなぞったに過ぎませんが、エキサイティングな未来が待っています。
以下は、運転シーンの外観、セマンティクス、およびジオメトリが3秒間にわたってどのように進化するかをモデルが予測する例です。
Wayveは、より豊かで堅牢な時間的予測モデルの開発に尽力しており、これがインテリジェントで安全な自動運転車を構築するための鍵であると信じています。
謝辞
素晴らしいロボット車両を構築してくれたStreetDrone、車両試験の保険を提供してくれたAdmiral、そして自動運転研究のために私有地へのアクセスを許可してくれたケンブリッジポロクラブに感謝いたします。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む