








20 10月 2020 | エンジニアリング
自律走行性能の測定。第2部:大規模なシナリオベース評価
詳細なシナリオベース評価
第1部では、きめ細かく、一貫性があり、自動化されたメトリクスがなぜ重要なのか、そしてそれが全体の自律走行性能の段階的な改善にどのように役立つかについて議論しました。そこで、メトリクスをより詳細に定義する方法を見ていきましょう。
当社の運用設計領域(ODD)内では、変動性の主要な3つの側面を定義しています。
- 景観 – 道路の配置、交通ルール、街路装飾など、世界の静的な属性
- 環境 – 天候や照明条件など、世界の変動する属性
- 動的要素 – 他の車両、歩行者、自転車など、シーン内の他のエージェント
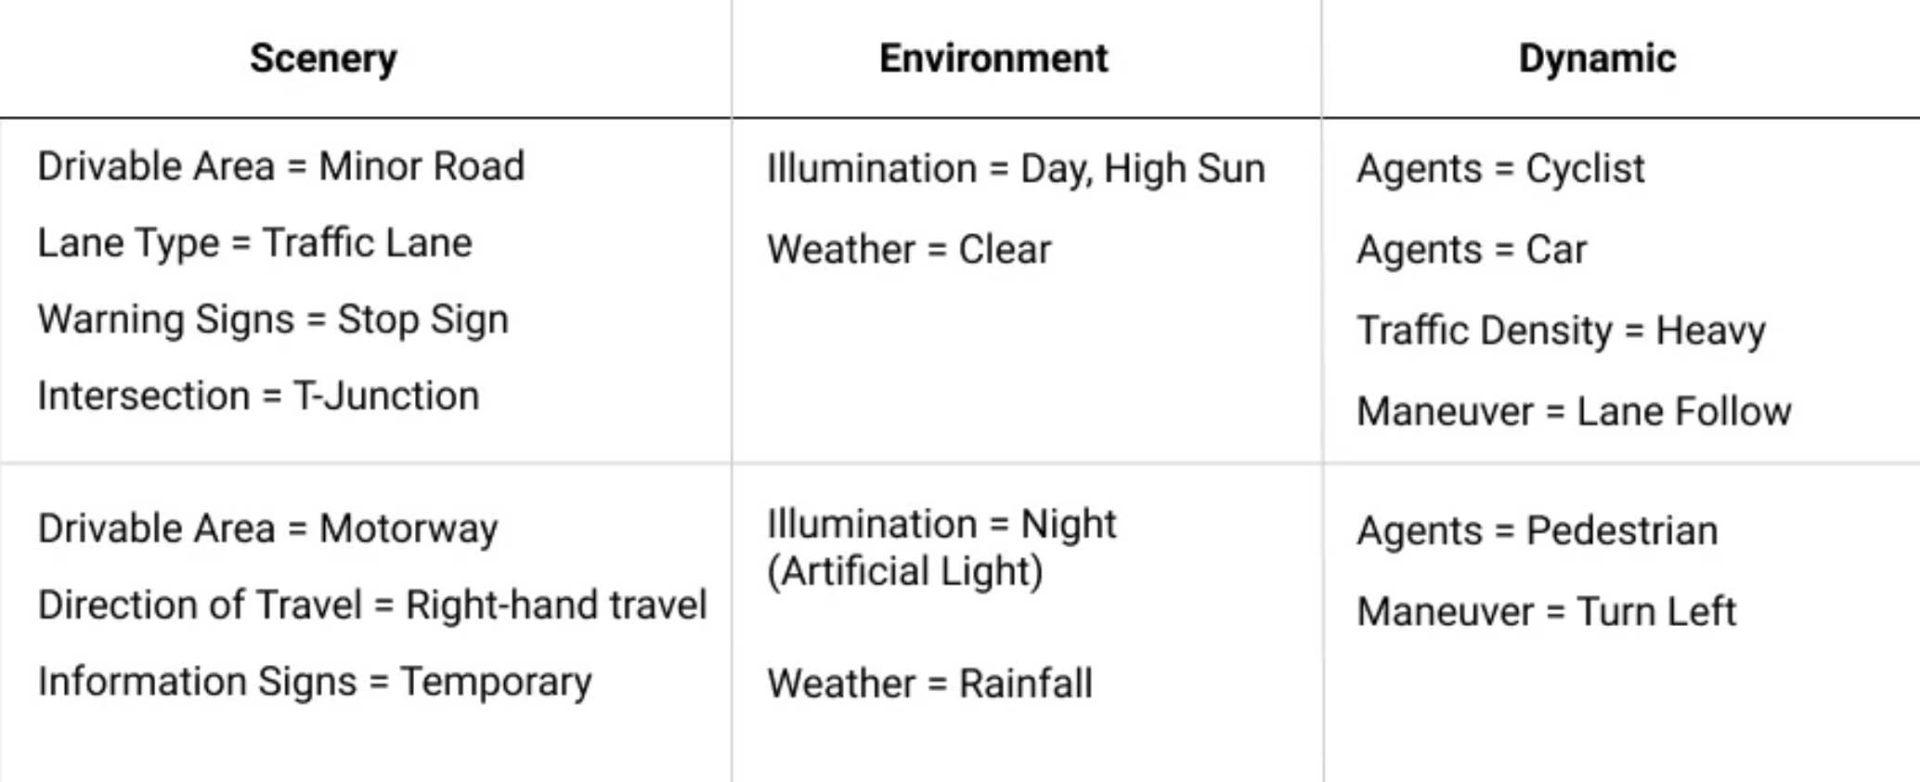
これらのラベルは、ある時点または静的なシーンを観察する際には直感的に理解できます。しかし、運転は継続的な活動であるため、これらのラベルを時間経過とともに運転データ全体に適切に適用する必要があります。
記録された運転ログ内のすべてのフレームにラベルを付けた場合に何が起こるかを示します。
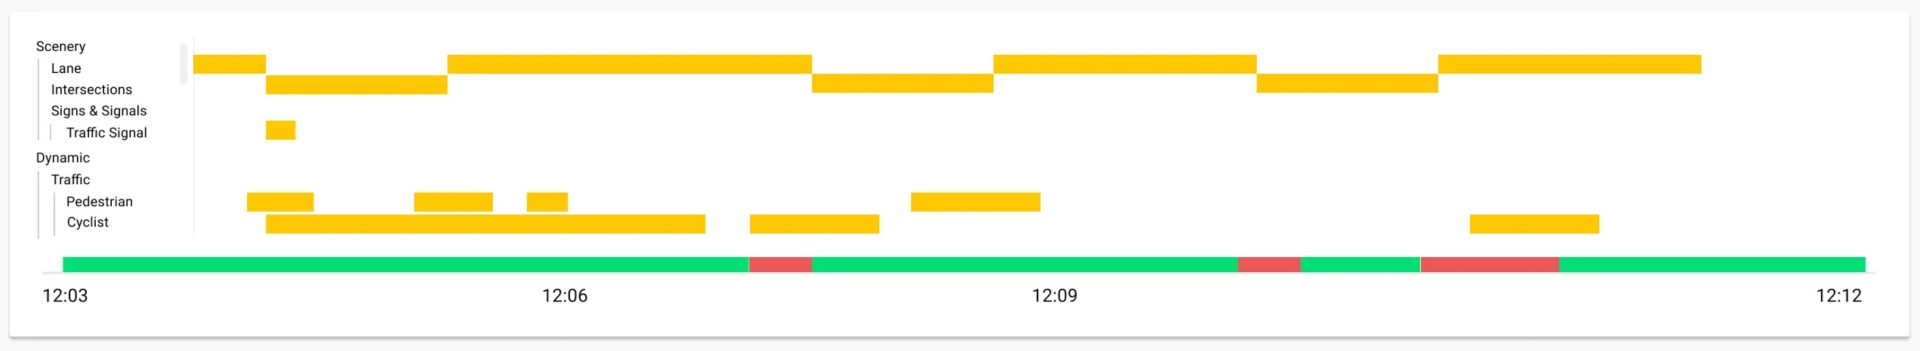
これで、シーン内で何がいつ発生したかをかなり正確に把握できました。最後のステップは、これを自律走行の品質評価に使用できるスコアに変換することです。
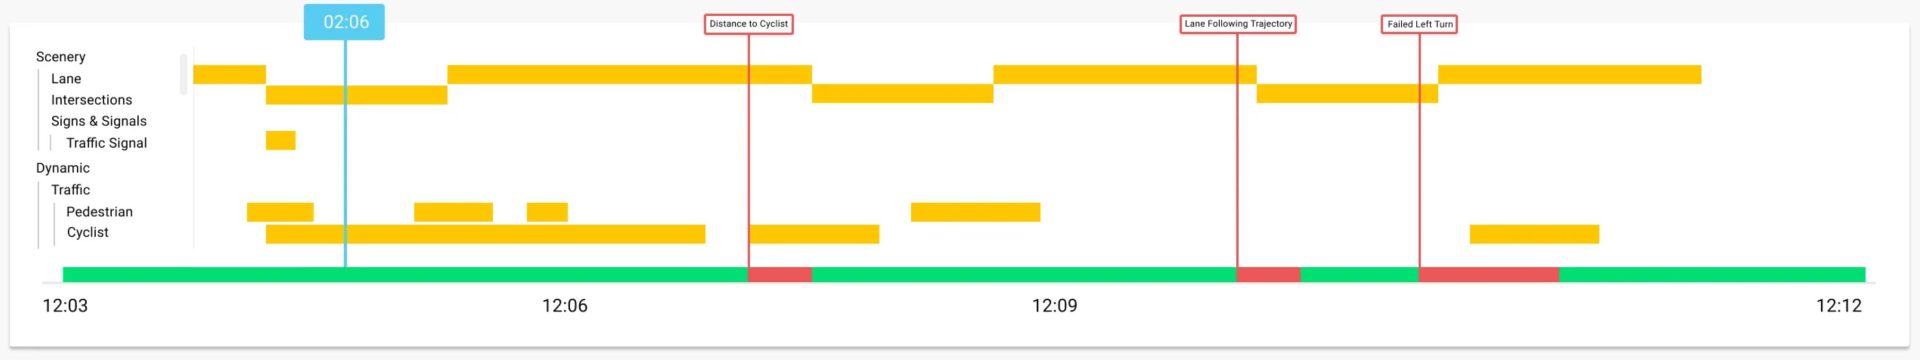
当社の自律走行試験では、システムが正しく動作しない場合、当社のセーフティドライバーが介入します。この介入データをシナリオラベルの上に重ね合わせることで、障害発生時(および障害発生前後の両方)の世界の状態を明確に把握できます。
時間セグメント中に介入がない場合、そのシナリオは成功裏に完了した試行と見なすことができます。同様に、介入が時間セグメント内に発生した場合、それは特定のODD項目における失敗と見なされます。
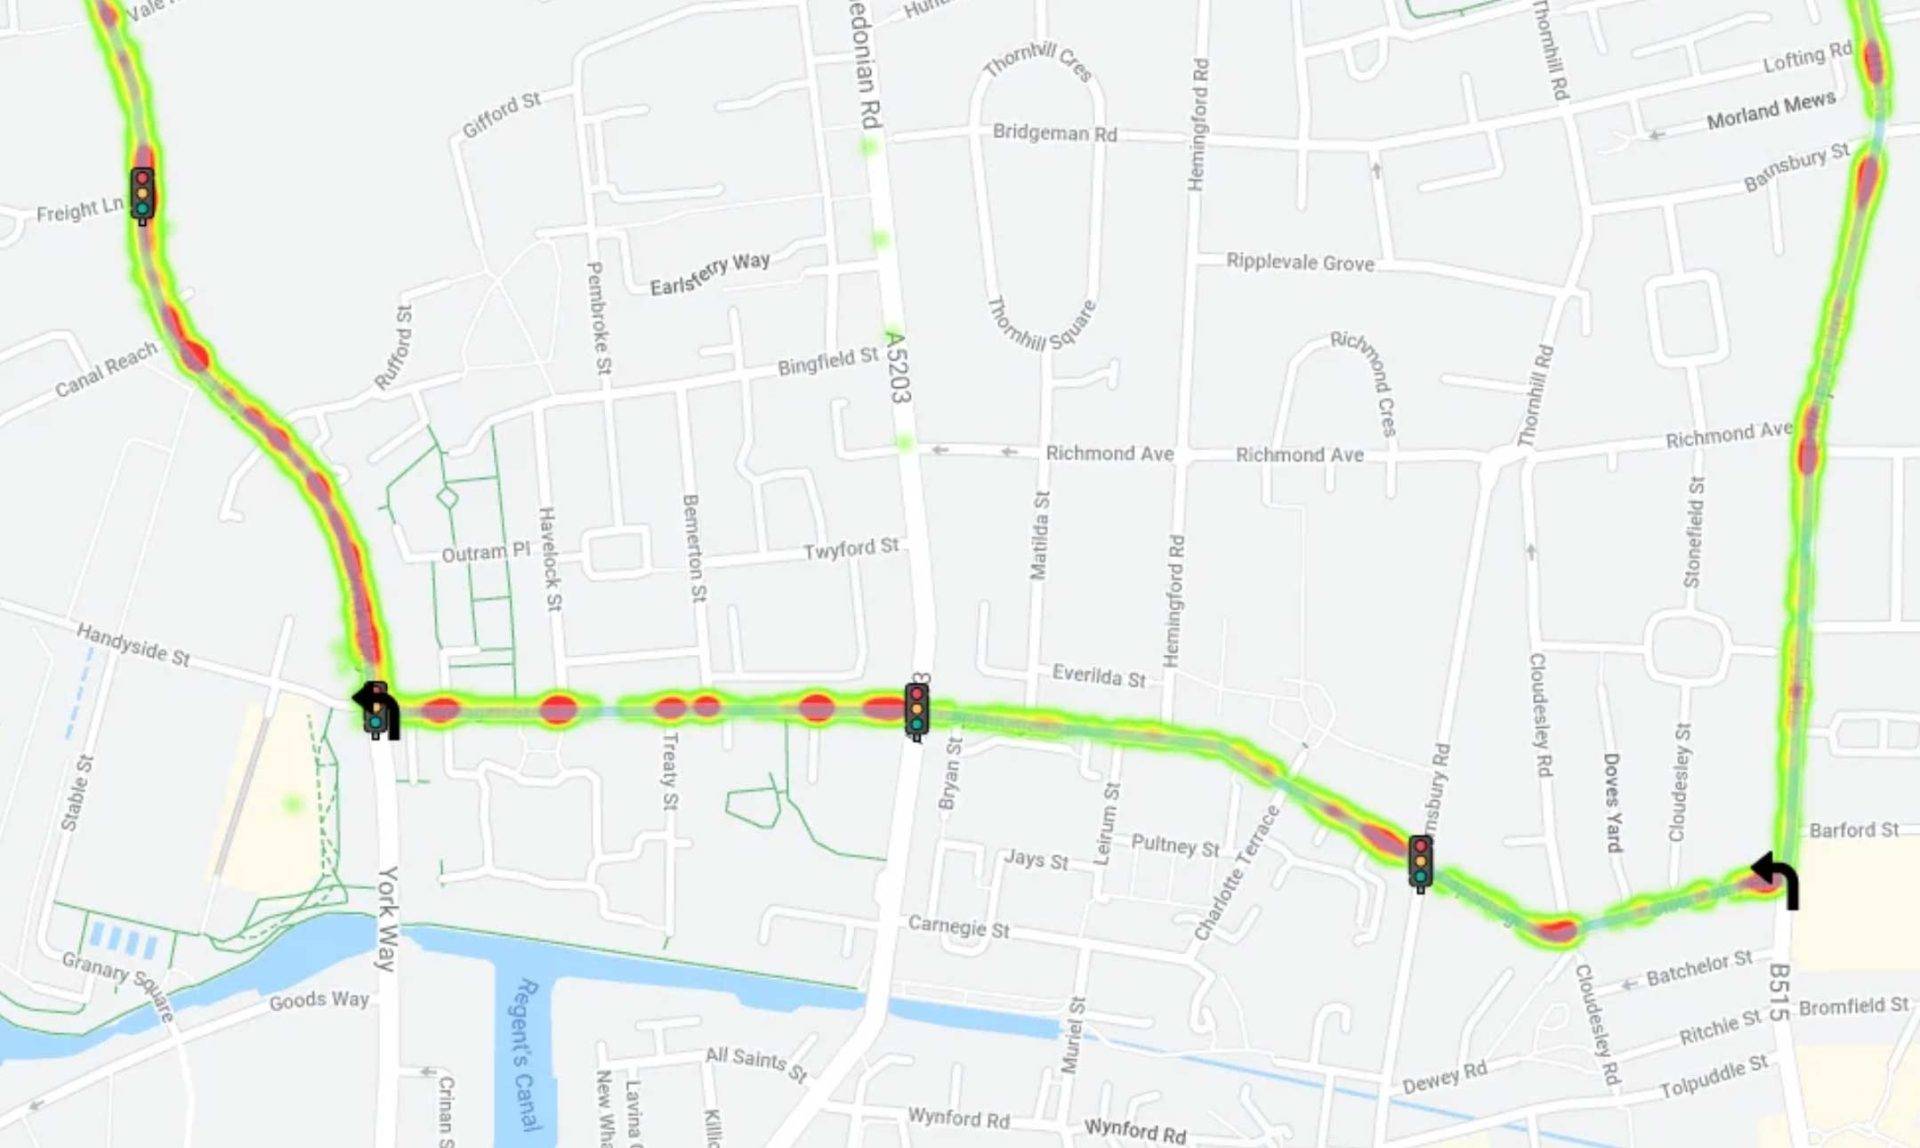
何千時間もの運転データにわたってこのデータを集計することで、より堅牢で統計的に意味のある方法で、自律走行のパフォーマンスに関するより高レベルの視点を構築し始めることができます。例えば、上記のルート例では、片側一車線の道路における一時停止交差点での左折において、95%の成功率があることが分かります。
固定ルート評価を超えて
上記の例では、ラベル付けされたデータを自律走行性能指標に変換するために、固定ルート評価をどのように使用できるかを示しました。しかし、事前に定義されたルートやジオフェンス領域に限定することは、現実世界の運転の多様性と複雑性を完全に代表するものではありません。また、長期的に当社の安全ケースを証明するのに十分なデータも得られません。さらに、生産化された自律走行車フリートの要件を考慮すると、地理やシナリオに関係なく、任意の運転データに対して自律走行性能を測定する必要があります。この目標を念頭に置き、これを大規模にサポートするためのインフラストラクチャを構築する必要があります。
地理やシナリオに関係なく、任意の運転データに対して自律走行性能を測定する必要があります。
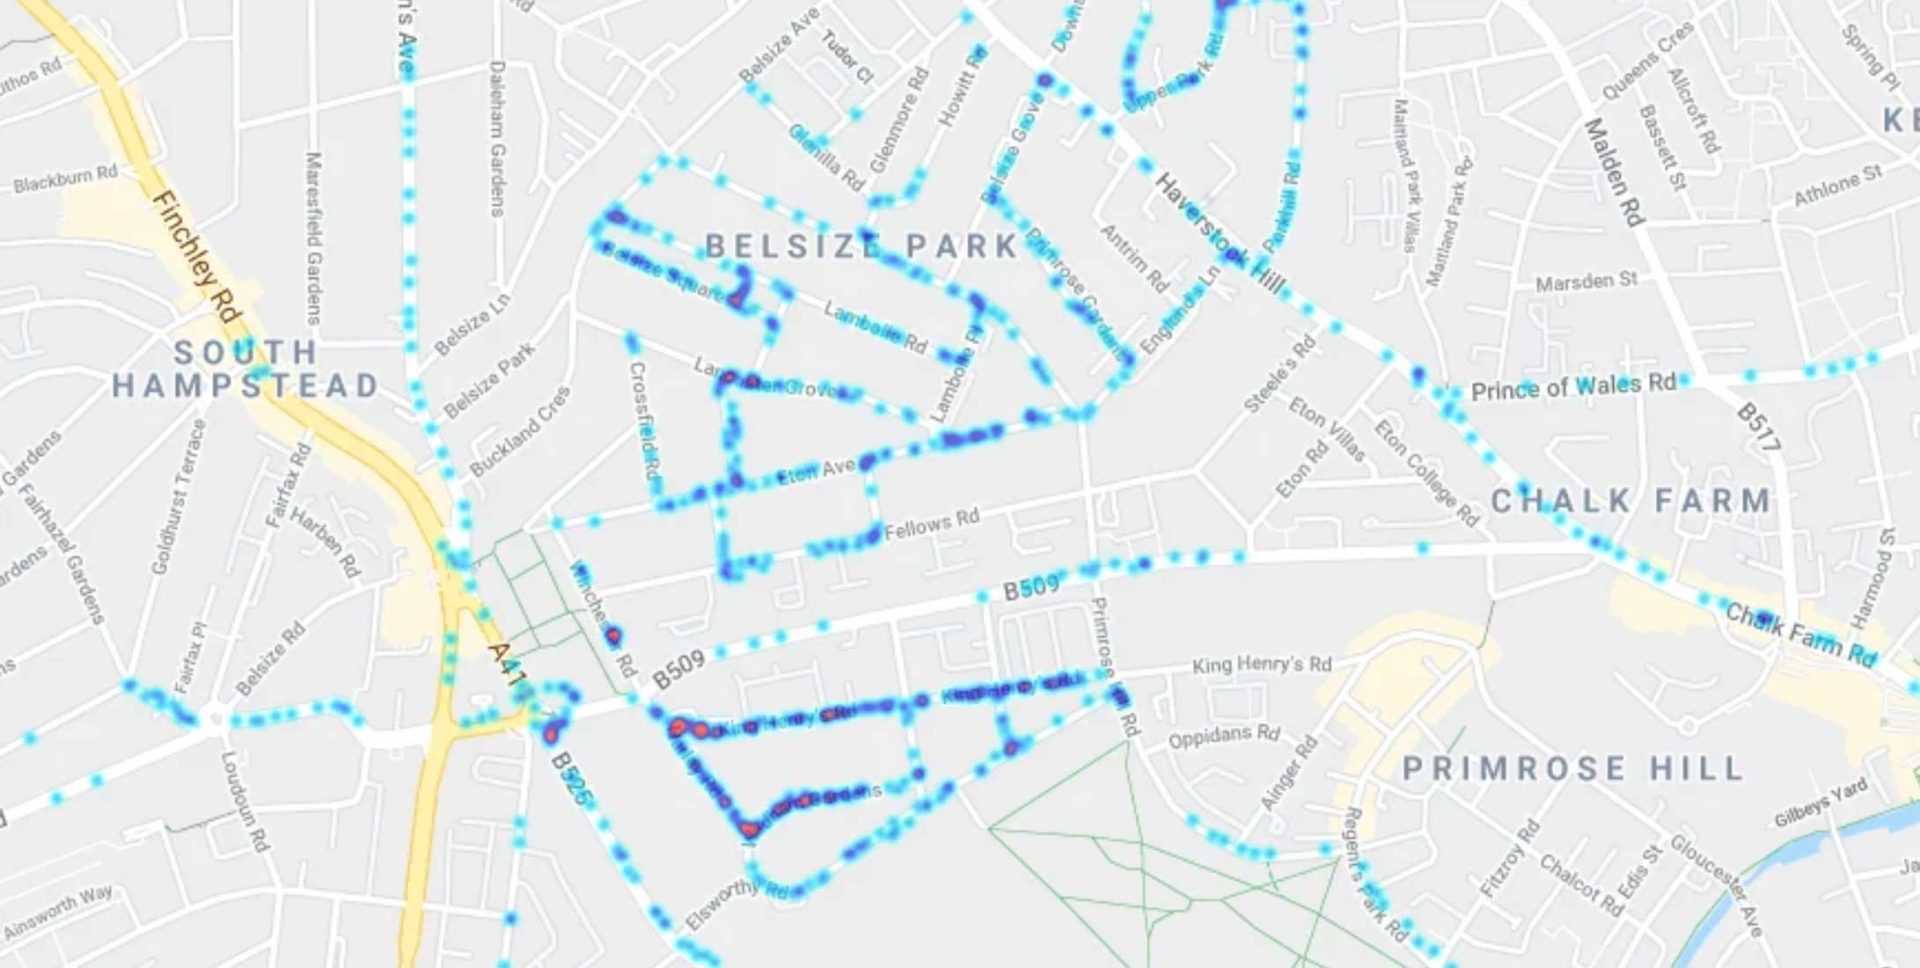
シナリオと介入のラベリングをスケールアップする
上記で説明したフレームワークは、ODDの定義変更に対応できるほど柔軟で汎用性があります。しかし、そのすべては、最低レベルで運転データを正確かつスケーラブルにラベル付けできる能力にかかっています。Wayveでは、可能な限り汎化負債を少なくして物事を構築しようと努めているため、何百万時間もの運転に対してシナリオラベルを生成する方法を詳しく見ていきましょう。
完全自動シナリオラベリング
景観
OpenStreetMap、Mapbox、HERE Maps、Google Mapsなどのマッピングプロバイダーから、私たちが走行する道路や周辺地域に関する多くの情報を抽出できます。これには以下が含まれます。
- 車線情報
- 制限速度と規制
- 交通標識と信号
- ナビゲーション
注:何百万キロメートルもの道路で収集、更新、操作に多大なコストがかかるHDマッピングデータには依存していません。
環境
同様に、気象データはOpenWeatherMap、Dark Sky、Weather.comなどのサードパーティAPIプロバイダーを通じて容易に入手できます。照明条件も、時刻と気象データから(少なくとも基本的なレベルで)簡単に推測できます。
動的要素
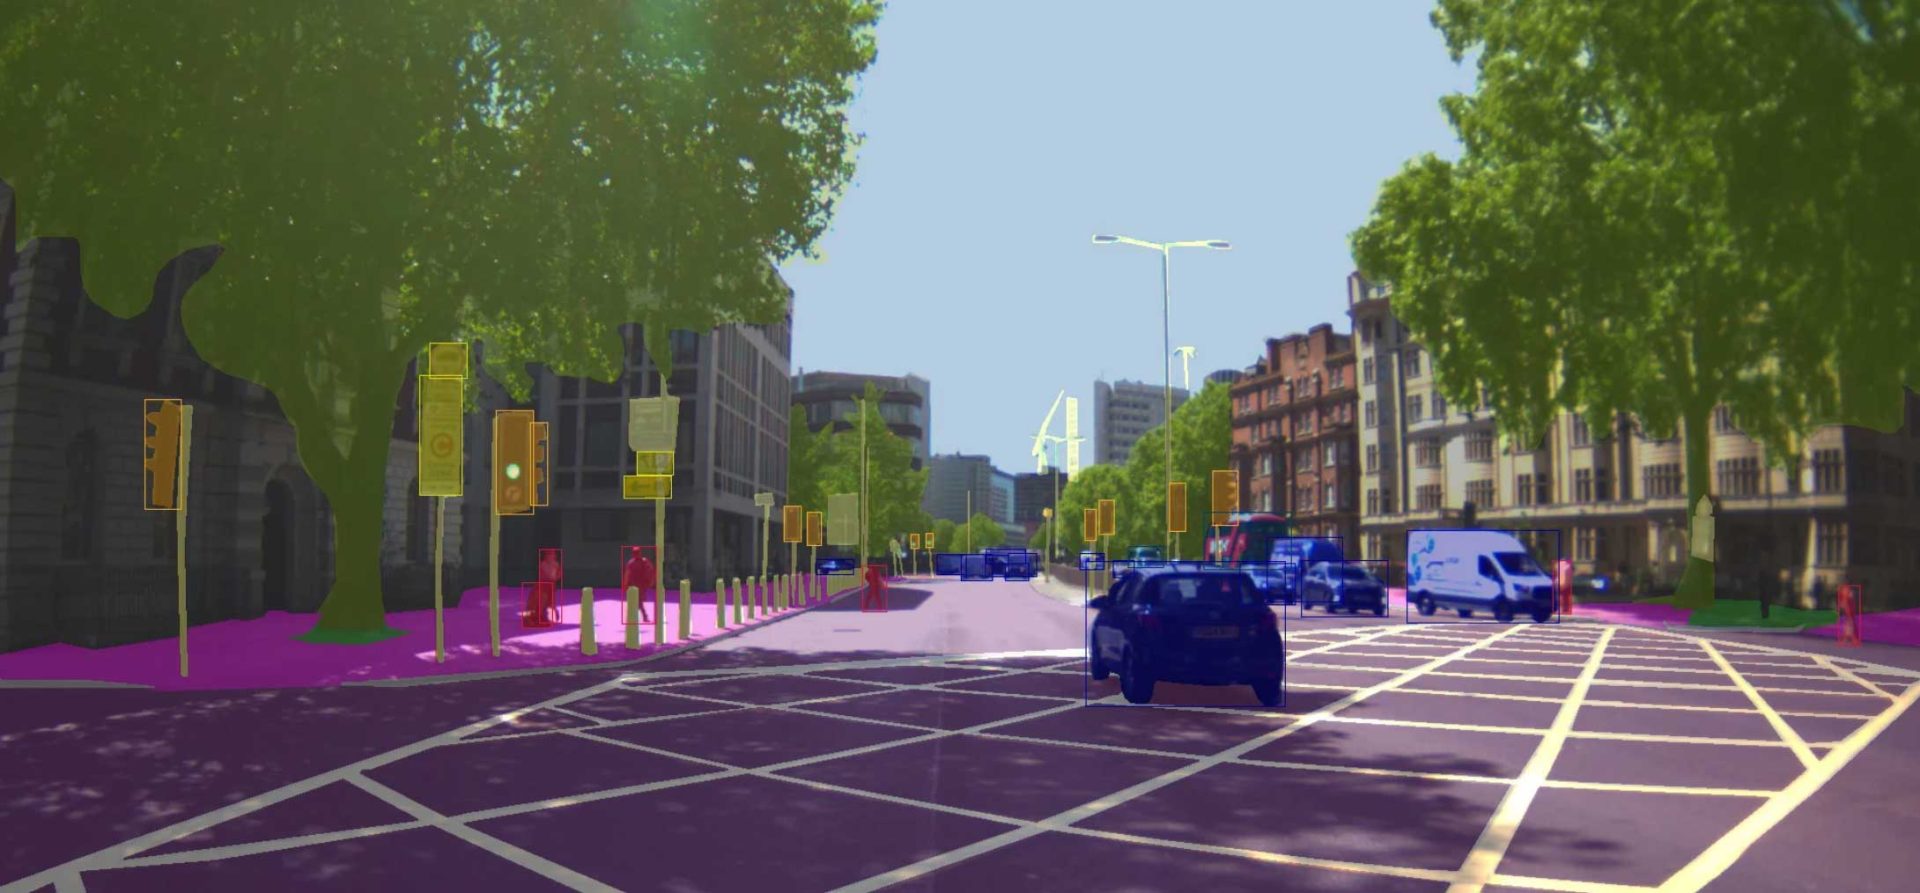
ここから自動ラベリングがより興味深いものになります。ドライバーや歩行者など、シーン内の他のエージェントを検出するには、記録時の自社のセンサーデータに頼る必要があります。このデータから、前述のシナリオラベルを抽出する必要があります。幸いなことに、当社はすでに運転可能な深層学習ベースのコンピュータービジョンシステムを構築しています。ここでは、知覚スタックの一部を再利用して役立てることができます。
当社の知覚システムは、以下を含む最大26種類のシーン要素を検出できます。
- 車両
- 歩行者
- 交通信号
- 車線表示など…
介入
介入は本質的に人間の判断と行動です。ほとんどの場合、車両のテレメトリーと当時のODDラベルの組み合わせに基づいて、介入の理由を推測できます。例えば、赤信号に近づいてブレーキを踏んだ場合、これはAVが交差点で停止する準備を正しく行わなかったことを明確に示しています。このような場合、ルールベースのアルゴリズムを適用して、これらの介入を自動的にラベル付けできます。
しかし、他のケースではそれほど明確でない場合もあるため、セーフティドライバーの専門知識から学び、行動の意図を明確にするために追加の手動アノテーションを行う機会も活用できます。
精度と堅牢性
本質的に、当社の評価タスクはコンピュータービジョン/オブジェクト分類の機械学習問題に還元されます。しかし、この分類の結果を運転全体のパフォーマンス評価に使用するため、その精度にはかなり自信がなければなりません。つまり、誤検知と誤陰性の可能性を最小限に抑えたいと考えています。測定の不確実性を減らす一つの方法は、複数の情報源を組み合わせることです。
信号機の例:
- サードパーティのマッピングプロバイダーは、地理空間座標で信号機の位置を提供でき、車両のGPSと組み合わせることで、近接性を推定できます。
- カメラデータと知覚ラベルは、同様の近接性推定をもたらす可能性があります。
- 介入アノテーションには、「理由 = 赤信号で停止できなかった」が含まれる場合があります。
これらのデータポイントはすべて、シーンに実際に交通信号があり、それが当社の車線に適用され、当社の自律走行が状況を正しく処理できなかったという考えに収束します。
さらに、適切に設計されたデータパイプラインと同様に、分析に使用する前に、入力データを可能な限りクリーンアップし、フィルタリングすることを目指しています。最終的に、どのモデルも当社のリーダーボードに到達するためには、測定におけるノイズの影響を減らすために、最低限の自律走行距離と、シナリオごとの最低限の試行回数を必要とします。
動くターゲットへの対応
第1部では、ImageNetと標準化された測定が機械学習の分野でいかに影響力のある役割を果たしてきたかについて議論しました。私たちが目指しているのは、自律走行のための同様の測定フレームワークを構築することです。しかし、一つの重要な違いは、私たちが静的なドメインで運用しているわけではないという事実です。
私たちが活動する世界は常に変化しているため、当社のパフォーマンス指標がこれを反映していることを確認する必要があります。
参考までに、単純な道路維持作業でさえ考えてみてください。2019/20年には、英国で埋められたポットホールの総数は148万個でした。これらの大部分では、一時的な車線閉鎖や交通迂回が実施されました。同様に、地方自治体による最近のCOVID-19対応により、全国で自転車レーンと歩行者用歩道の急速な拡大と一方通行システムが導入されました。
この絶え間ない変化の状態こそが、固定されたデータセットを使用するのではなく、ODDの各側面内で正確なスコアに収束するために統計的サンプリングに依存する理由です。逐次テストを使用することで、システムの特徴を評価するのにかかる時間を最小限に抑えることができます。
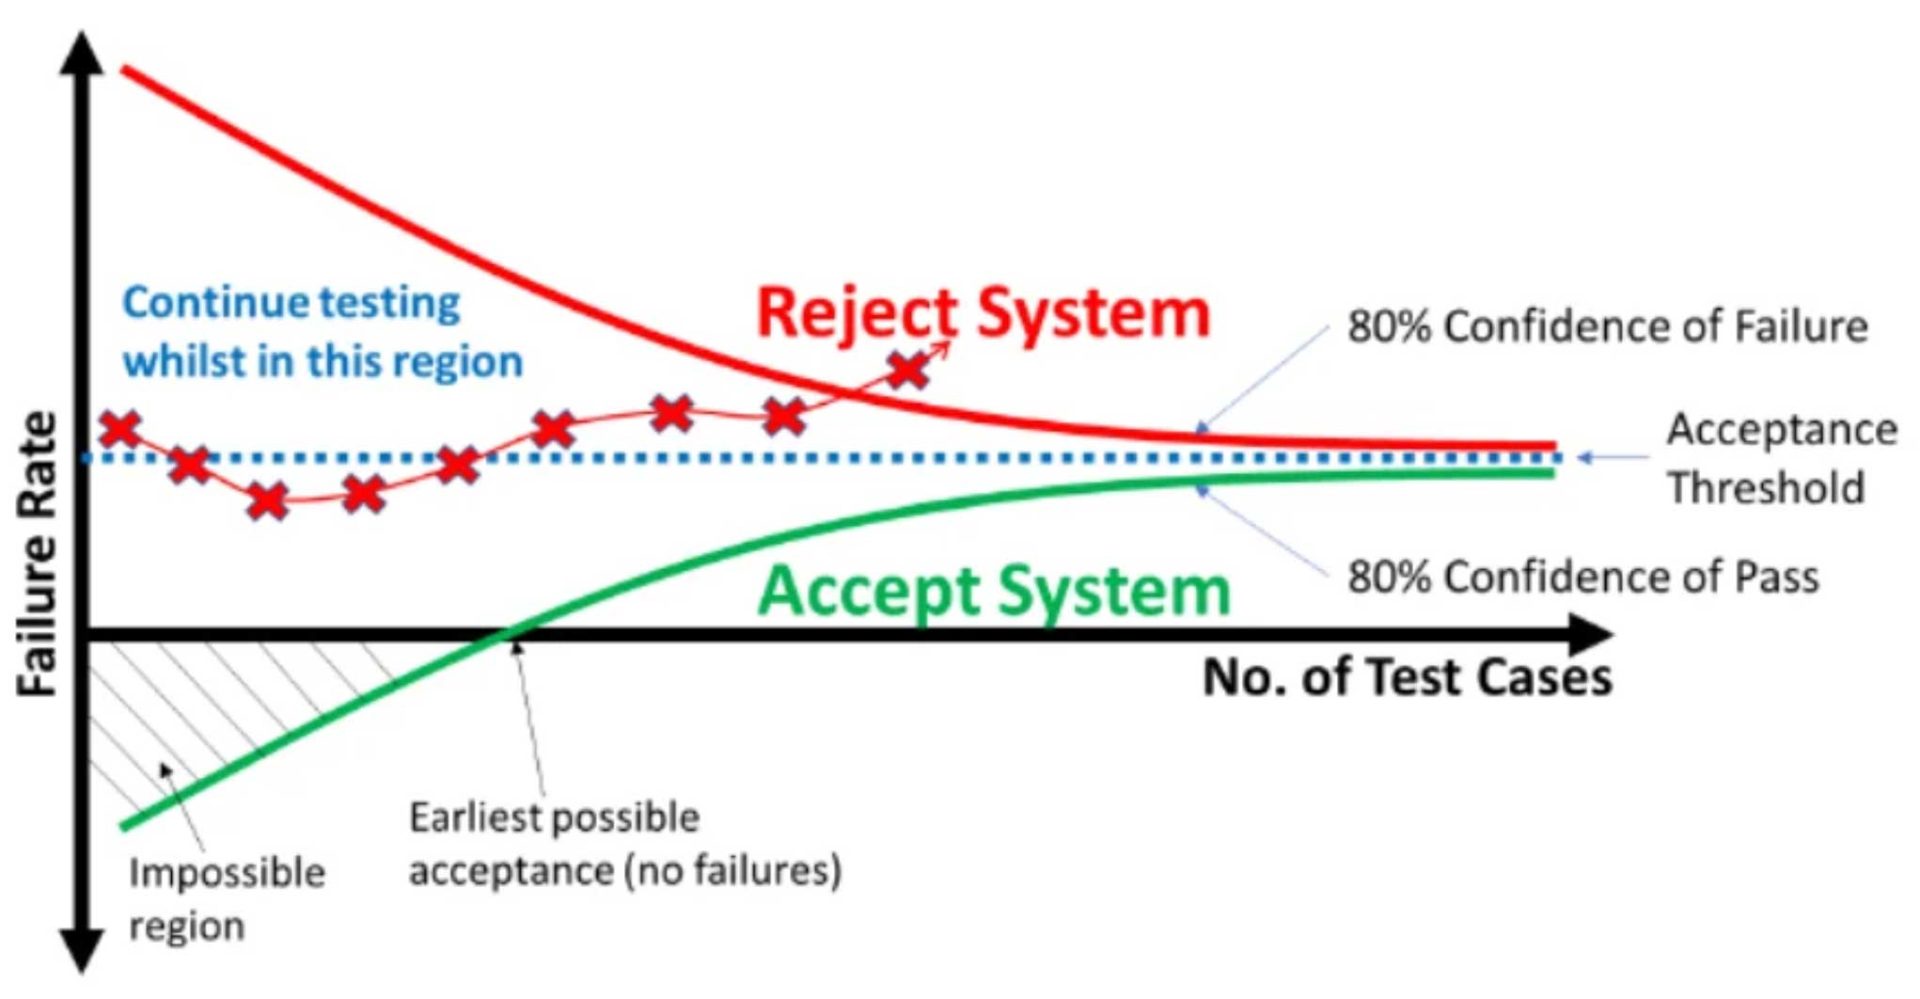 HORIBA MIRA, Test Methods for Interrogating Autonomous Vehicle Behaviour – Findings from the HumanDrive Project, 2019, 21
評価的な自律走行を通じて、ODD内の各シナリオに対して十分なデータポイントを収集し、システムが安全で変化に堅牢であることを自信を持って証明できるようになります。各シナリオは、道路で遭遇する可能性の頻度に応じて、異なる量のデータを必要とします。このフレームワークを使用して、既知のルートと同様に、事前の知識がほとんど必要なく、まったく新しい環境でのパフォーマンスを測定することもできます。
これらのメトリクスを運用する
必要な数のサンプルを達成するために、実際に道路上で十分な運転データを収集する方法については、このシリーズの第3部で説明します。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む