








5 10月 2020 | リーダーシップ
複合現実から自動運転車両へ
Wayveに入社し、ディープラーニングおよびAI組織を率いるようになってから3ヶ月が経ちました。個人的には、英国ケンブリッジで何年も前に始まった非常に実りある共同研究の道のりを経て、再び道路シーンの仕事に戻ってきたことになります。Wayveでの時間の中で、自動運転車両(AV)のためのAI構築に関する現在の考えを書き留め、複合現実(MR)開発の最前線にある企業であるMagic Leapから、なぜこの転身を決意したのかについて自分の見解を共有したいと考えていました。それがこちらです:
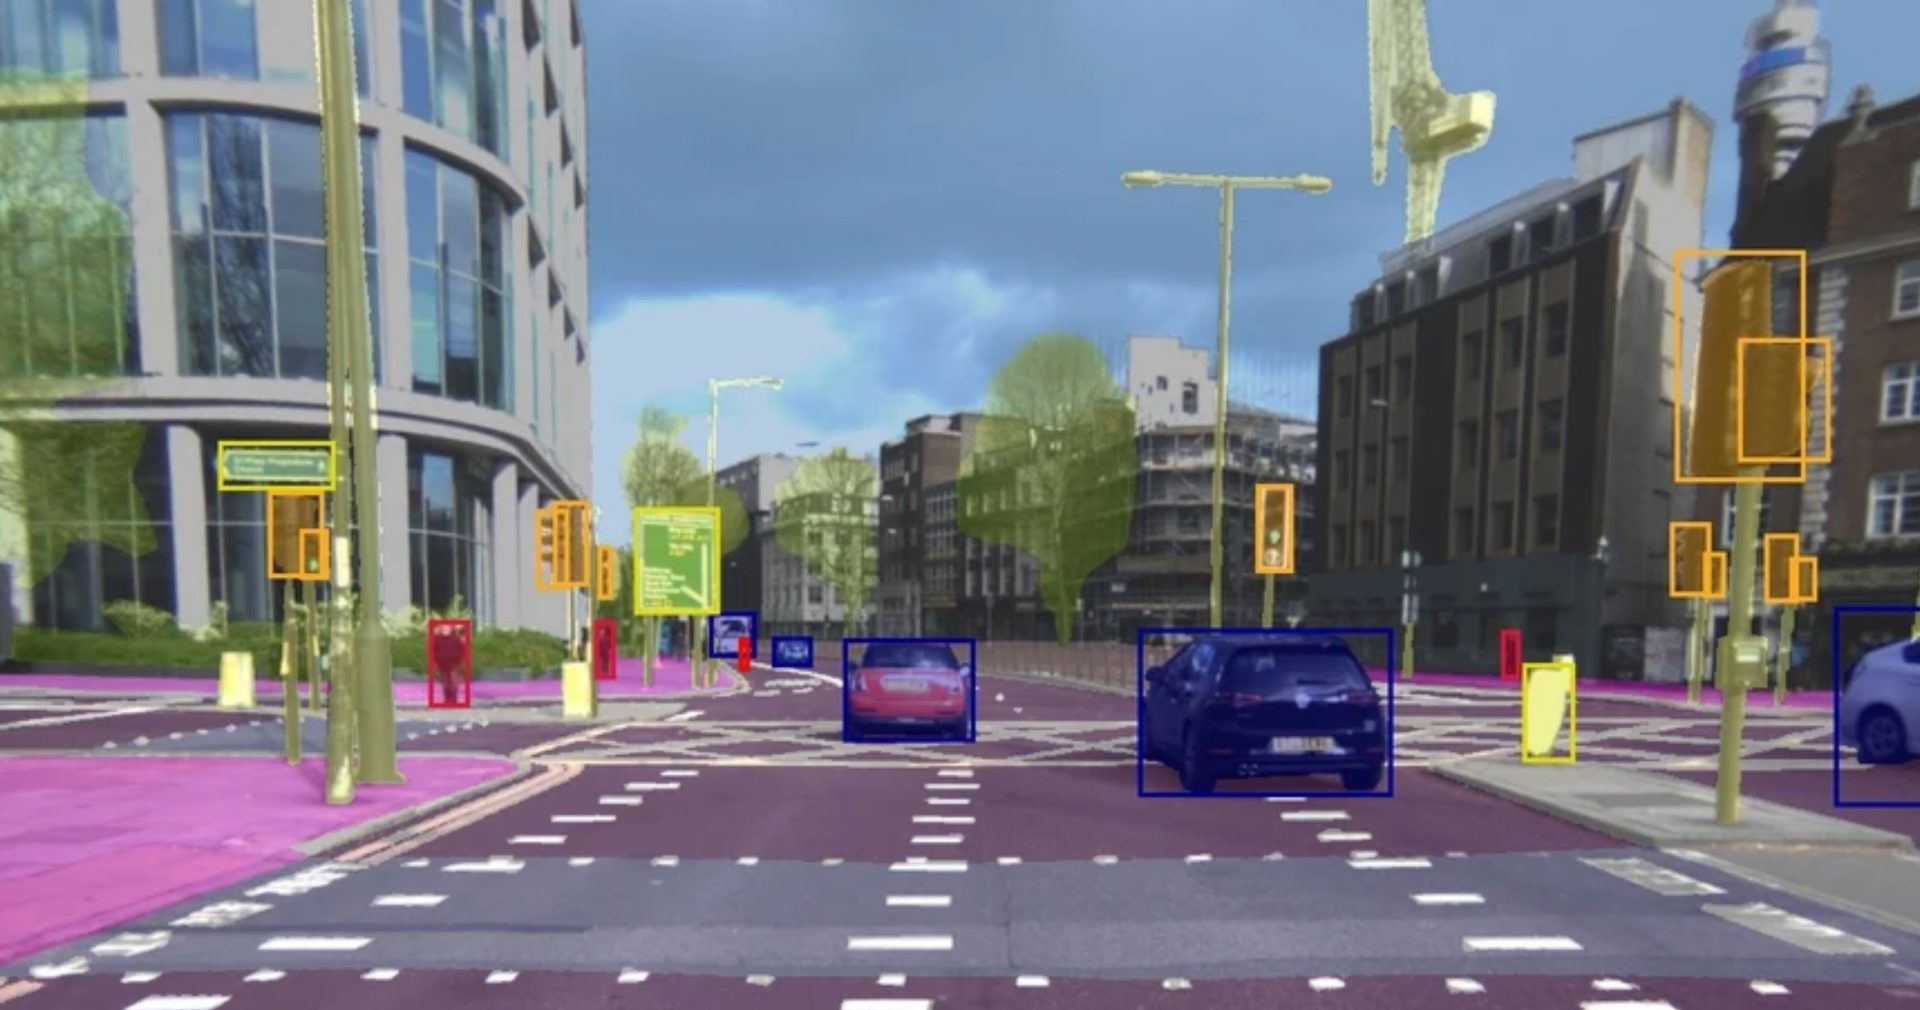
AV(自動運転車両)とMR(複合現実)は、現在、ディープラーニングの研究者やエンジニアにとって2つの主要な問題領域となっています。MRにおけるここ4〜5年は、ヘッドマウントデバイス向けの最高水準のSLAMシステム、効率的な3D再構成アルゴリズム、ハンドジェスチャーおよび視線推定アルゴリズムの構築に費やされてきました。この数年間、私自身も本番環境におけるいくつかのディープラーニングモデルに貢献してきました。また、非常に幸運なことに、ディープSLAMや3D再構成において最先端の成果を生み出した素晴らしいチームに身を置くことができました。高度に制約された計算資源(ResNet-50の約10〜100分の1のFLOPs)、メモリ、バッテリー電力(すべての推論タスクで約2W)という条件下で、ディープラーニングが本番環境の設定内で力強く成長し、パフォーマンスの限界を押し広げる様子を目の当たりにしてきたのは驚くべきことでした。特に、ディープラーニングコミュニティはここ数年、低ビットサイズのモデル学習と推論において大きな進歩を遂げました。4年前には製品化が非常に困難だと思われていたことが、今では多くのモバイルデバイスで当たり前になっています。さらに興味深いことに、現世代のコアな知覚およびSLAM/ジオメトリの本番システムは、その中核にエンドツーエンドのディープラーニングとマルチタスクのディープラーニングを採用しています。振り返ってみると、MRとAVの領域には多くの共通点があることに気づきます。ディープラーニングの観点からは、一方の領域で生まれた新しいアーキテクチャの改善や学習手法は、もう一方の領域にも転用可能です。センサーとそれらのキャリブレーション(両方の領域でオンラインキャリブレーションが必要)、およびそれに続くニューラルネットワークの学習との密接な結合は、両方の領域で類似しています。電力やコストの制約から、学習済みニューラルネットワークを使用することでアクティブセンサーへの依存を減らそうとする取り組みも両方の領域で見られます。MR領域における混合精度学習は、いずれAVモデルのデプロイメントにおいてもその地位を確立するでしょう。AVにおける中心的な課題である経路計画は、MRにおいてバーチャルエージェントが登場するにつれて、最終的に応用されるようになるでしょう。一般的に、効率的で具現化された継続的学習の課題は、両方の領域で対処される必要があります。では、何が私をAV分野への転身へと駆り立てたのでしょうか。おそらく、ディープラーニングの進歩のペースが、MR領域における効率的な計算資源開発のペースよりもはるかに速かったと言っても過言ではないでしょう。MR領域の多くのディープラーニングエンジニアや科学者にとっての欠点は、学習済みのディープモデルをヘッドマウントディスプレイ(HMD)で実機テスト(エンボディド・テスティング)にかける前に、計算資源を最適化(通常100〜1000倍)しなければならないことです。これは、モデルのパフォーマンスを実感するプロセスが実に遅いことを意味します。また、高品質なマップを使用して共有サービスや体験を提供しながら、デバイス群からデータを収集するMRクラウドの出現も、まだ妥当な規模では見られていません。
MRとは対照的に、AVの領域は学習済みモデルを車にデプロイするまでの時間が比較的短い領域です。車内では計算資源やバッテリー電力をより拡張しやすく、クラウドで学習させたモデルをそのまま実世界でデプロイしてテストできることも少なくありません。これは非常に魅力的であり、実世界の機械学習、特に具現化された知能(エンボディド・インテリジェンス)に関心のある研究者に迅速な洞察を提供できます。実際、Wayveでは、真の洞察を得るために週に数回、路上で新しいモデルをテストすることは珍しくありません。
過去10年間のビジョン研究は、分類のためのImageNetや道路シーンのセグメンテーションのためのCityScapesといった大規模な静的データセットでのモデルの学習とテストが大部分を占めていました。ニューラルアーキテクチャ探索を用いたImageNetチャレンジのTop-k精度は97.5%に達しており、画像セグメンテーションにおいても同様に高い数値となっています。これらのデータセットは依然として研究者にとって価値があるものですが、研究コミュニティ内の一般的な総意としては、これらの課題はもはや研究の主要な推進力ではないということです。私たちは今、人間の活動も存在する現実の日常環境で動作することを学ぶエージェント、すなわち具現化された知能を構築することが主要な課題となる10年に入りました。これにより、極めて大規模なデータセット(例:大規模で多様な車両群からのデータ)の収集、保存、クラウド処理など、新しく刺激的な課題が生まれています。このような大規模で継続的に増大するデータセットでモデルを学習させる能力には、データエンジニアリング、機械学習の実務者、そして機械学習の研究者の間での密接な連携が必要です。Wayveでは、これをフリート学習と呼んでおり、それが当社のコア製品です。
Wayveが自社の自動運転車両フリートおよび他の大規模な外部フリートとの提携を通じて収集するデータの規模を背景に、研究者としての私たちの焦点は、堅牢な自動運転のためのエンドツーエンド学習の実現に向けられています。ここで、私個人としては、MR領域で達成した成功、例えばエンドツーエンドの3D再構成や、一般的に多段階システムがよりエンドツーエンドの学習によって簡素化されている様子に触発されています。同様に、Wayveでの路上テストにおいて、エンドツーエンドで学習されたモデルが、ラウンドアバウト、交通島、信号機のある交差点などの複雑な構造をいかに処理できるかを確認しています。さらに、エンドツーエンドで学習されたモデルが、まったく新しい環境で動作するという刺激的な結果も得られています。
近い将来、AVの路上走行性能を継続的に向上させ、堅牢にするための重要な探求軸がいくつかあります。これには、新しいディープアーキテクチャの使用、ジオメトリの学習、入力およびアクション空間の新しいパラメータ化、表現の自己学習および教師なし学習、オンポリシーデータからの学習、そして継続的学習が含まれます。とはいえ、「より大きなモデル、より大きなデータ、そして計算資源がより優れたパフォーマンスにつながる」という不文律は、過去10年間、時の試練に耐えてきました。この10年、ロボティクスにおいても同様であると私は確信しています。すべての研究者とエンジニアの皆さん、この世代を超えた旅に今すぐ参加しましょう!
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む