








Wayveでは、 自動運転2.0、すなわちセンサー、コンピューター、運用ドメイン、車両を横断して汎用化する自律性に対して深い確信を抱いています。当社のデータ、 走行経験、そして 日産、 Stellantis、 メルセデス・ベンツ、およびUberとのパートナーシップは、より多くの車両と場所で自律走行の安全性と快適性のメリットを提供するために設計されたWayve AI Driverの開発を支援しています。
9年間の開発を通じて、自動運転2.0はWayve AI Driverの範囲をはるかに超え、セーフティクリティカルなAIを構築および検証するために使用するツール、プロセス、考え方にまで及ぶことを学びました。自動運転1.0を可能にし、この業界を創出した検証および妥当性確認のパラダイムの多くは、自動運転2.0には非効率的、不十分、または適用不可能です。この現実により、当社はValidation 2.0として総称するツールとプロセスのコレクションを開発するに至りました。
Validation 2.0は自動運転2.0のコンパニオンです。AIのスケーリング特性を検証自体に適用します。つまり、より多くのデータで改善し、車両や運用ドメイン全体で汎用化し、信頼できる安全ケースに必要なエビデンスを生成する検証システムです。自動運転2.0と同様に、このツールセットは最先端の物理AI開発の課題に対応するために必要であるだけでなく、普及する自動運転技術に人々が求める体験、すなわち、より広範で複雑な走行設計領域(ODD)全体で、より高性能で信頼性の高い自動運転の旅をより低コストで実現することを根本的に可能にすると信じています。
Validation 2.0は3つの技術的柱に基づいています。
- 当社のワールドモデルであるGAIAを搭載した、高効率でドメインギャップの少ないクローズドループシミュレーション。
- GRADER(Generalizable Reward for Autonomous Driving Evaluation and RL)による、学習済みで汎用化可能な行動評価。GRADERは、あらゆるバリエーションに対して手書きのルールに依存することなく運転行動を評価するために設計された、データ駆動型報酬モデルです。
- 統計的エビデンス転送。これは、以前のソフトウェアリリース、車両プラットフォーム、および動作条件からのエビデンスが、新しいリリースの安全性の主張をどの程度信頼性高く裏付けられるかを決定します。
Validation 2.0は、業界の要求に応えるため、適用可能な機能安全およびSOTIF規格に強く基づいています。当社は、展開における主要なボトルネックである行動検証に焦点を当て、不合理なリスクの不在(AUR)に関する信頼できるエビデンスを構築しています。
この記事の残りの部分では、革新的なツールとプロセスがどのように連携して、あらゆるセーフティクリティカルなロボットAIシステムの検証をよりスケーラブルで汎用性があり、信頼できるものにするかを説明します。
検証には変革が必要
自動運転業界は、アーキテクチャの岐路に立たされています。20年間の開発は、現実世界におけるAIの最も具体的で重要な具現化を生み出し、それに伴い期待も高まっています。L2+の個人車両やL4のロボタクシーがより多くの人々に届くにつれて、顧客は当然のことながら、より高性能で信頼できるシステムを求めています。最先端の言語モデルが多くのタスクで人間と同等かそれ以上の性能を発揮することを期待するのと同様に、自動運転に対しても高い期待を抱いています。
展開準備の証明であり、その背後にある安全性の主張である検証は、同じ革命を経験していません。
標準的な慣行は依然として、大規模な形式要件セットに基づいています。これらは大規模なテストセットに変換され、テスト固有のメトリクスに対して評価され、結果は新しい車両や運用ドメインにうまく転用できないヒューリスティクスによって集計されます。その結果生じる要件、テスト、メトリクス、および受け入れ基準のクモの巣状のネットワークは、テスト対象の運転スタックの複雑さを超えることがよくあります。このトレーサビリティの網を解きほぐし、理解するには、大規模なエンジニアリングチームが必要であり、彼らは進歩よりもメンテナンスにますます時間を取られるようになります。
最も問題なのは、これらの検証システムが、テスト対象システムを改善する唯一の特性、つまり「より多くのデータ」を共有していないことです。学習済みコンポーネントが内部に存在する可能性はありますが、最終的な結果は、期待や要件の変化に応じてスケールしたり汎用化したりしません。
検証がテスト対象システムと同じ速度で進歩することを望むなら、同じ好ましいスケーリングと汎用化の特性を共有する必要があります。
モジュラー神話:コンポーネントレベルのエビデンスでは不十分な理由
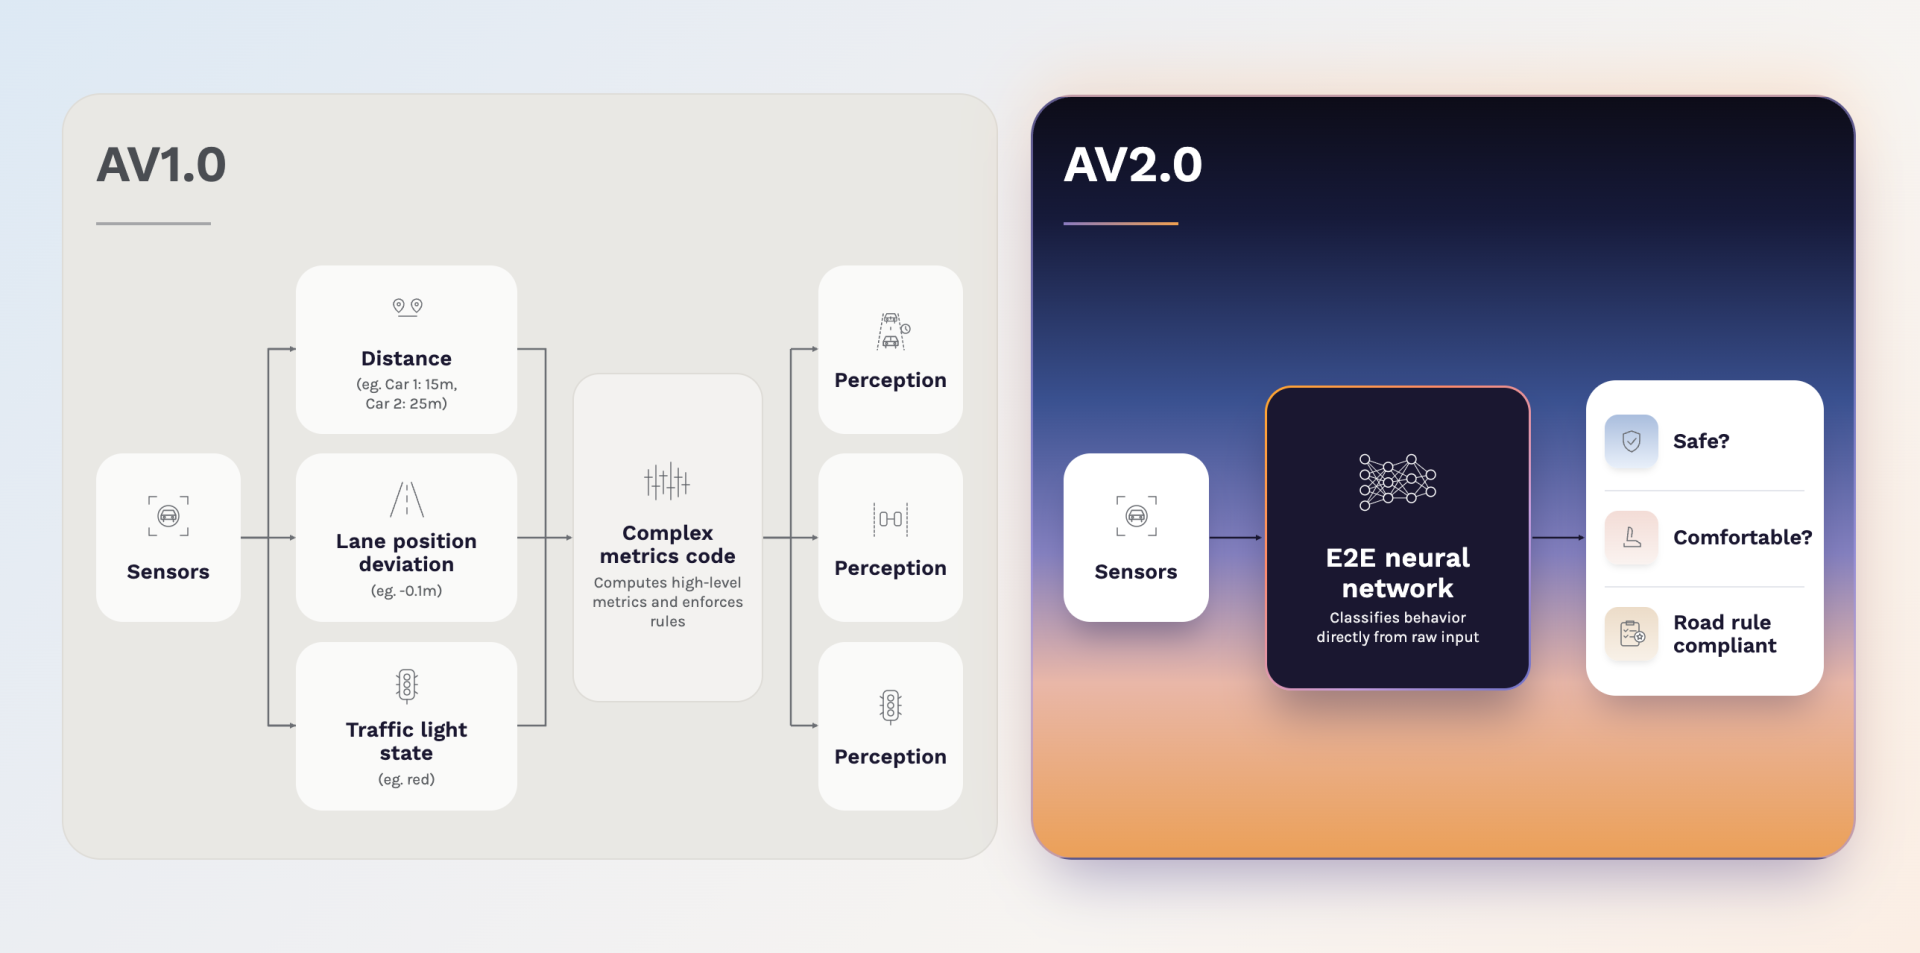
「Wayveが安全なWayve AI Driverを構築する方法」で詳述されているように、自動運転1.0システムは、知覚、計画、マッピングといった大規模な分離可能なサブシステムによって定義されることが多く、これらは従来の検証および妥当性確認(V&V)に適しています。システム要件はサブシステム要件に流れ込み、その後サブシステム固有のテスト、メトリクス、受け入れ基準へと続きます。システムを意味のある部分に分解し、それらの部分を独立して評価し、その後システム全体に関する主張を外挿する能力は、一見すると有利に見えます。
しかし、強力なサブシステムレベルの性能とトレーサビリティは、システムレベルの安全性を保証するものではありません。
モジュラーな自動運転1.0の検証は、誤った安心感を与えます。マッピングや知覚のような独立したサブシステムは個別のテストに合格できますが、道路工事がランドマークを隠し、知覚エイリアシングを引き起こすといった動的な現実世界の変化は、自信を持って誤ったデータをプランナーに供給する可能性があります。分離可能性はテストカバレッジと理解しやすさを保証しますが、システムレベルの安全性を保証することはできません。
自動運転2.0、あるいはあらゆるエンドツーエンドAIアーキテクチャは、モジュラーシステムと同じ方法で、知覚、マッピング、計画を独立してテスト可能な段階として公開しません。マップ、信号機、その他のシーン要素の内部表現を学習するかもしれませんが、従来の人間によるQAが独立して検証できるような個別のインターフェースとしてそれらを公開することはありません。したがって、自動運転2.0には新しい検証アプローチが必要です。それは、システム全体の挙動を評価し、セーフティクリティカルなAIシステム全体にスケールできるものです。
当社のValidation 2.0フレームワークは、この行動優先のアプローチを採用しています。
この汎用化のエビデンスは、国、車両プラットフォーム、およびソースを横断して収集されたデータに見られます。これらの状況は異なって見えますが、それぞれが同じ行動判断、つまり停止を必要とします。それぞれの場合において、当社のオフライン検証システムは車両が停止すると予想されることを特定し、明示的な自動運転1.0の知覚機能や距離測定に依存することなく、その評価が汎用化できることを示しています。
柱1:クローズドループシミュレーション
GAIAは、当社のマルチモーダルワールドモデルであり、クローズドループシミュレーションを支えています。危機的な状況での安全性を評価するため、GAIAはドライブレコーダーの映像などの非構造化された現実世界のビデオから、インタラクティブなシナリオを直接生成します。これにより、多様なフリートで収集された膨大なビデオデータを使用して、ロングテールの危険なイベントにおけるAI Driverの性能を評価できます。
Wayveの自動運転スタックを、記録された人間の運転と並行してクローズドループシミュレーションで評価することで、高性能を厳密にベンチマークし、高リスクの運転条件下でのエビデンスを構築できます。Wayve AI Driverを再帰的に改善するためにアクティブラーニング技術を適用するのと同様に、データコーパス内でシミュレーションを改善してシミュレーションと実世界のギャップをエンドツーエンドの問題として減らすことができるシナリオを検索するためにそれらを使用できます。これは、検証のためのシミュレーションツールとしてのGAIAの信頼性を確立するために不可欠です。
柱2:GRADER – 学習済みで汎用化可能な批評家
この業界の多くの人は、運転の評価は運転そのものと同じくらい難しいと言うでしょう。つまり、絶対的な尺度で、ほとんど誤差なく、良い運転と悪い運転を区別することです。さらに難しいのは、あらゆる入力ソースとあらゆる地域で、世界中のあらゆる国で良い運転と悪い運転がどのように見えるかを捉えながら、それを大規模に行うことです。
最先端の自動運転1.0は、これを手作業で作成された測定基準で解決します。要素的なシーン属性、派生メトリクス、およびコンプライアンス、安全性、快適性をカバーする特注のロジックが、都市ごと、市場ごとに再作成されます。その結果、評価対象の運転スタックよりも複雑で維持が難しいヒューリスティックな分析スタックとなり、人々が拡張しない限り改善されません。
そのため、Validation 2.0の中心的な柱は、すべての運転を評価できる単一の批評家である報酬モデリングです。
Wayveの報酬モデルであるGRADER(Generalizable Reward for Autonomous Driving Evaluation and RL)は、自動運転スタックから独立したオフラインコンポーネントです。高い再現率を維持し、ODD、車両タイプ、地域を横断して汎用化することで、高価なQAや基本的な情報のための広範な人間によるラベリングの必要性を低減します。
GRADERは、道路交通規則を与えられることなく、データから地域固有の運転慣習を学習します。以下の例では、ドイツで赤信号で右折する前に停止し続ける行動には高スコアを割り当て、一般的に赤信号での右折が許可されている米国で同じ行動をした場合には低スコアを割り当てています。
柱3:統計的エビデンス転送による検証のスケーリング
多種多様な車両プラットフォームとODDをサポートすることは、Wayve AI Driverの重要な柱ですが、この多様な構成が検証の複雑さを生み出します。エビデンス転送は、効率的で厳密な自動運転検証に不可欠です。これがないと、各ODD、車両プラットフォーム、システムバージョン全体で統計的信頼性を確立するために、費用のかかる冗長な路上テストが必要になります。これは、新しい車両ごとに数百万ドル相当の作業を重複させ、以前のテストでコアシステムの安全性能の多くがすでに確立されている場合でも、検証を遅らせる可能性があります。
エビデンス転送は、ソフトウェアリリース、プラットフォーム、およびシミュレーション、路上、リグ転送、ドライブレコーダー、顧客フリートデータなどのテストモダリティ全体でメトリクスを集約することにより、効率と安全性を向上させます。ベイズパワー事前分布のような統計的手法は、類似のモデルが整合性のあるイベント発生率を示すという期待を形式化します。内部分析では、顧客フリートデータを活用することで、推定イベント発生率の95%信頼区間上限が3分の1に減少し、必要な検証データが20分の1以上に削減され、検証が大幅に加速されました。
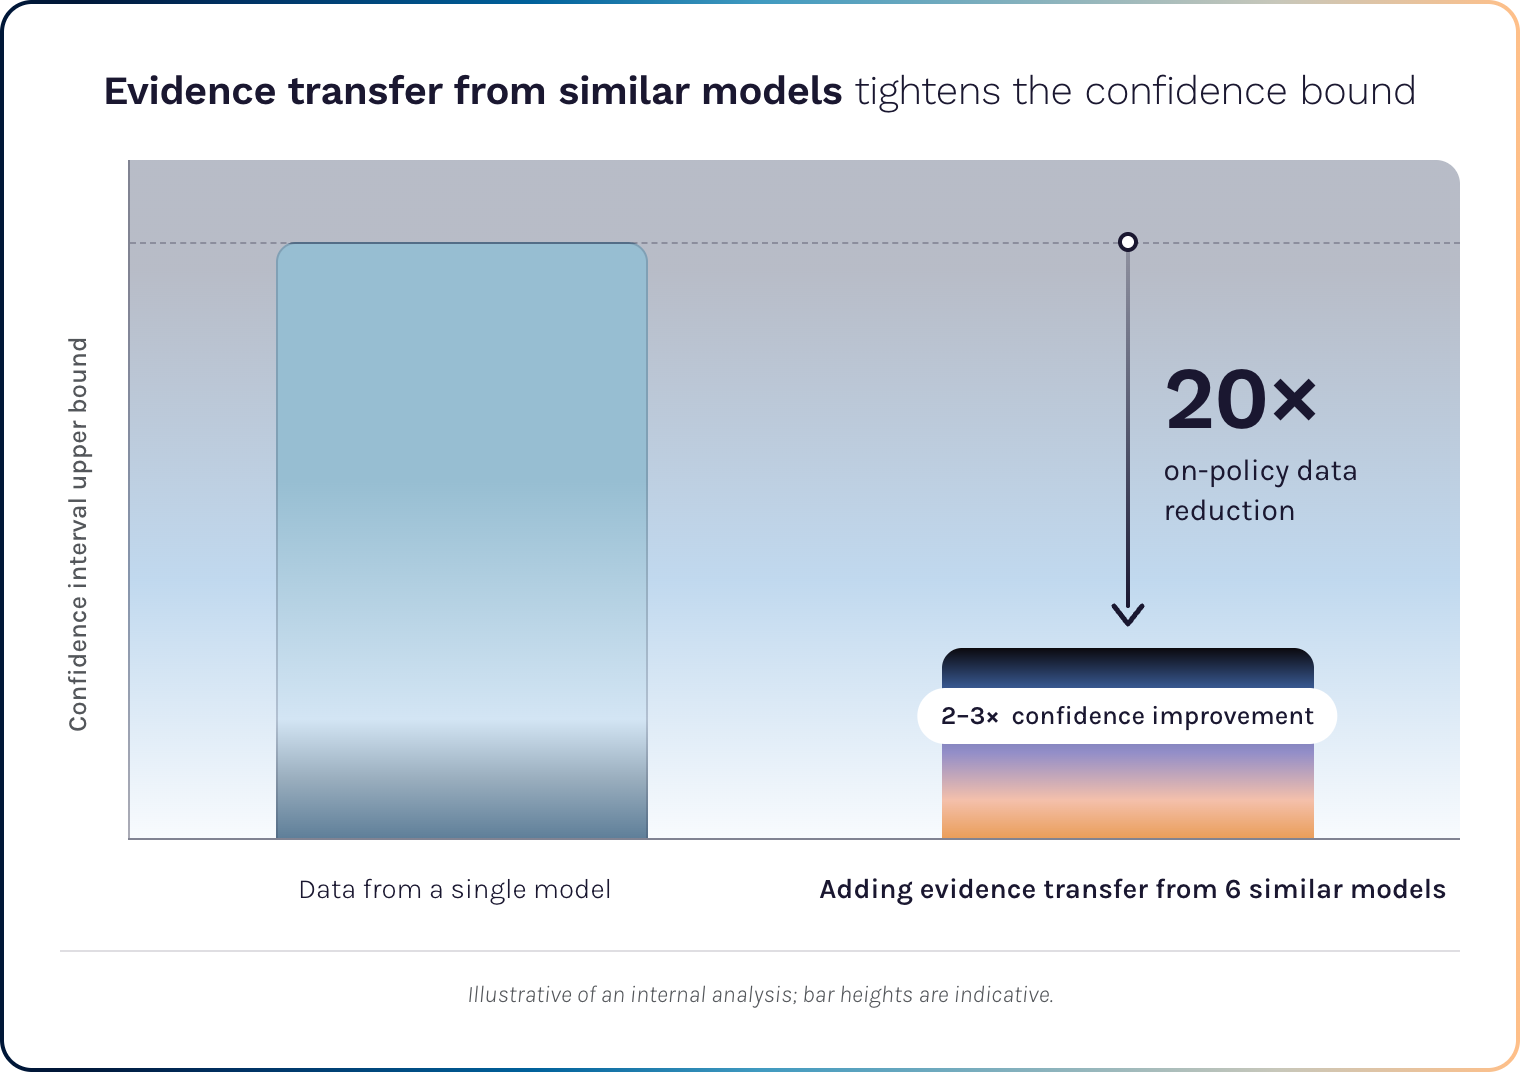
エビデンス転送は、データ駆動型の安全性主張を構築するための鍵です。統計的類似性に基づいて過去のデータに重み付けすることで、新しいリリースを評価する際に、どの程度の履歴エビデンスが信頼できるかを定量化します。このエビデンスを組み合わせることで不確実性が減少し、新しいリリース単独のデータよりもイベント発生率の信頼区間上限が狭くなります。厳密な目標には累積データが依然として必要ですが、エビデンス転送は各リリースに必要な新しいデータの量を大幅に削減し、全体的な安全性主張を強化します。
結論
自動運転2.0は、AI時代の検証を近代化するという明確な使命を提示しています。Wayveでは、この使命を意図的かつ責任を持って引き受け、既存の技術から可能な限り多くを借りつつ、より優れたスケーリング、より優れた汎用化、そして最終的にはL2からL4までの信頼できる製品を生み出すと信じる新しい革新的なツールに傾倒しています。
Validation 2.0は、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築します。自動運転1.0システムとは異なり、エンジニアリング人員はシステムやODDの複雑さに比例して直線的に増加することはありません。学習済みシミュレーションおよび評価システムは、人間の労力ではなくデータとともにスケールします。
このシリーズの最終記事では、別の種類の「証拠」とされるもの、つまりAIシステムが自身の行動について生成する説明と、それらの説明を安全性の証明と混同してはならない理由について取り上げます。
言語と説明
言語は、具現化されたAIシステムの能力を高め、検証されれば理解しやすくすることができます。しかし、それ自体がシステムを物理的に有能または安全にするわけではありません。
詳細はこちら4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む
3 8月 2026 | リサーチ
GAIA-4:安全で拡張可能な自動運転のためのクローズドループ・シミュレーションを実現するマルチモーダル・ワールドモデル
GAIAの最新の進化形であるGAIA-4は、Wayve AI Driverをループ内に組み込み、ワールドモデリングをシーン生成から、エンドツーエンドの安全性を大規模に測定する手段へと変貌させます。
続きを読む