








16 3月 2020 | リサーチ
未来の予測
未来を予測することは、自動運転AIを設計する上で重要な要素です。これにより、特定の行動の質を評価し、周囲の歩行者や車両がどのように動くかを予測するなど、シーンのダイナミクスについて推論することが可能になります。これを正確かつ確実に実行することは、今日の自動運転業界における最も困難な課題の一つです。
現在のアプローチでは、通常、マルチモーダルな不確実性を正確に推定し、未来の確率性を予測することができません。それが可能なシステムであっても、微分不可能であったり、エンドツーエンドでの学習ができなかったりすることが多く、手動でコーディングされた表現に基づいて推論を行っているのが現状です。さらに重要な点として、シーン内の各エージェントの行動を個別に予測し、静的なシーンの予測を高精度地図(HDマップ)に依存していることが挙げられます。これは、合流地点などの複数のエージェントが相互作用する状況や、道路工事などによるHDマップの誤差が生じた場合に機能しなくなります。
本ブログでは、これらの欠点を克服できる新しいパラダイムについて説明します。これにより、当社のエンドツーエンドのディープドライビングポリシーは、未来について明示的に推論できるようになります。
こちらの都市部での運転シーン(1秒間のコンテキストをカバーする5つのビデオフレーム)をご覧ください。
この交差点に近づく際、考えられる未来は数多く存在します。以下は、当社の確率的ディープラーニングモデルによるいくつかの予測であり、多様で妥当な未来の予測を示しています。これらのサンプルは、10フレーム先、つまり2秒後の未来を予測したものです。右側の画像はシーンのセマンティックセグメンテーションを示しており、ピクセルを道路(藤色)、歩道(ピンク)、車両(青)、建物(グレー)などのクラスに分類しています。
当社の確率モデルが、この交差点を左折、右折、または直進するという異なるモードを予測できていることがわかります。
当社のモデルは、シーン内の動的エージェントの行動を予測し、動いている交通状況を示すこともできます。対向車線の2台目の車は過去のコンテキストでは遮蔽されていますが、未来においては正確に予測されていることに注目してください。当社の表現は、セマンティクス、ジオメトリ、および動きを理解することができます。
この研究の詳細は、こちらのarXivプレプリントで公開しています。また、この研究は、前回の投稿「運転を夢見る
」で、モデルベースの強化学習モデルを訓練するためにエピソードリプレイの予測モデルを使用することについて書いた前回のブログに続くものです。
現在の分布と未来の分布を一致させる学習
この研究の核心となる考え方は、現時点での限られた観測に基づくと、未来は不確実であるということです。運転データを収集することで、この未来の分布のユニークな事例を一つ観測できます。しかし、これはあくまで一つの事例に過ぎません。私たちは、起こり得る未来の分布を理解する必要があります。この分布はマルチモーダルで複雑な場合があります。例えば、前方の車が停止するかもしれないし、走行を続けるかもしれません。あるいは、角を曲がったとき、静的な環境の道路が開けているかもしれないし、道路工事が行われているかもしれません。
これを解決するために、将来のイベントの確率を学習するモデルを構築します。イベント空間は非常に高次元であるため、未来の分布と呼ばれる確率分布を計算するために、圧縮された潜在空間を学習します。この未来の分布は、観測された未来のシーケンスから学習する必要があるため、特権情報から学習されます。したがって、過去のデータのみにアクセスできる第2の分布である現在の分布を学習し、カルバック・ライブラー情報量(KLダイバージェンス)損失を通じて未来の分布と一致するように訓練します。
これにより、未来にアクセスできない推論時において、現在の分布からサンプリングを行うことができます。このパラダイムにより、モデルが正確で多様な確率的未来予測を出力できることを確認しています。
ディープラーニングのアーキテクチャ
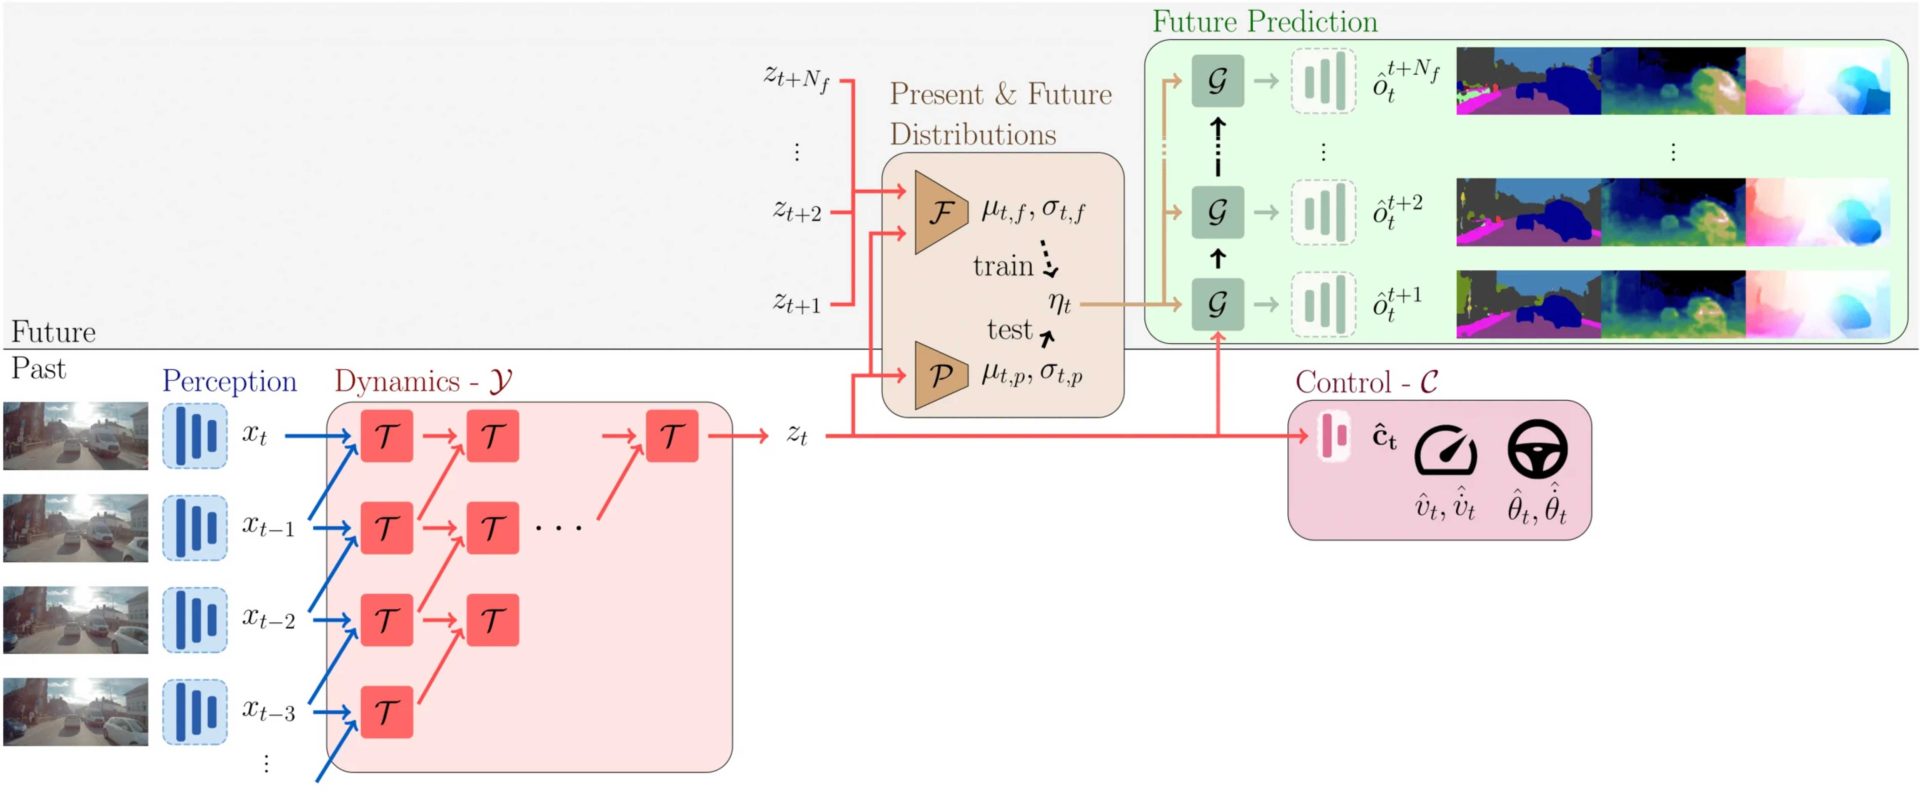
当社のモデルは、未来のシーン表現(セマンティックセグメンテーション、深度、オプティカルフロー)を共同で予測し、自動運転ポリシーを訓練するための時空間特徴を学習します。ニューラルネットワークのアーキテクチャは、以下の5つのコンポーネントで構成されています。
- 認識(Perception):画像シーン理解モデル
- ダイナミクス(Dynamics):時間モデル
- 現在/未来の分布(Present/Future Distribution):当社の確率的フレームワーク
- 未来予測(Future Prediction):未来のビデオシーン表現を予測するモジュール
- 制御(Control):熟練した運転デモンストレーションを使用して運転ポリシーを訓練するモジュール
アーキテクチャの詳細については、arXivプレプリントをご覧ください。
結果:モデルが予測するもの
英国ロンドンで収集された200時間以上の運転データを用いてモデルを訓練しました。このモデルは、8基のNVIDIA 2080Ti GPUを搭載したサーバー上で、PyTorchを使用して5日間訓練されました。以下がその結果です。
妥当でマルチモーダルな未来の予測 当社のモデルは、多様でマルチモーダルな未来を生成することができます。これは、高次元で複雑な都市部の運転シーンにおいて重要です。ここでは、モデルが異なるモードを予測し、交差点を通過する異なるルートを走行する様子を示しています。
次に、ビデオを少し進めて車両が左折を開始した時点にすると、サンプリング時に異なる未来が見えてきます。車両が他の方向に曲がることが妥当ではなくなったため、すべてのサンプルで左折モードが表示されます。
シーンのセマンティクス、ジオメトリ、および動きの理解 以下は、当社のシステムがマルチタスク方式で異なる表現について推論できることを示す例です。セマンティックセグメンテーション、深度、およびオプティカルフローにデコードされる表現を示しています。
このシーンは、複雑な信号のない右折における未来予測を示しています。
マルチエージェントの相互作用の予測 当社のモデルは、都市部の運転シーンにおける他のマルチエージェントの行動も予測できます。以下は、様々な他の動的エージェントの将来の行動を予測した例です。最初の例では、モデルは前方の停滞した交通を予測しています。2番目のサンプルでは、交通の流れに合わせた発進を予測しています。
これは、当社のモデルが自車とサードパーティのエージェントとの相互作用を共同で予測できることを示しています。
歩行者の行動予測。 当社の表現は、基本的な歩行者の行動を予測する方法も理解していますが(このセマンティックセグメンテーション画像では歩行者は赤で予測されています)、個々のインスタンスをより良く表現するためにはまだ課題が残っています。
複数車線の道路走行 最後の例では、複数車線の道路における異なる行動を予測するモデルを示します。最初のサンプルは車両が直進する様子を示しています。2番目では、駐車車両を避けてから左折車線に向かって移動しています。
マルチフレーム、マルチフューチャー
この分野には、この研究にインスピレーションを与えた多くの優れた研究が存在します。しかし、入力状態の次元数(比較的高解像度のビデオ)と、訓練データセットおよびモデルの規模の両面において、この新しいモデルのスケールに私たちは期待を寄せています。
確率的未来予測に関する従来の研究は、軌道予測[DESIRE, Lee et al. 2017、Bhattacharyya et al. 2018、PRECOG, Rhinehart et al. 2019]に焦点を当てているか、単一フレームの画像生成や、シミュレーション(Moving MNIST)または静的なシーンと限定的なダイナミクス(KTH actions、Robot Pushingデータセット)の低解像度(64×64)データセットに限定されていました[Lee et al. 2018、Denton et al. 2018]。当社の新しいフレームワークは、セグメンテーション、深度、フローを含むより完全なシーン表現で推論を行い、自己運動や複雑な相互作用を伴う複雑な現実世界の都市運転データに基づいてビデオシーケンス全体を生成できます。
さらに、未来の確率的性質をモデル化するための当社の変分アプローチは、マルチモーダルな訓練データ(すなわち、特定の入力に対して複数の出力ラベルが提供されるデータ)を使用しません。代わりに、一つの未来の現実しか観測できない現実世界の運転データから直接学習し、多様で妥当な未来を生成できることを実証しています。
これが自動運転にどのようにもたらすメリット
- 制御性能の向上 ベースラインと比較して、この未来を考慮した表現を使用すると、制御性能指標の向上が見られます。これは特にマルチエージェントの相互作用シナリオにおいて顕著です。
- 不確実性の理解 未来の分布の大きさを把握することで、シーンがモデルにとってどれほどマルチモーダルであるか、あるいは不確実であるかを示すことができます。これは、エッジケースの理解や、モデルが「より注意を払う」必要があるタイミングを把握するのに役立ちます。
- 事前知識の注入 私たちはエンドツーエンドのアプローチを強く支持していますが、限られたデータと計算リソースの中で、ドメイン知識をモデルに巧みに注入する必要があります。私たちは、エンドツーエンドの訓練を維持しつつ、ニューラルネットワークのアーキテクチャの選択と補助的な学習信号によってこれを行っています。このモデルはその優れた例です。
この未来予測研究の未来は?
より構造化された表現 現在、潜在状態で強制している唯一の構造は透視投影であり、空間次元は入力画像から推論されます。透視投影は、他のシーン表現と比較して多くの点で最適ではないことがわかっています。また、例えばオブジェクトのセマンティクスや運動からの構造復元(SfM)から、シーンのダイナミクスについて多くのことがわかっています。当社の表現がこれらのアイデアを活用して、より正確に、より遠い未来を予測する方法は数多くあります。
モデルベース強化学習(MBRL) MBRLシステムを現実世界のロボットにスケールアップする際の最大の課題の一つは、高次元のダイナミクスモデルを構築することです。当社の未来予測モデルは、MBRLモデルで使用するための素晴らしいスタートとなります。未来予測が状態空間においてどの程度探索と汎化が可能であるかを理解し、未来の潜在状態から報酬モデルを構築するために、さらなる分析が必要となるでしょう。
研究論文の映像解説を見る
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む