








17 4月 2024 | リサーチ
LINGO-2:自然言語による運転
本ブログでは、ビジョン、言語、アクションを連携させて運転行動を説明・決定し、自動運転体験の制御とカスタマイズに新たな次元を切り拓く運転モデル、LINGO-2を紹介します。LINGO-2は、公道でテストされた初のクローズドループ型ビジョン・言語・アクション運転モデル(VLAM)です。
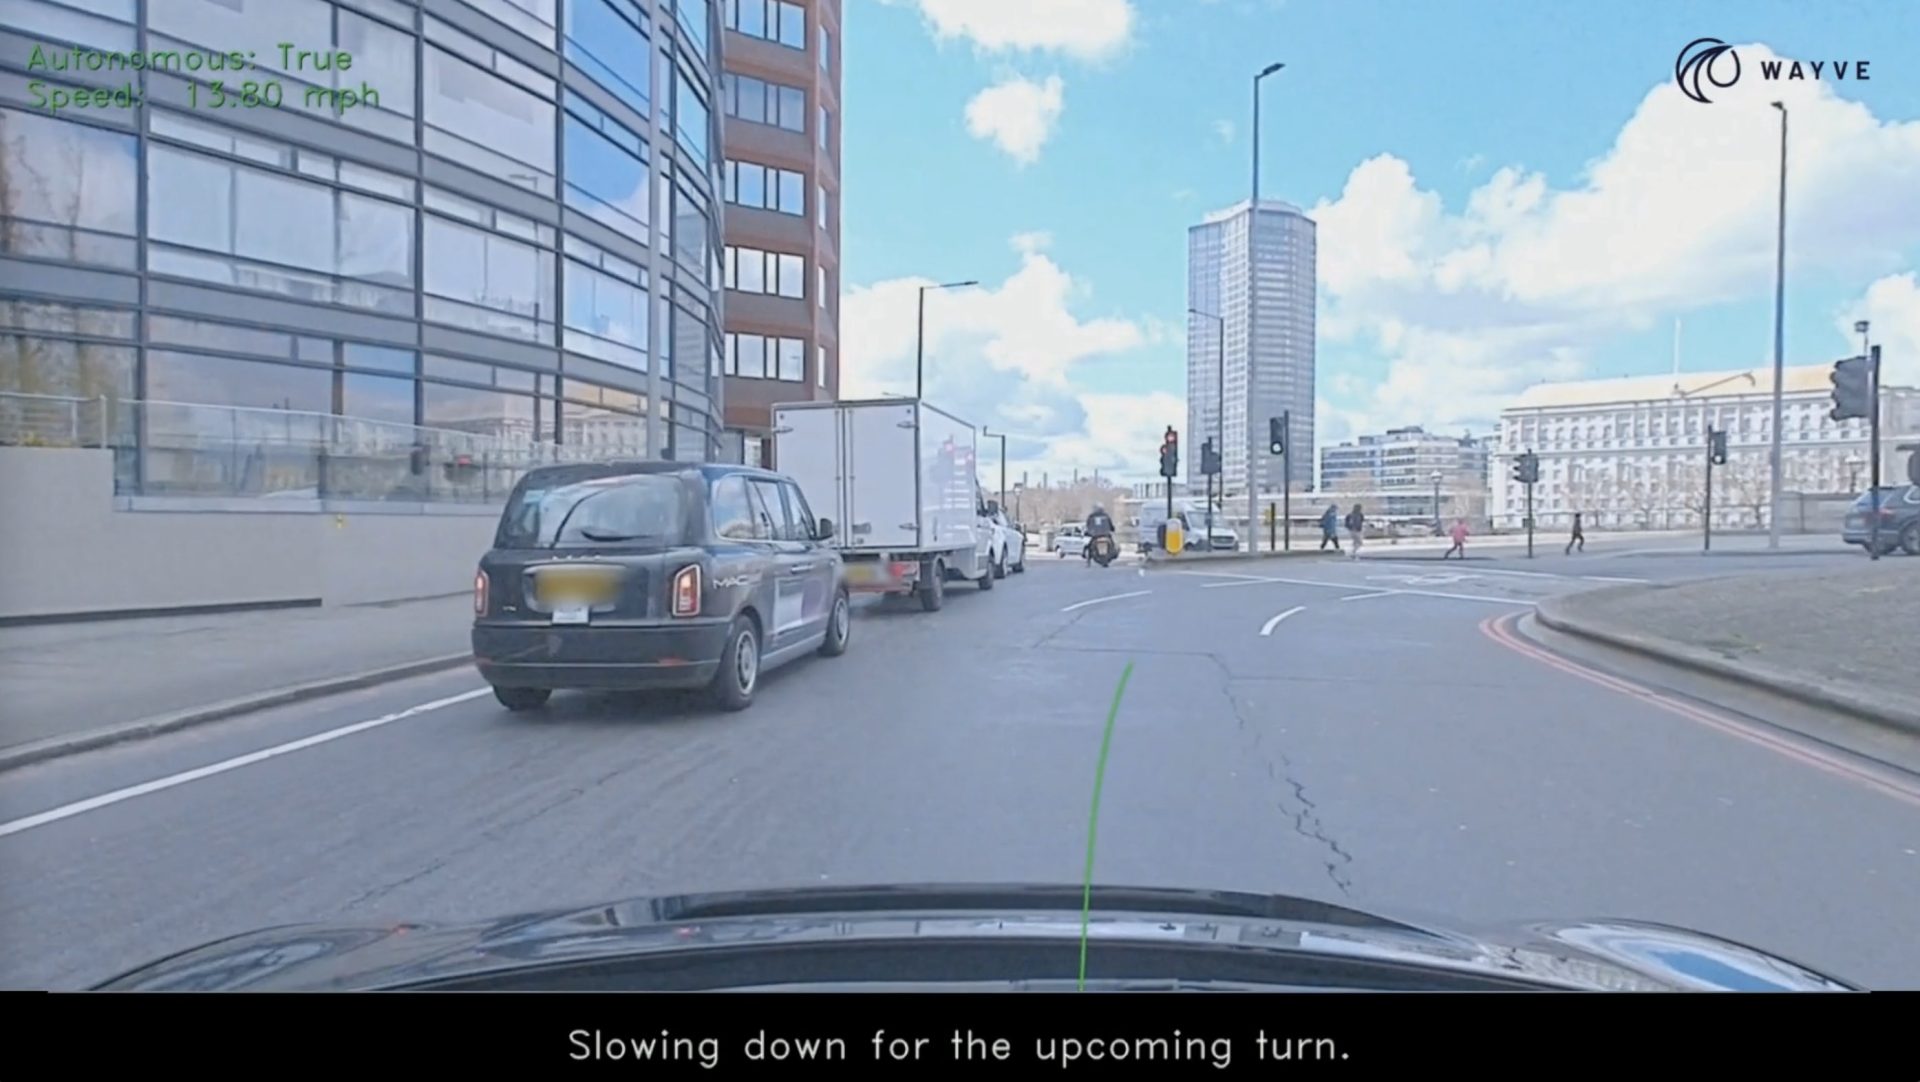
2023年9月、私たちはLINGO-1に関するブログで、自動運転のための自然言語を導入しました。LINGO-1は、信頼できる自動運転技術への第一歩となるオープンループ型の運転解説モデルでした。2023年11月には、参照セグメンテーションによる「ショー・アンド・テル」機能を追加することで、LINGO-1の応答の正確性と信頼性をさらに向上させました。本日、運転モデルを強化するために自然言語を組み込むWayveの先駆的な取り組みの次なるステップとして、LINGO-2を発表できることを嬉しく思います。LINGO-2は、言語でトレーニングされ、公道でテストされた初のクローズドループ型ビジョン・言語・アクション運転モデル(VLAM)です。本ブログ記事では、私たちの手法の技術的詳細と、WayveのAI運転モデルの安全な開発を加速させるための、言語とアクションを組み合わせたLINGO-2の能力の例をご紹介します。
クローズドループ型ビジョン・言語・アクションモデル(VLAM)「LINGO-2」の紹介
以前のモデルであるLINGO-1は、ビジョンと言語の入力を活用して、視覚的質疑応答(VQA)や、シーンの理解、推論、注意の記述などのタスクに関する運転解説を行うオープンループ型のモデルであり、出力は言語のみでした。この研究モデルは、モデルが運転シーンについて何を理解しているかを把握するために言語を使用する重要な第一歩でした。LINGO-2はそれをさらに一歩進め、運転モデルの意思決定プロセスを可視化します。LINGO-2はビジョンと言語を入力として組み合わせ、運転アクションと言語の両方を出力することで、動作計画の決定に関する継続的な運転解説を提供します。LINGO-2はさまざまなシーンの要素に応じてアクションと説明を適応させ、説明と意思決定の整合性を示す強力な初期指標となります。言語とアクションを直接リンクさせることで、LINGO-2はAIシステムがどのように意思決定を行うかを明らかにし、運転の制御とカスタマイズを新たなレベルへと引き上げます。
上記のビデオは、ロンドン中心部でのLINGO-2の走行から撮影されたものです。同じ深層学習モデルが、運転行動とテキスト予測をリアルタイムで生成しています。
LINGO-1は運転シナリオの解説を遡及的に生成できましたが、その解説は運転モデルと統合されていませんでした。そのため、その観察結果は実際の運転決定に基づいたものではありませんでした。しかし、LINGO-2はリアルタイムの運転解説の生成と車の制御の両方を行うことができます。これらの基本的なモダリティの連携は、道路上の歩行者のために減速していることや、追い越し操作を実行していることの説明など、状況の文脈的意味論に対するモデルの深い理解を裏付けています。これは、当社の支援運転および自動運転システムに対する信頼を高めるための極めて重要なステップです。運転アクションの記述と因果推論をモデルのトレーニングに組み込むことで、自然言語による学習を加速させる新たな可能性が開かれます。将来的には、自然言語インターフェースによってユーザーが運転モデルと対話できるようになり、人々がこれらのシステムを理解し、信頼を築くことが容易になる可能性があります。
LINGO-2のアーキテクチャ:運転のためのマルチモーダル・トランスフォーマー
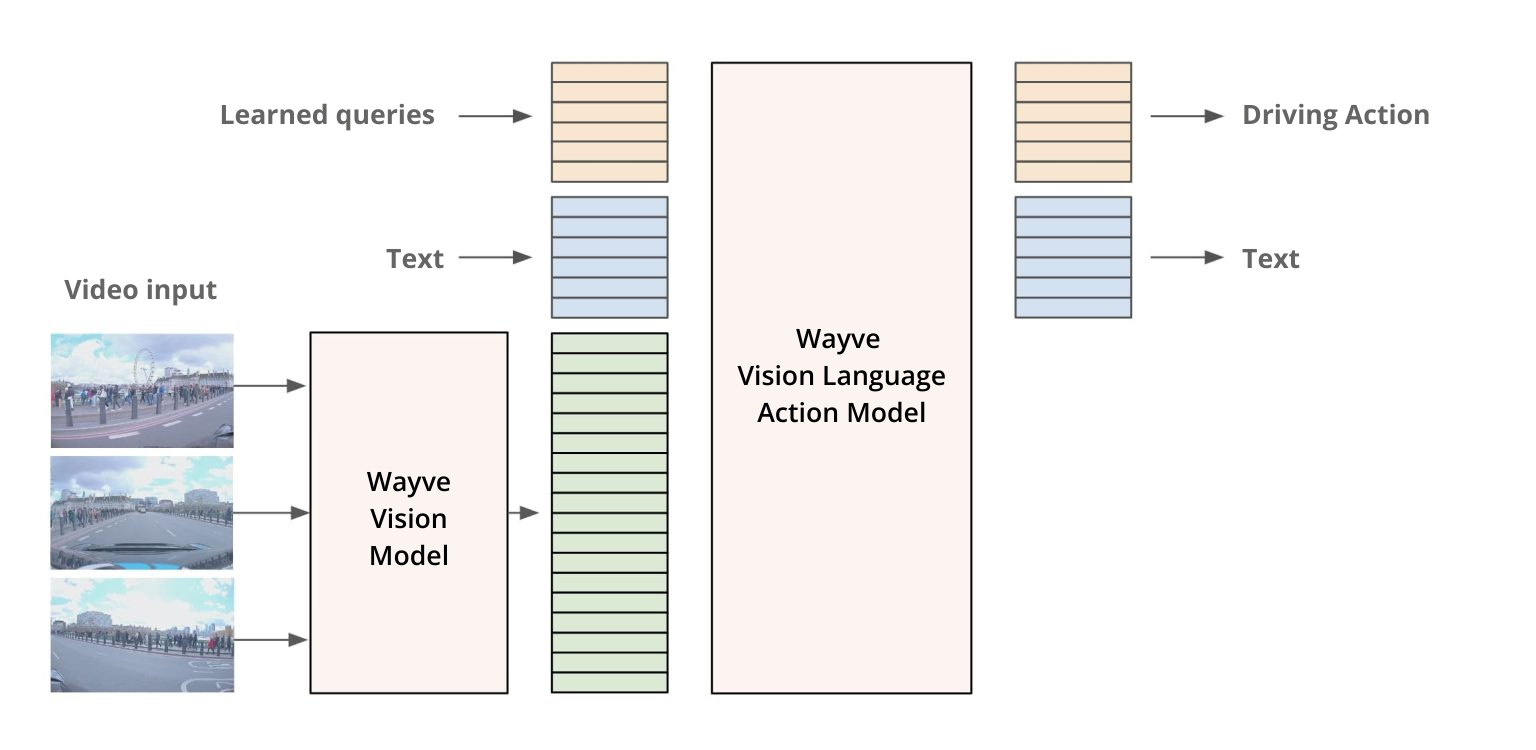
LINGO-2は、Wayveビジョンモデルと自己回帰言語モデルの2つのモジュールで構成されています。ビジョンモデルは、連続するタイムスタンプのカメラ画像をトークンのシーケンスに処理します。これらのトークンと、ルート、現在の速度、制限速度などの追加の条件変数が言語モデルに供給されます。これらの入力を備えた言語モデルは、運転軌道と解説テキストを予測するようにトレーニングされます。その後、車のコントローラーが運転軌道を実行します。
LINGO-2の新しい機能
言語と運転の統合により、自動運転と人間と車両のインタラクションに以下のような新しい機能がもたらされます。
- 言語プロンプトによる運転行動の適応:制約されたナビゲーションコマンド(例:「路肩に寄せる」、「右折する」など)でLINGO-2にプロンプトを出し、車両の行動を適応させることができます。これはモデルのトレーニングを支援したり、場合によっては人間と車両のインタラクションを強化したりする可能性を秘めています。
- リアルタイムでのAIモデルへの問いかけ:LINGO-2は、走行中にシーンや自身の決定に関する質問を予測し、回答することができます。
- リアルタイムの運転解説の取得:ビジョン、言語、アクションを連携させることで、LINGO-2は言語を活用して何をしているのか、なぜそうしているのかを説明し、AIの意思決定プロセスを明らかにすることができます。
以下のセクションでは、ニューラルシミュレーターGhost GymでLINGO-2をテストした例を示しながら、これらのユースケースを探ります。Ghost Gymは、エンドツーエンドのAI運転モデルのトレーニング、テスト、デバッグのために、フォトリアルな4D世界を作成します。現実世界の運転のスピードと複雑さを考慮し、私たちはGhost Gymのようなオフラインシミュレーションツールを活用して、まずLINGO-2の機能の堅牢性を評価します。このセットアップでは、LINGO-2は絶えず変化する合成環境内を自由にナビゲートでき、そこで異なる言語指示を与えて同じシナリオに対してモデルを実行し、モデルがどのように行動を適応させるかを観察できます。これにより、モデルが複雑な運転シナリオでどのように振る舞い、アクションを伝え、言語指示に反応するかについて、深い洞察を得て厳密にテストすることができます。
言語指示による運転行動の適応
LINGO-2は、自然言語による運転指示を独自に可能にします。これを行うために、テキストトークンと運転アクションの順序を入れ替えます。つまり、言語が運転行動のプロンプトになります。このセクションでは、トレーニング目的で言語プロンプトに応じてニューラルシミュレーター内の行動を変更するモデルの能力を実証します。この新しい機能は、制御とカスタマイズの新たな次元を切り拓きます。ユーザーはモデルにコマンドを与えたり、代替アクションを提案したりできます。これは当社のAIのトレーニングにおいて特に価値があり、高度運転支援システムに関連するアプリケーションの人間と車両のインタラクションを強化することが期待されます。以下の例では、同じシーンが繰り返され、LINGO-2が言語指示に従って行動を適応させている様子が観察できます。
例1:交差点の通過
以下の3つのビデオでは、LINGO-2が同じ交差点を通過しますが、「左折、道路に障害物なし」、「右折、道路に障害物なし」、「一時停止線で停止」という異なる指示が与えられています。LINGO-2が指示に従うことができ、それが交差点での異なる運転行動に反映されていることがわかります。
例2:バスの回避
以下の2つのビデオでは、LINGO-2がバスの周囲を走行しています。LINGO-2が指示に従って、待機して「バスの後ろで停止」するか、あるいは「加速してバスを追い越す」ことができることが観察できます。
例3:住宅街での運転
以下の2つのビデオでは、LINGO-2が住宅街を走行する際の言語指示に反応しています。「ルートに従って直進」または「前方の右左折のために減速」というプロンプトに正しく反応できます。
リアルタイムでのAIモデルへの問いかけ:視覚的質疑応答(VQA)
言語のもう一つの可能性は、ロボットカーとユーザーの間にインタラクションの層を構築し、運転モデルの意思決定能力に対する信頼を与えることです。遡及的にしか質問に答えられず、意思決定に直接結びついていなかった以前のLINGO-1研究モデルとは異なり、LINGO-2では実際に運転しているモデルに対して問いかけやプロンプトを出すことができます。
例4:信号機
この例では、LINGO-2が交差点を通過する様子を示しています。モデルに「信号の色は何色ですか?」と尋ねると、「信号は青です」と正しく答えます。
例5:危険の特定
この例では、LINGO-2に「前方に危険はありますか?」という質問でプロンプトを出します。モデルは「はい、前方にサイクリストがいます。そのため減速しています」と正しく特定します。
例6:天候
次の3つの例では、LINGO-2に「天気はどうですか?」と尋ねます。「非常に曇っており、太陽の気配はありません」から「晴れ」、「天気は快晴で、青空に雲が点在しています」まで、天候を正しく特定できます。
限界
LINGO-2は、自然言語を活用してAI運転モデルを強化する当社の進歩における大きな転換点となります。私たちはその進展に期待を寄せていますが、同時にモデルの現在の制限事項についても説明したいと思います。
運転モデルからの言語による説明は、モデルが何を考えているかについて強力な示唆を与えてくれます。しかし、説明と意思決定の整合性を定量化するには、さらなる研究が必要です。今後の課題は、言語、ビジョン、運転のつながりを定量化して強化し、モデルの決定を確実にデバッグおよび説明できるようにすることです。「思考の連鎖(Chain-of-Thought)」による運転に中間的な言語推論を追加することが、エッジケースや反実仮想の解決に役立つことを、現実世界で実証できると期待しています。
さらに、現実世界の環境で言語を使用して車の行動を制御することが、確実かつ安全に行えるかどうかを調査する予定です。Ghost Gymはテストのための安全なオフロード環境を提供しますが、モデルがノイズやコマンドの誤解に対して堅牢であることを確認するには、さらなる取り組みが必要です。モデルは、安全で責任ある運転行動の適切な制限を決して逸脱することなく、人間の指示の文脈を理解する必要があります。この機能は、完全自動運転システムのモデルテストやトレーニングの支援により適したものになるでしょう。
結論
本記事では、公道で走行した初の言語トレーニング済み運転モデルであるLINGO-2を紹介しました。LINGO-2が言語指示に反応し、リアルタイムで運転アクションを説明できる様子をお見せできることを嬉しく思います。これは、言語と運転を皮切りに、複数のタスクを実行できるエンボディドAI(身体化されたAI)を構築するための第一歩です。CVPR 2024のチュートリアル「End-to-End Autonomy: A New Era of Self-Driving(エンドツーエンドの自律性:自動運転の新時代)」で、このトピックやその他のトピックについてぜひ一緒に探求しましょう。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む