








15 10月 2025 | リサーチ
Rig3R:自律走行車のための3D知覚学習
現代の自動運転車は、世界を認識するためにマルチカメラリグに依存していますが、それらのストリームを3D理解に変換することは非常に大きな課題です。Rig3Rは、幾何学的基盤モデルにおける当社の最新の進歩であり、搭載されたカメラリグから堅牢な自己運動と3D構造推定を実現するように設計されています。
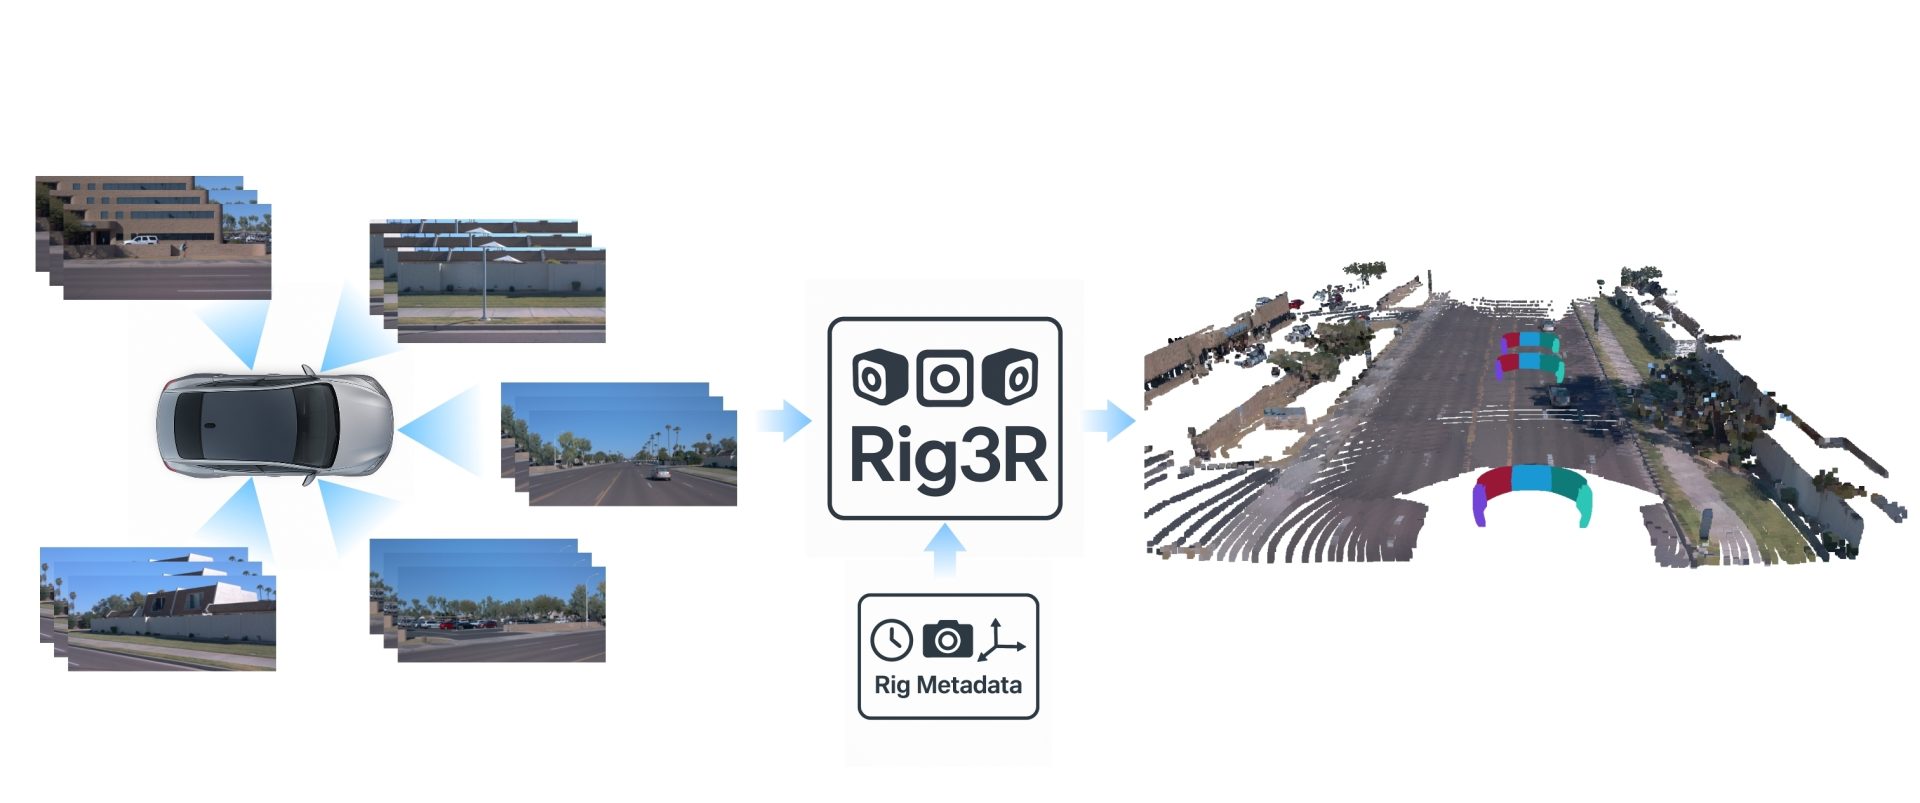
長時間の走行におけるRig3Rの予測された姿勢と3Dポイントマップの可視化。上部にはマルチカメラ入力ビデオストリームが表示され、予測された将来の姿勢が道路に重ねて表示されています。対応するポイントマップ再構築は下部に示されています。完全なリグキャリブレーションが入力として提供されます。
幾何学的基盤モデルの時代へ
自律走行の中核には、AIが世界を3Dで真に理解するのを助けるという、長年の課題があります。
世界の構造と車両の自己運動を堅牢に推定することは、コンピュータビジョンにおいて数十年にわたる研究課題でした。古典的な特徴ベースおよび写真測量法は、長らく多視点幾何学の最先端を定義してきました。しかし、最近の進歩により、大規模なTransformerベースの学習がこのフロンティアをさらに押し進めることが示されています。それでも、これらの手法は、複数のカメラが同期された構造化リグを介して世界を継続的に捉える自律走行車の設定では不十分です。
このギャップに対処するため、当社はRig3Rを発表します。これはWayveが開発した新しいモデルで、マルチカメラリグの正確で堅牢な3D再構築を可能にします。Rig3Rは、リグ制約が利用可能な場合にそれを明示的に活用する初の学習手法であり、複雑な実世界の運転シナリオにおいて最先端の3D理解を実現します。
なぜこれが自律走行車にとって重要なのか
Rig3Rは、VGGTなどの幾何学的基盤モデルをリグ認識の利点によって拡張し、利用可能な場合はリグ情報を活用し、利用できない場合はリグ構造とキャリブレーションを推論します。この柔軟性は、搭載AIシステムに見られる多様で進化するセンサー設定を処理するために不可欠であり、以下の3D理解を提供します。
- 高速 – 単一の順方向パスで複数のフレームとカメラビューを処理します。
- 堅牢 – 構造化されていない画像から、構成が異なる同期リグまで、欠落または不完全なキャリブレーションがあってもシームレスに処理します。
- 高精度 – 実世界の運転ベンチマークにおいて、従来の手法および学習手法を17~45%上回ります。
これらの機能を合わせることで、Rig3Rは実際の運転条件下での信頼性の高い、幾何学を意識した知覚の基盤となり、安全でスケーラブルな自律走行に向けた重要な一歩となります。
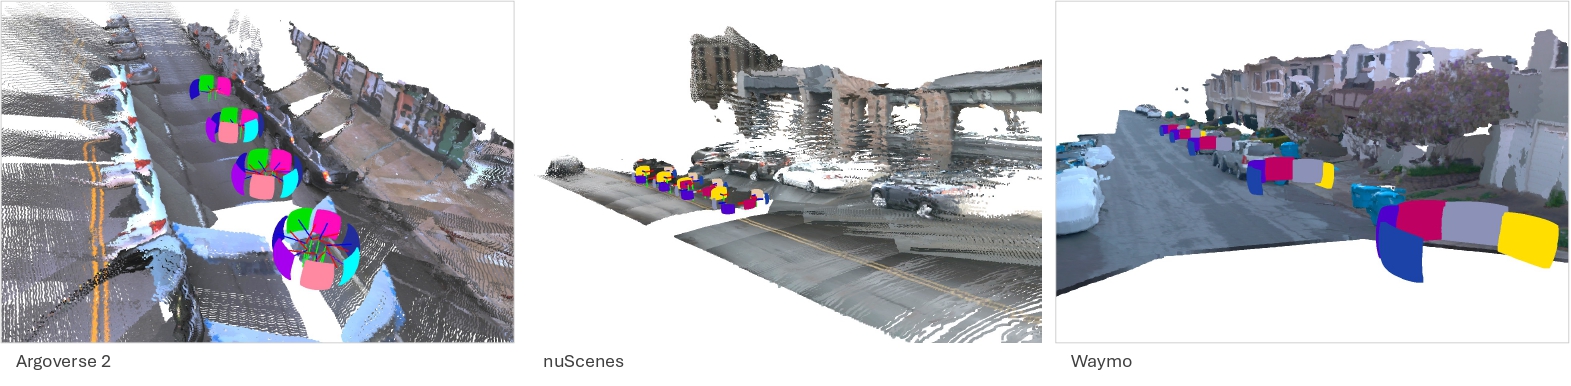
これらは、Argoverse、nuScenes、Waymoの検証セットにおけるリグシーン再構築の例です。色付きの平面は予測されたレイマップを示し、その色は予測されたリグキャリブレーションからのカメラIDに対応しています。リグレイマップ出力はカメラの識別とキャリブレーションを可能にし、リグメタデータ入力は強化された3D再構築と姿勢推定を可能にします。
Rig3Rの仕組み
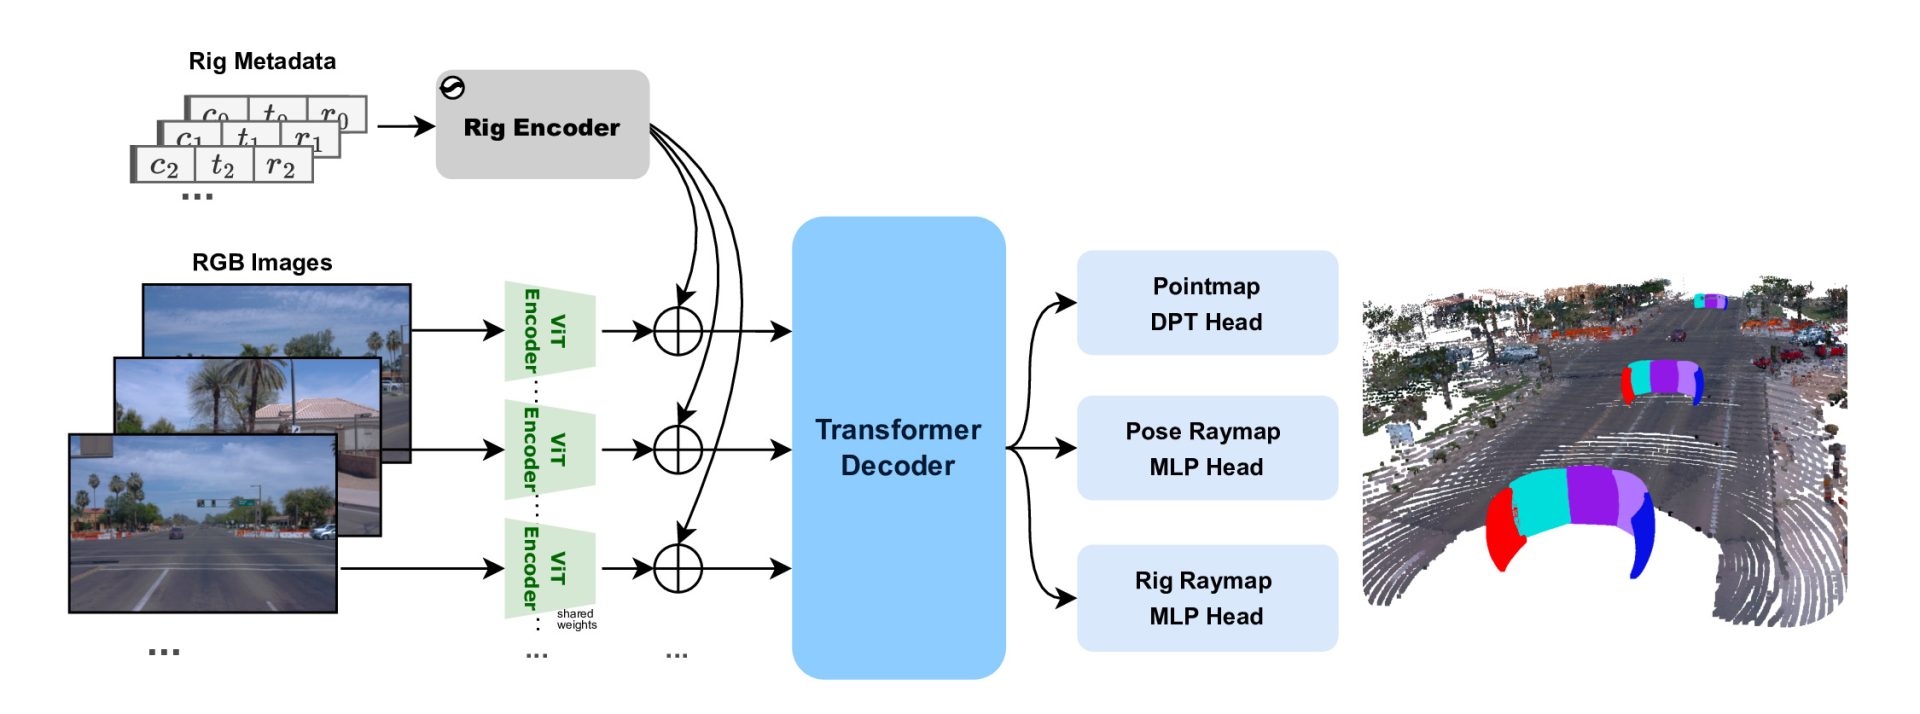
当社の新しい手法Rig3Rについては、会議論文で詳しく説明しており、NeurIPS 2025でスポットライト発表される予定です。Rig3Rは、リグエンコーダを導入し、既知のリグ制約をTransformerのデコーダ融合段階に注入することで、幾何学を意識した多視点推論を可能にします。
各入力画像は、オプションで、カメラID、タイムスタンプ、およびレイマップ(カメラ中心からのピクセルごとの光線で、リグ相対姿勢をエンコードする)で構成されるコンパクトなメタデータタプルを保持できます。これらのフィールドは、多視点アライメントを強力にガイドする幾何学的および時間的コンテキストを提供します。重要なことに、Rig3Rは、利用可能な場合はリグメタデータを活用し、情報が欠落している場合でも堅牢性を維持するように訓練されています。
アーキテクチャの概要
共有画像エンコーダ
ViT-Largeエンコーダは、各入力画像を2Dサインコサイン位置埋め込みを持つパッチトークンに変換します。
メタデータ埋め込み
各パッチについて、Rig3Rは3種類のメタデータを追加します。camera ID、timestamp、および6Dレイマップパッチです。離散フィールド(カメラIDとタイムスタンプ)は1Dサインコサイン埋め込みを使用してエンコードされ、レイマップは線形に投影され、画像トークンと連結されます。トレーニング中、各メタデータフィールドは堅牢性を高めるためにランダムにドロップされます。これにより、Rig3Rは利用可能な場合はメタデータを活用し、利用できない場合は画像コンテンツとクロスビュー関係から欠落したコンテキストを推論することを学習します。各フレームには、完全なドロップアウト下でも識別可能であるように、一意のランダムIDも含まれます。
多視点デコーダ
2番目のViT-Largeは、多視点融合デコーダとして機能し、すべての画像(ビューとタイムステップ)を横断して共同でアテンションします。利用可能なメタデータに条件付けすることで、空間的、時間的、幾何学的キューを共有潜在空間内で融合し、Rig3Rの多視点3D理解の中核を形成します。
3つの予測ヘッド
ポイントマップヘッド:DPTスタイルのヘッドで、信頼度マップとともにピクセルごとの3Dポイントを予測します。
姿勢レイマップヘッド:ピクセルごとの光線方向とグローバルカメラ中心を予測するMLPヘッドで、カメラ姿勢推定を可能にします。
リグレイマップヘッド:ピクセルごとの光線方向とリグフレームカメラ中心を予測するMLPヘッドで、リグキャリブレーション推定を可能にします。
これら3つのヘッドを組み合わせることで、Rig3Rは、密な3D再構築、カメラ姿勢推定、リグキャリブレーションなど、幅広い下流タスクを単一の順方向パス内で実行できます。
トレーニングレシピ
Rig3Rは、以下のタスクを共同で監督するマルチタスク目的でトレーニングされます。
- 信頼度重み付け3Dポイントマップ予測
- グローバルレイジオメトリ予測
- リグ中心レイジオメトリ予測
レイマップ損失は、光線方向とカメラ中心の両方からの誤差を重み付き合計で結合します。総トレーニング損失は、これらのタスク目的の重み付き組み合わせとして計算され、Rig3Rがビューとフレーム全体で一貫したリグ認識3D表現を学習することを促します。
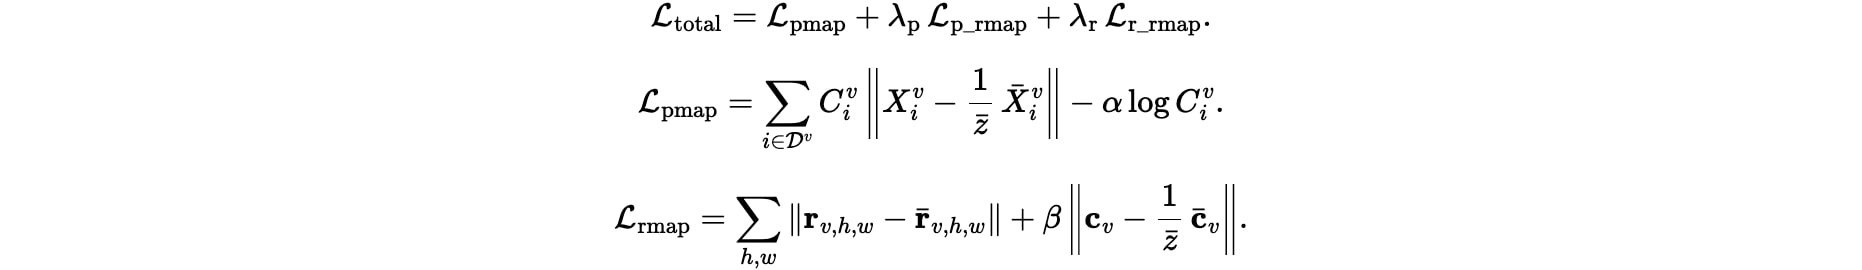
Rig3Rは、屋内、運転、合成、オブジェクト中心のデータセットにわたる多様なコーパスでトレーニングされており、マルチカメラリグに意図的に重点が置かれています。この設計により、モデルは幅広いリグ構成に触れ、リグ埋め込みを効果的に活用できます。トレーニングコーパスには、外部データセットとWayveの内部運転データの両方が含まれます。
データサンプリング戦略は、各データセットタイプに合わせて調整されています。
- COLMAP再構築データセットの場合、画像は視覚的な重複を確保するために共視性によってサンプリングされます。
- 画像データセットの場合、フレームはモーションの大きさを変えるためにランダムな時間的ストライドで抽出されます。
- リグベースのシーケンスの場合、リグジオメトリの多様性を高めるためにカメラがサブサンプリングされ、通常、フレーム間の重複を維持し、一般的な単眼設定を反映するために少なくとも1つの前方カメラが保持されます。
異種データセットとターゲットサンプリング戦略のこの組み合わせは、Rig3Rのトレーニング分布を大幅に広げ、シーンタイプ、リグ構成、および時間スケール全体で強力な汎化を促進します。
実験
ベンチマークとセットアップ
Rig3Rは、2つのマルチカメラ運転ベンチマークで評価されます。Waymo Open検証セットとWayveScenes101です。Waymo OpenはLiDARベースのグラウンドトゥルース姿勢とポイントを提供し、WayveScenes101はCOLMAP再構築をグラウンドトゥルースとして使用します。本論文で提示されるRig3Rのバージョンでは、モデルはWaymoトレーニング分割でトレーニングされており、Waymoリグはトレーニング中に見られます。対照的に、WayveScenes101のリグは一度も観測されておらず、汎化のための分布外(OOD)テストとして機能します。
両方のベンチマークは、約200フレーム/シーンを10 FPSでキャプチャする5カメラリグを使用しています。各シーンについて、約2秒間隔で2つの24フレームクリップ(完全な5カメラリグ)を抽出します。Rig3Rの複数の構成を、いくつかのフィードフォワードベースライン、および古典的な構造からの運動(SfM)およびリグ認識手法と比較してベンチマークします。
当社の評価タスクは、2つの目標に焦点を当てています。
- 姿勢推定は、5°および15°のしきい値での相対回転精度(RRA)と相対並進精度(RTA)、および30°までの平均精度(mAA)を使用して報告されます。
- 3Dポイントマップ再構築は、精度、完全性、およびChamfer距離を使用して評価されます。
結果:姿勢推定とポイントマップ再構築
以下の図は、Fast3R、DUSt3R-GA、Rig3R(非構造化)、Rig3R(リグ制約あり)の4つの手法における姿勢推定とポイントマップ再構築を、同じ運転シーンで比較したものです。この進展は、Rig3Rのリグ認識が幾何学的コヒーレンスと再構築品質の両方をどのように向上させるかを明確に示しています。ベースライン手法がノイズの多い、または空間的に一貫性のないポイントマップと姿勢を生成することが多いのに対し、Rig3Rはより鮮明で一貫性のある構造を生成し、すべてのビューで合理的に整合するリグ姿勢を実現します。
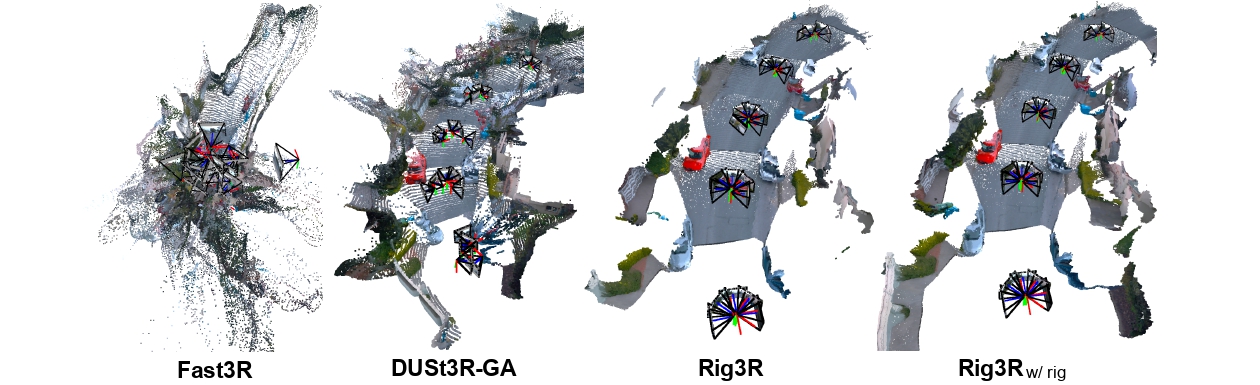
手法間の定性比較。ベースラインモデルは、不安定な構造、姿勢、リグジオメトリにより、よりぼやけて一貫性のない再構築を生成します。Rig3Rは、一貫性のある軌道と空間的に一貫性のある3D再構築を生成し、リグ制約を組み込むことで、視覚的外観が改善され、回復されたリグジオメトリがさらに洗練されます。
以下の棒グラフは、Waymo OpenとWayveScenes101における姿勢推定性能をまとめたものです。薄い色の棒(Rig3RとCOLMAPの場合)は、リグメタデータを活用することによる性能向上を示しています。Rig3R(非構造化)は、リグ構成がトレーニング中に見られたWaymoでは、すでにすべてのベースラインを上回っており、リグキャリブレーションを組み込むことで、回転および並進精度がわずかながら一貫して向上します。リグが見られないWayveScenes101では、リグメタデータの効果ははるかに顕著です。リグ制約付きのRig3Rは、最高の全体精度を達成し、mAAを大幅に改善し、幾何学的誤差を削減します。すべてのベースラインの中で、COLMAPのみがリグ制約を活用できますが、Rig3Rはこれを効果的に行う最初の学習モデルであり、リグ事前情報を組み込むことで、新しいマルチカメラ設定への強力なゼロショット汎化が可能になることを示しています。これらの傾向は、姿勢推定とポイントマップ再構築の両方のメトリックで一貫して保持されます。詳細な定量的結果と拡張された議論については、当社の 論文を参照してください。
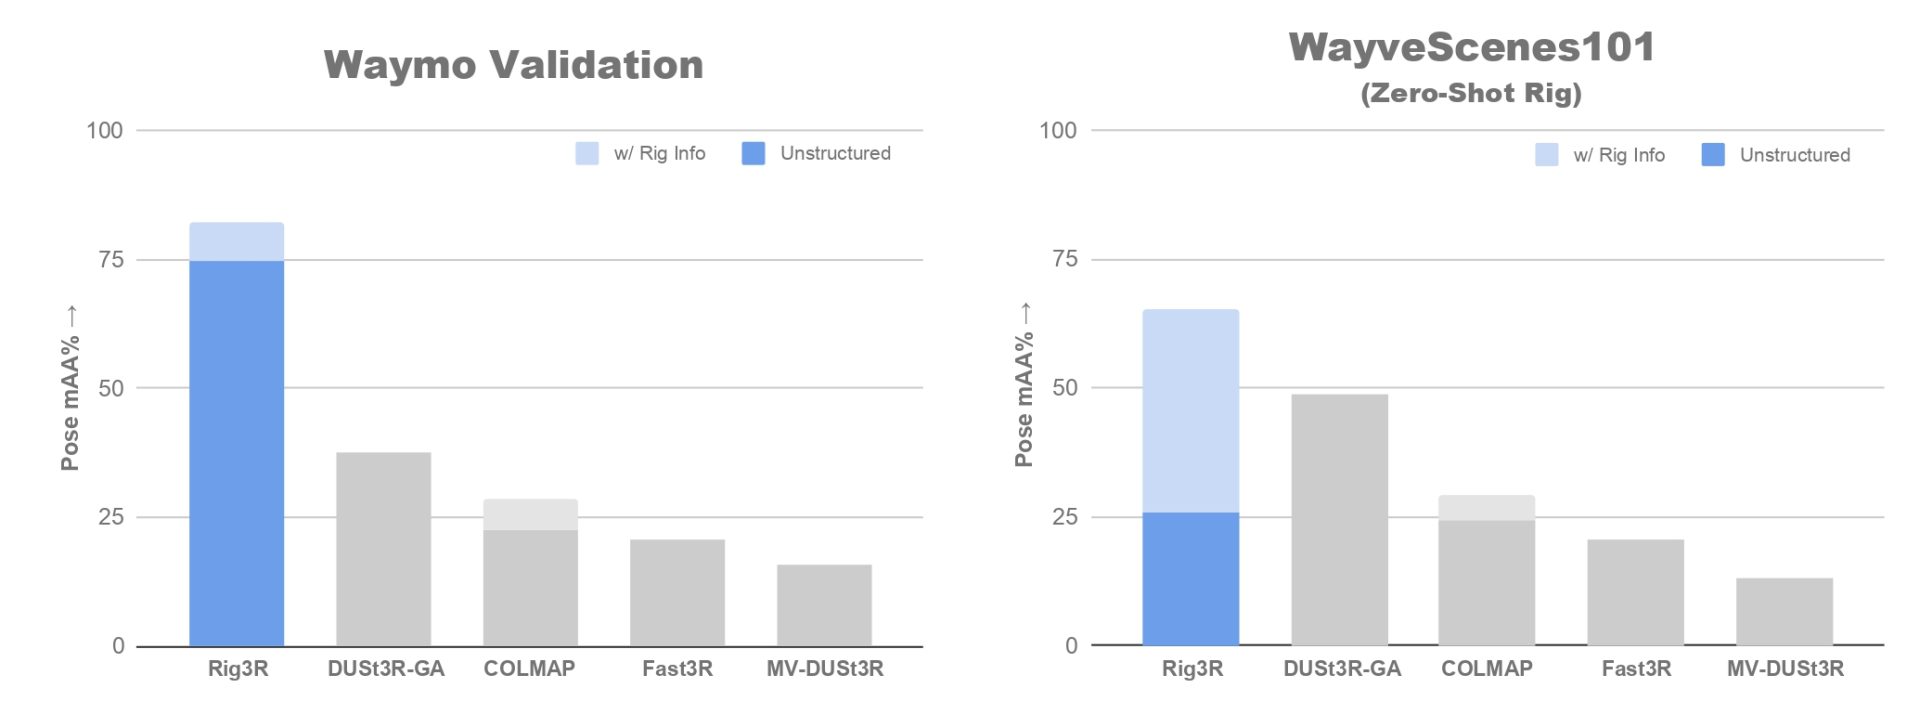
Waymo OpenおよびWayveScenes101ベンチマークにおける姿勢推定の定量的結果。Rig3Rは両方の設定ですべてのフィードフォワードベースラインを上回り、リグ制約の組み込みは、未見のWayveScenes101リグで最大のゲインをもたらします。COLMAPのみがリグメタデータを活用できますが、Rig3Rはこれを効果的に行う最初の学習モデルであり、新しいマルチカメラ設定への強力なゼロショット汎化を示しています。
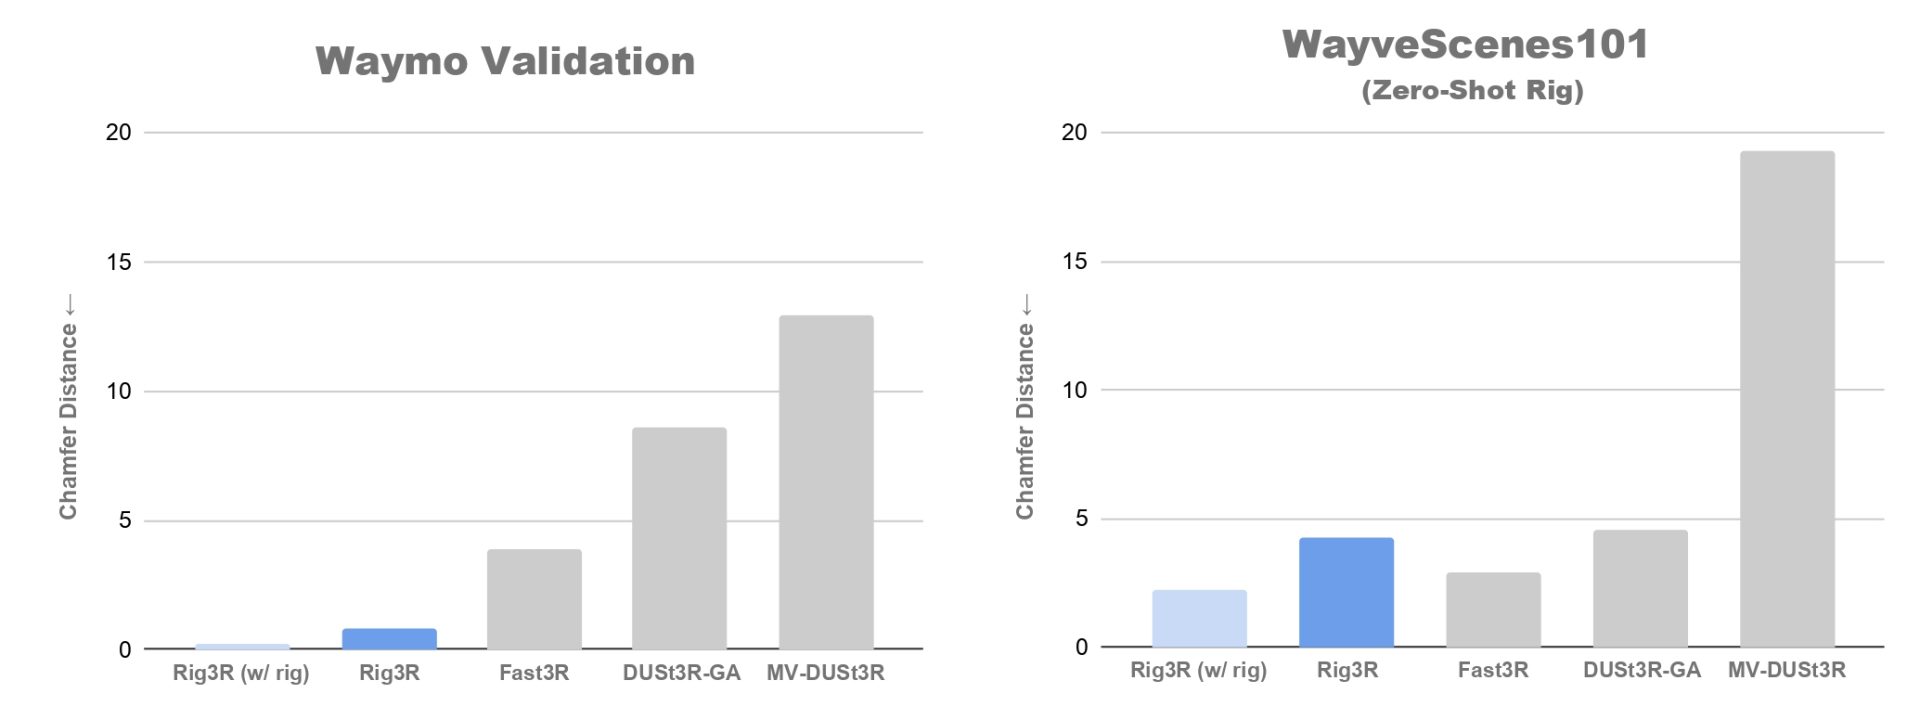
ポイントマップ再構築の定量的結果。傾向は姿勢推定で観察されたものと類似しており、Rig3Rが全体的に最高の性能を達成し、リグ制約が適用された場合、未見のWayveScenes101リグで最大のゲインをもたらします。
メタデータが重要な理由
以下の例では、カメラIDやタイムスタンプからリグ姿勢、そして最終的に完全なセットに至るまで、異なる形式のメタデータがRig3Rの性能にどのように貢献するかを分析します。より多くのメタデータが導入されるにつれて、姿勢推定とポイントマップ再構築の両方が改善されます。予測されたカメラ軌道は物理的なリグと徐々に整合し、再構築されたポイントマップはより鮮明で一貫性のあるものになります。この分析は、搭載システムやロボットシステムで容易に利用できるこのような構造化された事前情報が、学習された幾何学的モデルに効果的に統合され、精度と汎化の両方を向上させることができることを示しています。
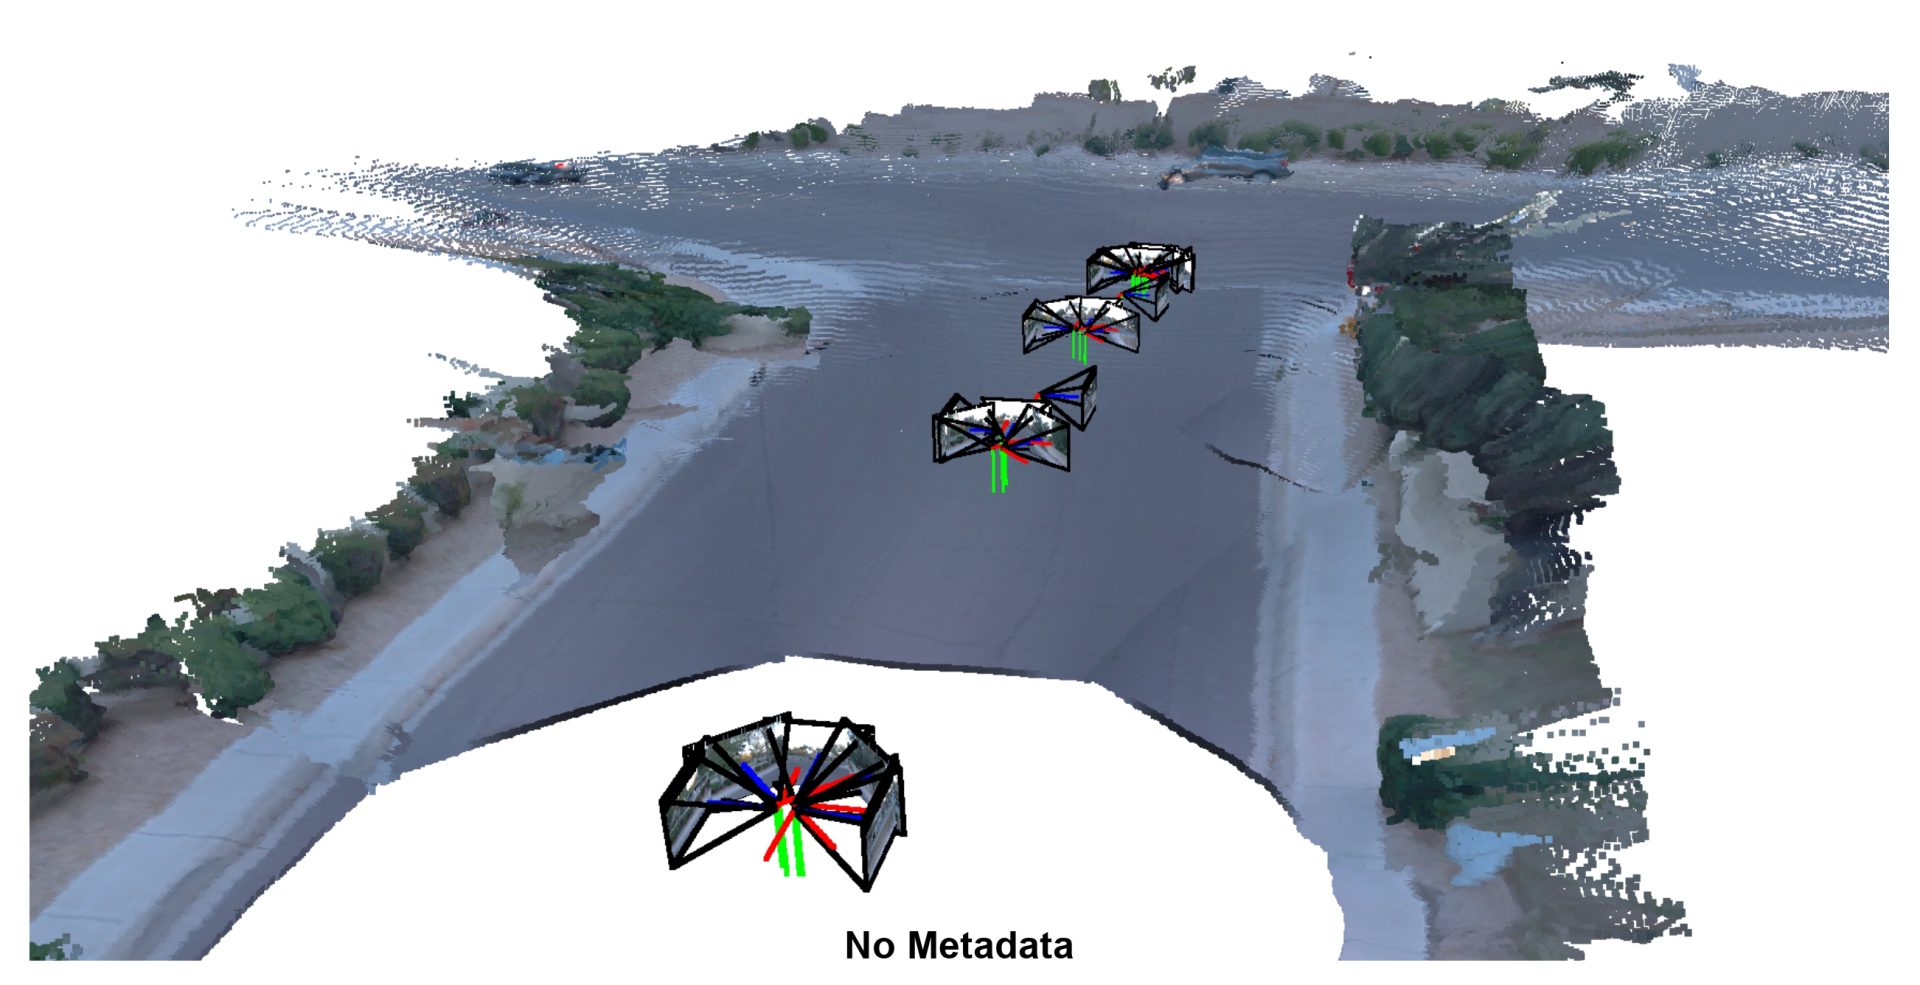
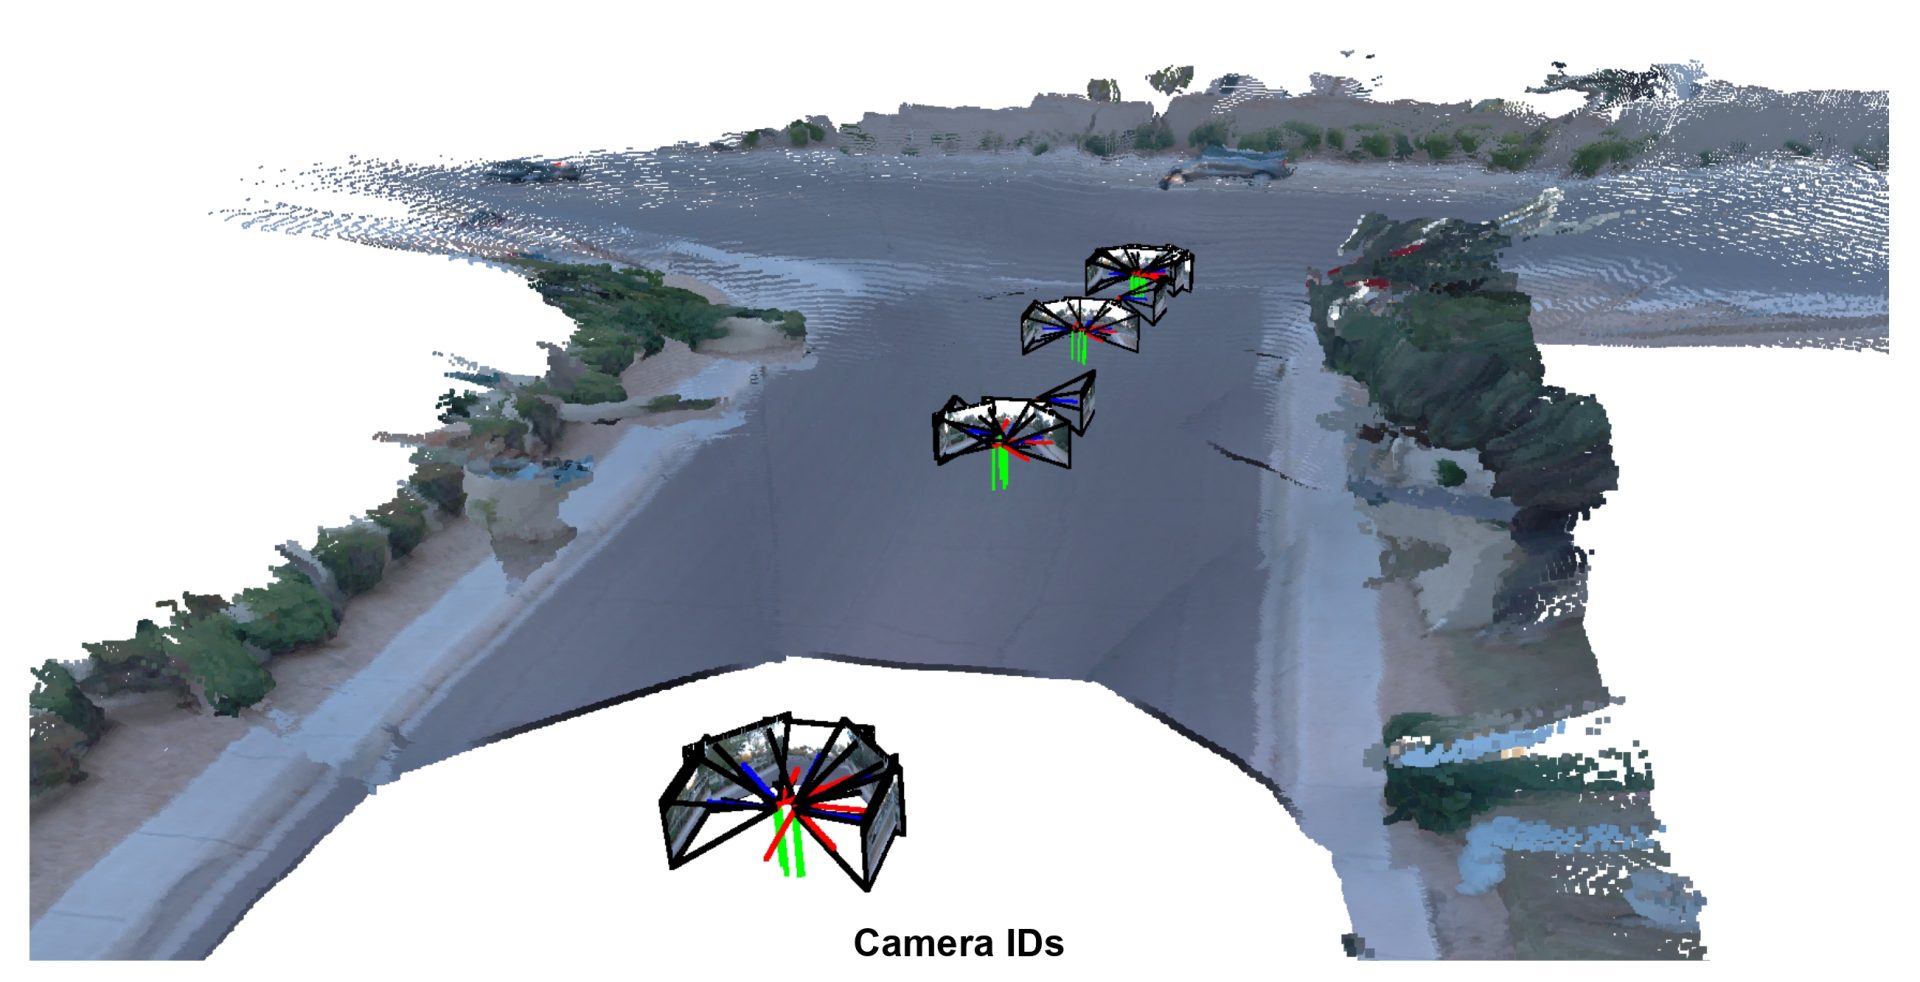
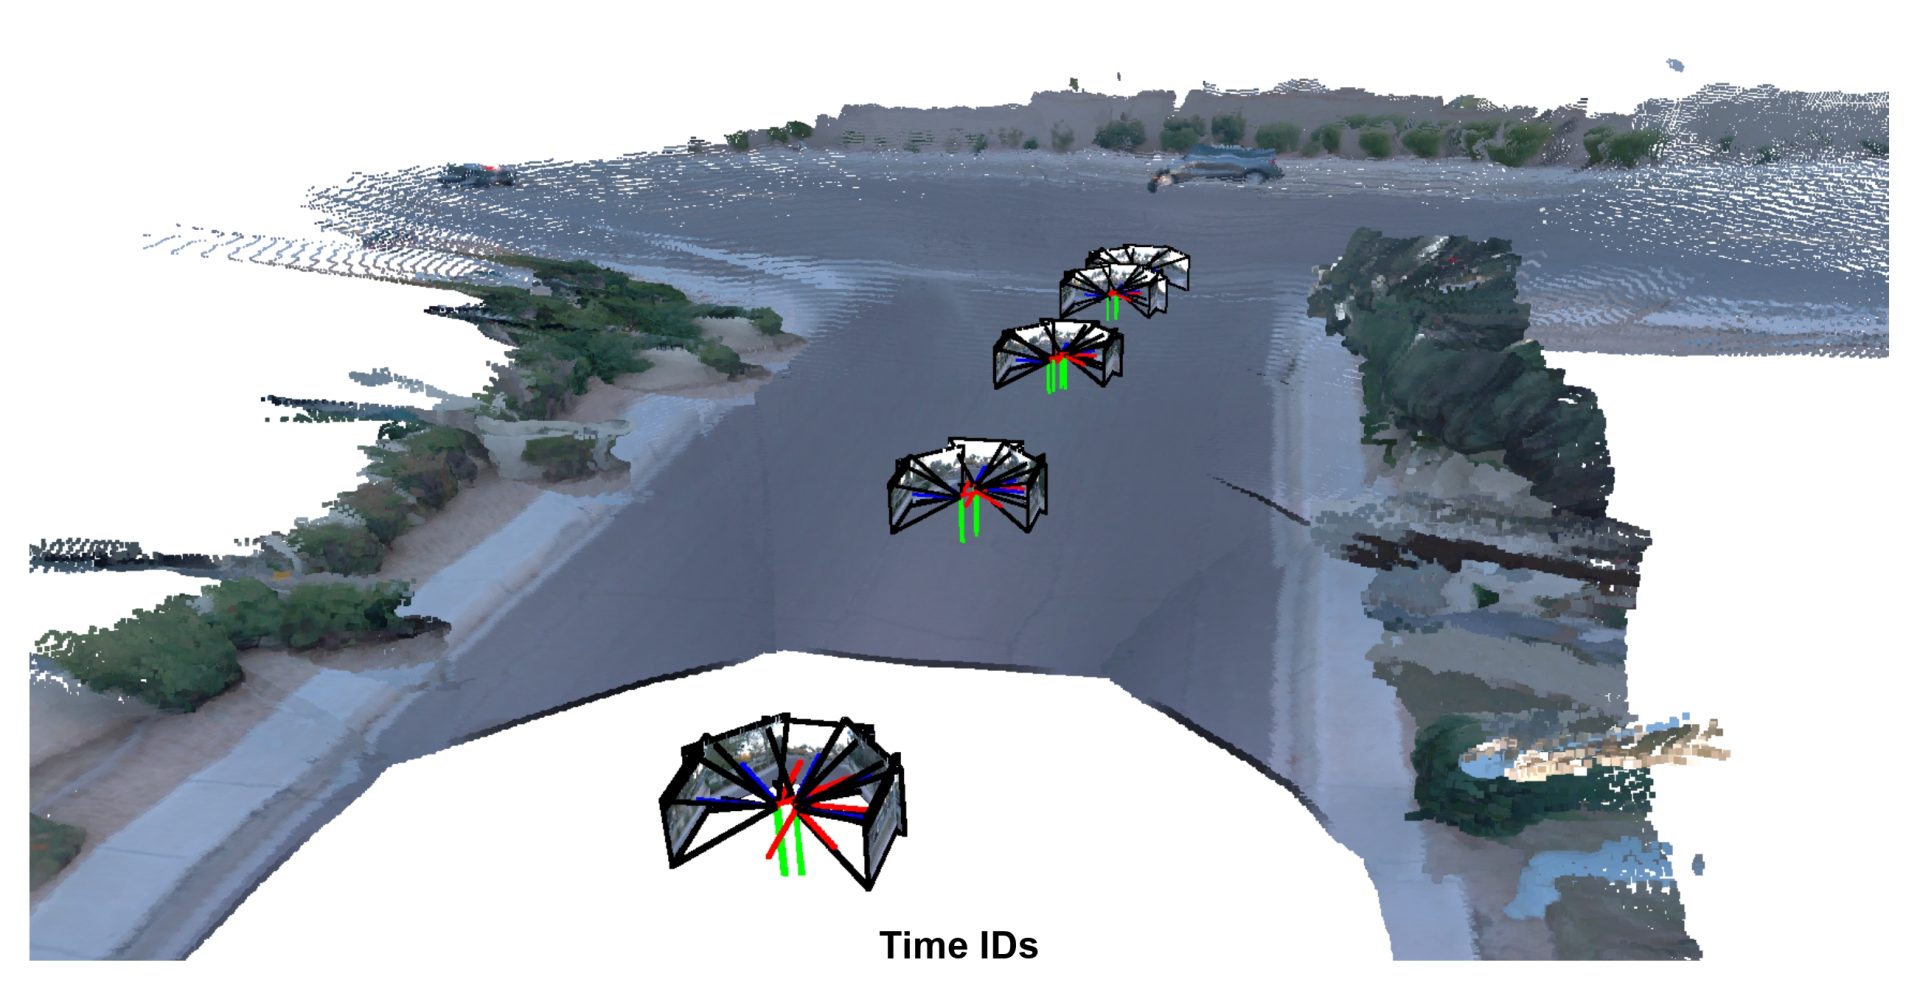
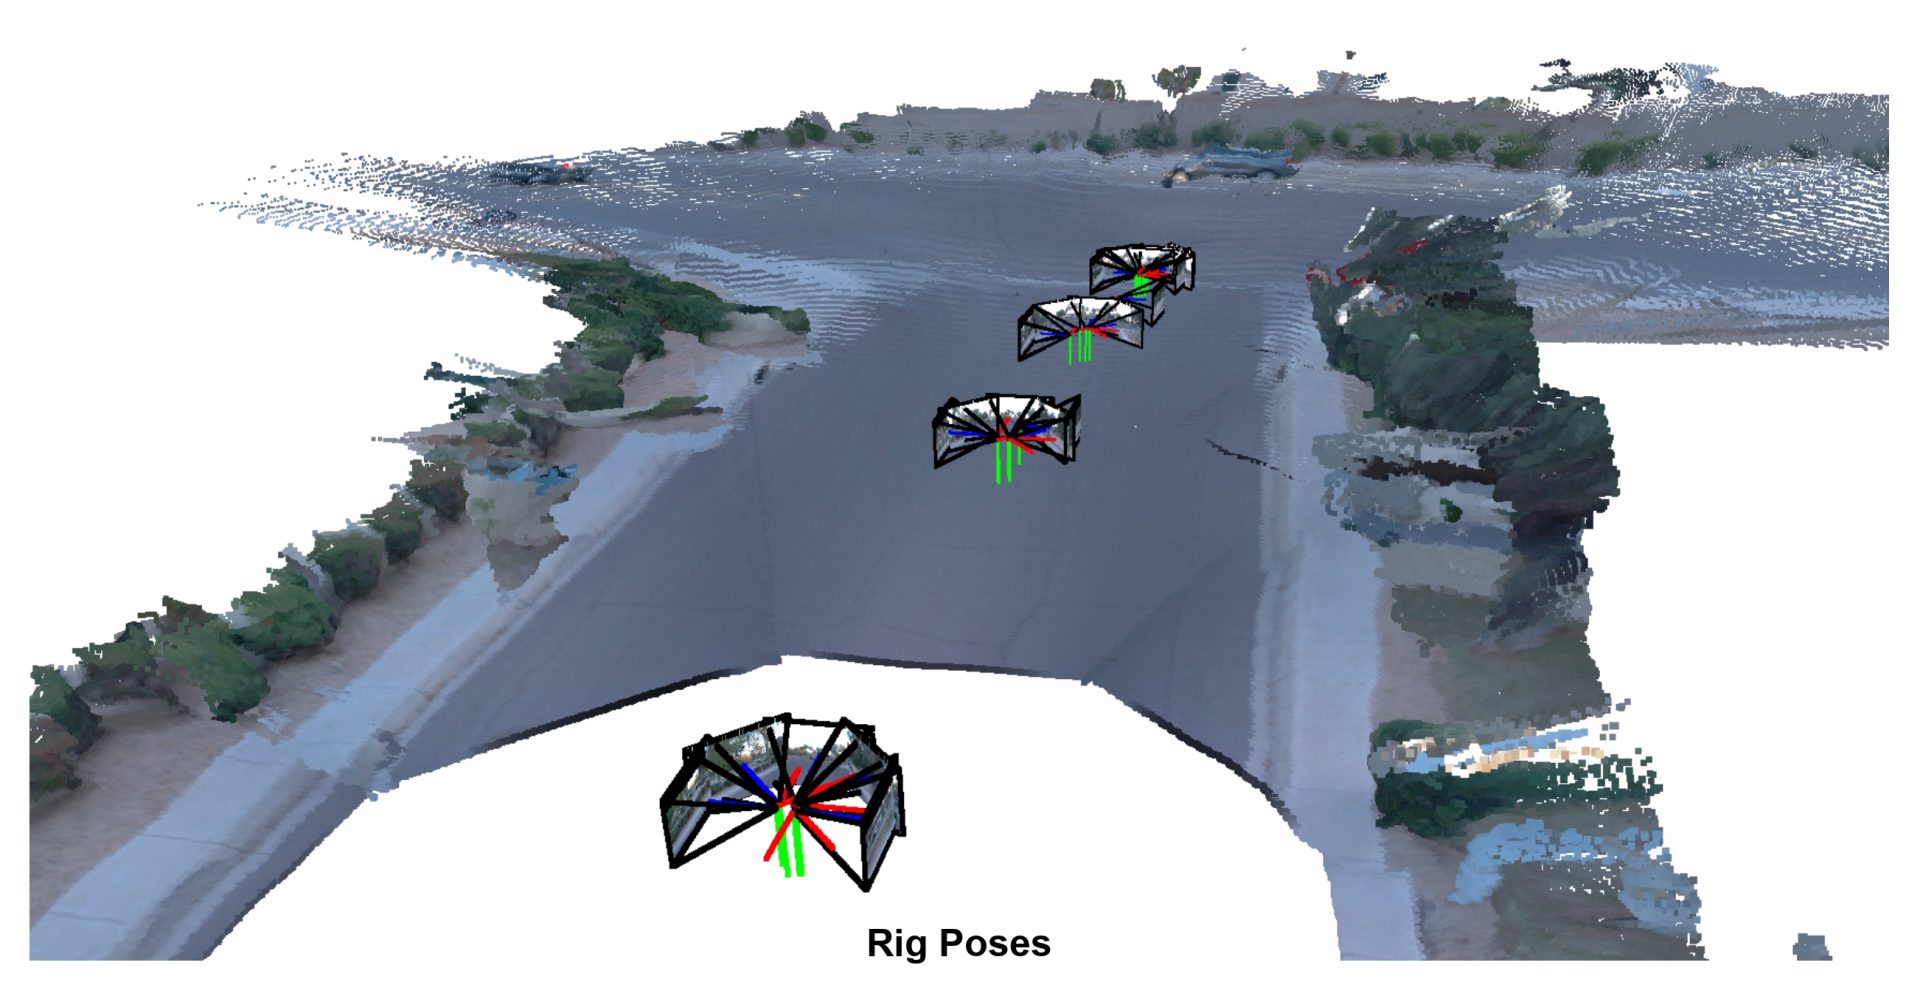
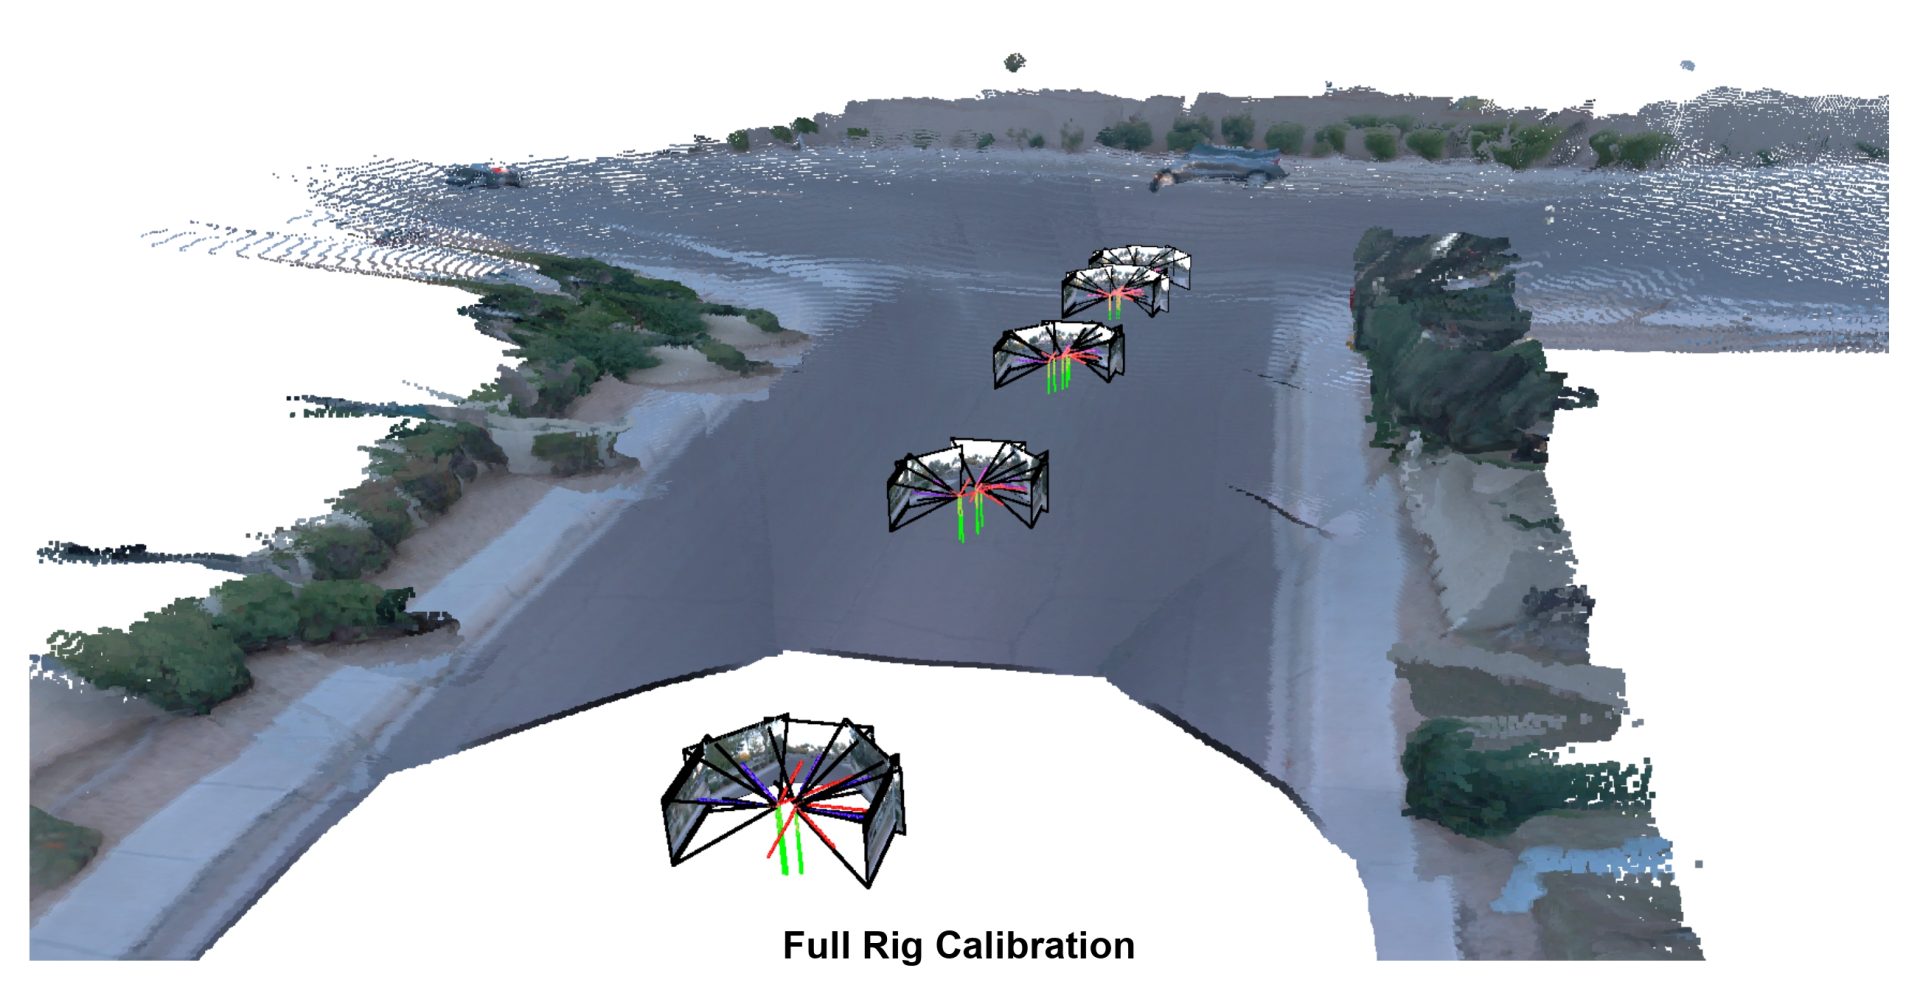
Rig3Rの性能は、メタデータが提供されるにつれて着実に向上します。メタデータなしの状態から、完全なセット(カメラID、タイムスタンプ、リグ姿勢)までです。モデルは、すべてのメタデータフィールドが利用可能な場合に最高の3D再構築と姿勢推定精度を達成します。
スケーラビリティと汎化
Rig3Rは、幅広いリグ構成と環境において、強力な姿勢推定と密な3D再構築を実現します。短いベースラインから長いベースライン、多様な視野と解像度、さまざまなフレームレートで堅牢に機能します。Rig3Rは、昼夜の照明変化、高速によるモーションブラー、雨、雪、まぶしさ、低テクスチャシーンなどの困難な条件下でも信頼性を維持します。以下のビデオは、これらの多様な設定におけるRig3Rの性能を示しています。
大規模な場合でも、Rig3Rは多様な運転シーケンス全体で一貫した安定した軌道を生成し、急カーブ、停止、オクルージョンを通じて精度を維持します。強力なクロスデータセット汎化を示し、シーンごとの調整なしに、キャリブレーションされたマルチカメラリグから混合または未キャリブレーションのセットアップ、さらには単眼入力にシームレスに移行しながら、信頼性の高い姿勢と高忠実度の再構築を維持します。これらの機能は、大幅な変動、センサーノイズ、不完全なメタデータにもかかわらず、自己運動と密な3D構造を回復し続ける実世界の運転ビデオにも拡張され、マッピング、再ローカライゼーション、搭載AIトレーニングなどの下流タスクにすぐに利用できる出力を提供します。
単一カメラの近傍でも、Rig3Rは強力な性能を発揮します。上記のビデオは、RGB入力とタイムスタンプのみを使用して、多様な実世界の運転データに対するRig3Rの堅牢な出力を示しています。
今後の課題と結論
空間的にインテリジェントな基盤モデルを構築する探求には、まだ多くの未解決の問題が残っています。トレーニングのスケールアップに加えて、Rig3Rの将来の改善点としては、ストリーミング表現、シーンモーションの処理、マルチモーダル入力、複数の搭載形態、マルチタスク出力などが挙げられます。
Wayveでは、Rig3Rを使用して3D世界理解、合成、基盤モデリング機能を向上させています。これは、オーダーメイドのキャリブレーションや脆弱な幾何学パイプラインなしに、複数のハードウェア構成に適応できるスケーラブルな自律走行への一歩です。最終的に、Rig3Rの将来のバージョンは、物理世界を真に理解し、あらゆるビデオから3Dジオメトリとモーションを回復して、ピクセルを行動可能な空間コンテキストに変換する搭載AIに私たちを近づけるでしょう。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む