








16 3月 2022 | エンジニアリング
自律走行性能の測定。第4部:ドライバー スコア 2.0 の導入
本稿は連載記事の第4部です。データサイエンスの最新技術を用いて、いかに自律走行の評価指標を進化させてきたか、その詳細を掘り下げます。具体的には、実世界での走行テストのあらゆるキロメートルから収集するデータインサイトの速度と堅牢性を、機械学習を用いていかに加速させているかを探ります。より優れた性能評価指標を持つことで、当社の研究開発チームは迅速に反復作業を行い、より焦点を絞った実験を実施できます。データサイエンスの最新手法を適用することで、より少ない実世界での走行テストのサンプルから多くのことを学ぶことができ、モデルのトレーニングとテストをより迅速に行うことが可能になります。
このシリーズを初めてお読みになる方は、自律走行のためのスケーラブルな評価フレームワークを構築するために必要なことについて議論している第1部、第2部、第3部をご覧ください。
データサイエンスで自律走行性能を加速させる
Wayveのデータサイエンスチームは、自律走行システムのインテリジェンスを測定するための新しい手法を開拓するという、複雑で魅力的な機会に直面しています。私たちの目標は、機械学習(ML)の研究開発チームが、実世界でのテストからより迅速に学習し、より堅牢な洞察を得られるようにする最先端の手法を実装することです。これにより、Driver Score 2.0のような新しい指標を作成することが可能になります。これは、都市部の運転の複雑さを捉え、多様な運転シナリオにおけるモデル性能を比較することを可能にします。
MLRATE(Meta、2022年)のような最新のデータサイエンス手法を適用することで、統計的に有意な結果を堅牢に達成するために必要な実世界での走行量を半分にできるため、反復作業をより迅速に行うことができます。
運転性能の測定がこれほど難しいのはなぜか?
2つのモデル間の運転性能の違いを比較する際の課題の1つは、運転条件が日ごと、分ごとに大きく異なることです。各テスト走行では、モデルは天候、交通状況、道路工事、他の道路利用者、歩行者、自転車利用者との遭遇など、非常に多様な変数に遭遇します。同じルートであっても、同じテスト走行は2つとありません。
そのため、業界標準の指標である「走行1,000キロメートルあたりのディスエンゲージメント数」は、自律走行システムの能力を評価する上で限定的な価値しか提供しません。この指標は、走行した距離の難易度を考慮しておらず、より単純なルートを走行することで操作される可能性があります。また、当社の研究開発チームが、自律走行システムの「運転インテリジェンス」が学習した運転行動を改善したかどうかを知るために必要なレベルの洞察も提供しません。ロンドンのような複雑な都市環境で運転するモデルをトレーニングするには、多様な交通状況下での無防備な右折など、非常に特定の運転シナリオにおける性能を評価するために、迅速に収集できる堅牢な指標が必要です。
運転モデルの進捗を公平に追跡する、より良い指標をどのように作成しますか?
自律走行性能のより洞察に満ちた測定基準を作成するため、当社のデータサイエンスチームはDriver Score 2.0で4つの目標を達成することに着手しました。
- モデルを比較する際により堅牢な結論を出すこと
- より少ない実世界での走行データサンプルに基づいて、より迅速に結論に達すること
- 「典型的なロンドンでの運転」のような異なる運転シナリオにより適するようにモデル比較を調整すること
- 走行したすべての実世界でのキロメートルから可能な限り多くの洞察を引き出すこと
モデル開発において、多くのAV企業が直面する主要なボトルネックは、堅牢な性能測定のために十分な実世界でのテストデータを収集するのに時間がかかり、それが反復速度を遅らせる可能性があることです。より迅速に学習するために、Wayveは最新の機械学習技術を適用し、より少ないテストデータサンプルからより豊富な洞察を収集しています。これを達成することで、当社の研究開発チームは迅速に反復作業を行い、より焦点を絞った実験を実施できます。これは、自律走行性能を効率的に向上させるための重要な手段です。
さらに、すべての実験において実世界での運転条件の分布が常に同一であるとは限らないため、都市部の運転の複雑さを考慮しつつ、走行間の変動性を低減できるソリューションを見つける必要がありました。変動する運転条件を、実験時に平均化されるノイズとして扱うのではなく、すべての相互作用から学習するためのシグナルとして利用しています。
背景:単純なA/Bテストは運転性能の測定には非常に非効率的である可能性がある
ランダム化比較試験(RCT)は、従来、改善を測定するためのゴールドスタンダードとされています。RCTは、データサイエンティストによって機械学習(ML)モデルをオンラインでテストするためによく使用され、通常、ユーザーベースをコントロールグループ(古いMLモデルで処理されたユーザー)とバリアントグループ(新しいMLモデルで処理されたユーザー)にランダムに分割します。次に、2つのグループ間の特定の指標の平均値の差を観察します(A/Bテスト、「差の平均推定器」を導出)。
これらのA/B実験では、このプロセスで数百万のデータポイントが収集されることがよくあります。テストのための代表的なサンプルを確保するためには、大規模なランダム化が重要です。ランダム化はまた、より公平な比較を促進し、測定された改善が単なるノイズではなく本物であるという統計的信頼性を高めます。
しかし残念ながら、大規模なランダム化は実世界での運転には機能しません。
ルートをランダムにテストする場合、当社のデータサンプルは、交通島から建設区域、一方通行まで、運転モデルが走行しなければならない風景に大きな違いが生じます。膨大なサンプルサイズの恩恵がなければ、このばらつきは私たちの結論に不確実性をもたらすでしょう。実世界でのテストでは、すべての新しいモデルに対してそれほど多くの運転データを収集することは現実的ではありません。特に、研究者やエンジニアが迅速に反復作業を行う必要がある場合にはなおさらです。
同じルートで2つの運転モデルをテストすること(すなわち、ペアテスト)でさえ、この問題を解決しません。なぜなら、同じルートは2つとないからです。例えば、車や自転車のような動的なエージェント、あるいは一方のモデルが常に青信号を見ていたのに対し、もう一方のモデルが常に赤信号を見ていたというシナリオでさえ、制御することはできません。
さらに、特定のルートに限定すると、データがこれらの特定のルートに過学習する可能性があり、どこでも運転できるモデルを構築することが妨げられます。代わりに、私たちは、車がこれまで運転したことのない地域でどれだけうまく機能するかを評価するために、多数のルートで運転したモデルを比較できる必要があります。
A/Bテストが不十分であるならば、実世界での運転データから統計的有意性をより迅速に得るために、どのような分散低減手法を使用できるでしょうか?
データサイエンティストは、より少ないサンプルサイズでは統計的信頼性をもって解析するには小さすぎる真の改善の検出を向上させるために、分散低減手法をよく採用します。
例えば、交通密度が低い場合、ドライバーは環状交差点でより高い性能を発揮し、交通密度が高い場合はそうではないことがわかるかもしれません。したがって、すべての交通密度で環状交差点の性能を測定すると、性能の分散が大きくなります。これにより、観察された性能改善が本物であるのか、それとも偶然によるものなのか、確信が持てなくなります。しかし、交通密度が低い場合にドライバーがより良い性能を発揮すると予想される場合、分散をノイズとして扱うのではなく、この既存の知識を実験に組み込むことで、統計的有意性により迅速に到達すべきです。
分散低減に用いられる一般的な手法は、既存データを用いた制御実験(CUPED、Microsoft 2013)です。これは、線形共変量(交通密度など)を用いて、単純な差の平均推定量を調整するものです。CUPEDは、線形に関連する少数の変数に対して分散低減に非常に効果的です。
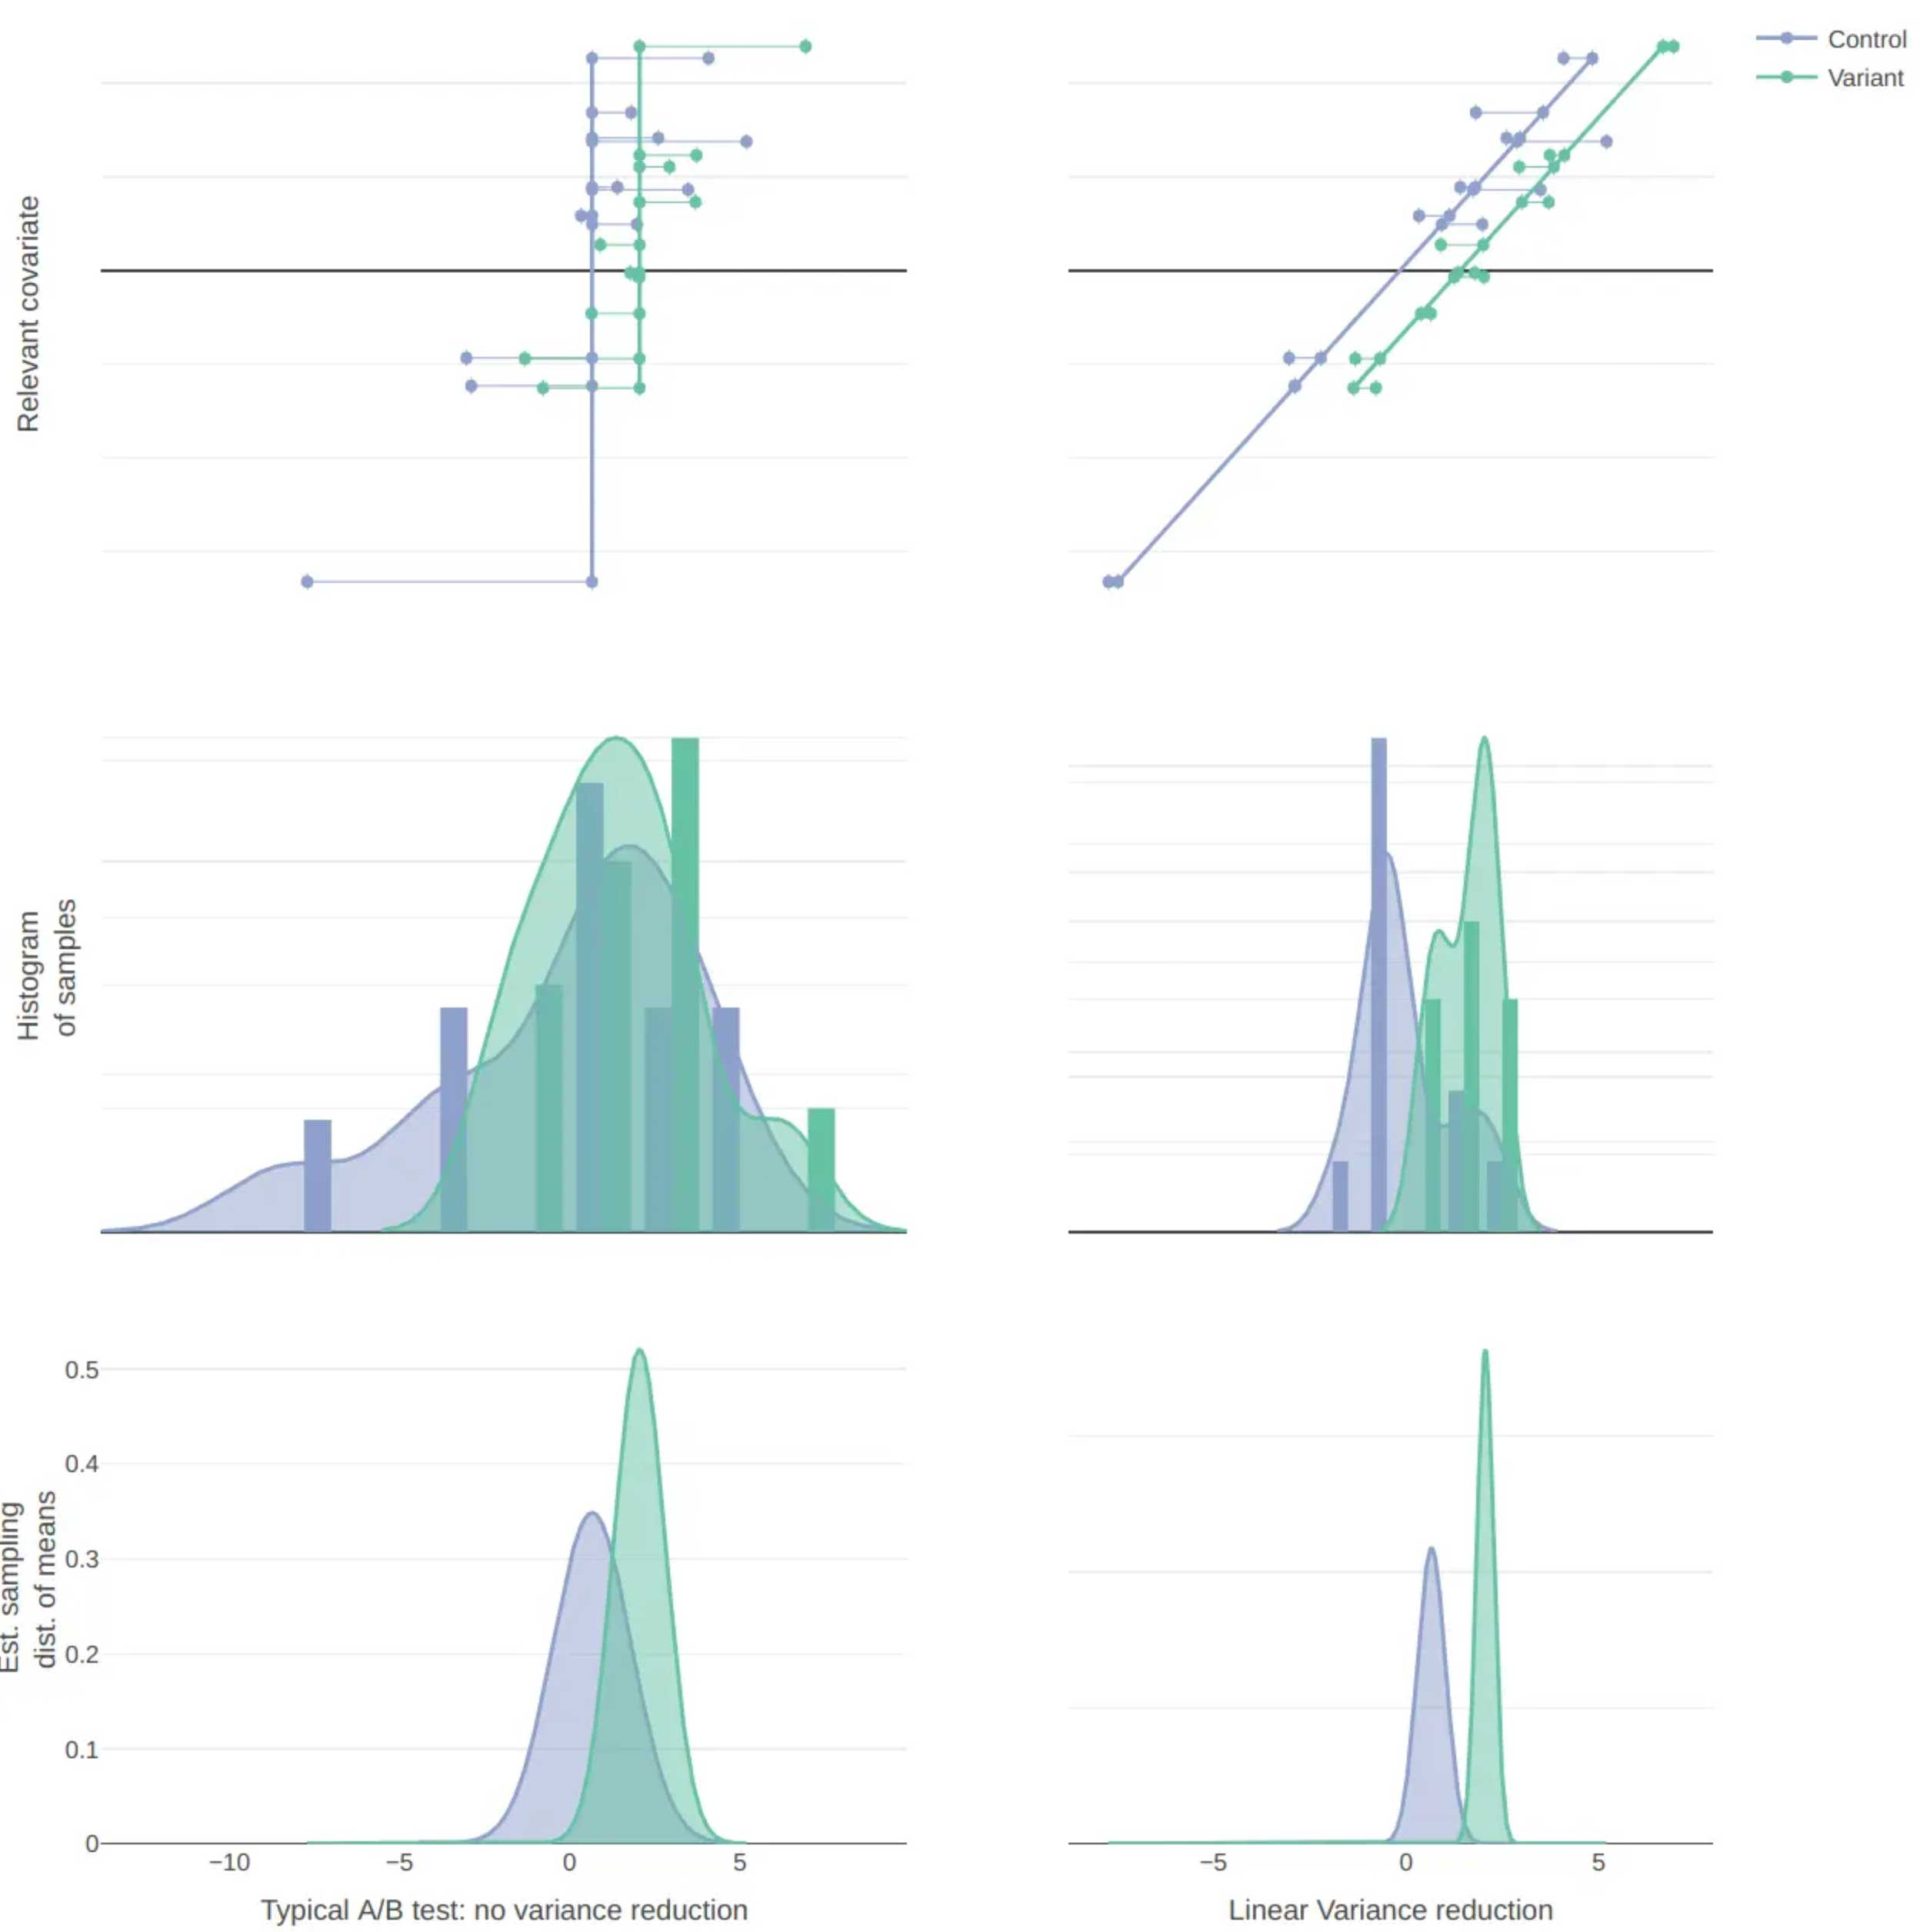
下の図では、左側の3つのプロットは、各グループの分散が大きい場合、2つのグループの無条件平均の差(X軸に沿った差)を見るだけでは統計的有意性を達成することがいかに難しいかを示しています。ヒストグラムは幅広く、バリアントとコントロール間の多くの点が重なっているため、平均分布に真の差があるのか、それとも単なるサンプリングノイズなのか、確信が持てません。しかし、右側のグラフでは、モデリングにおいて線形に関連する共変量を制御できます。これにより、測定の分散が減少します。言い換えれば、条件付き平均の周りのばらつきが小さくなるため、統計的検出力が高まります。
しかし、運転で遭遇するような複雑な非線形関係を持つ多くの共変量を調整する場合、CUPED手法はうまく機能しないことがわかりました。
運転性能を測定する際には、静的な風景の違い(例:バスレーン、横断歩道)、動的なエージェント(例:交通密度、自転車の存在)、環境要因(例:天候、明るさ)、さらにはドライバーの人間のバイアスなど、多くの交絡変数をテストに組み込む必要があります。これらはしばしば複雑な非線形相互作用も持ちます。より複雑な機械学習モデルを構築することで、これらの共変量を制御するためのより洗練された代理を提供できます。
MLRATEにより、MLモデルを用いて堅牢な方法で分散を低減できる
機械学習調整済み処置効果推定器(MLRATE、Meta 2022)を使用することで、機械学習モデルがそのような交絡変数と性能との間に学習できる複雑な非線形関係を利用できます。MLRATEは、一般化線形モデルを使用してこれを堅牢な方法で実装することを可能にします。これにより、より少ないサンプルで統計的有意性を達成できます。Wayveでは、MLRATEを使用してサンプルサイズを半分に削減しながらも統計的有意性を達成することができました。これは、実験作業負荷の効率化と、堅牢な洞察を得るために必要なテスト期間を半分に短縮したため、非常に大きな成果です。
MLRATEは、MLモデルを使用して分散を低減するために2つのステップを踏みます。最初のステップでは、関連する共変量を使用して性能指標を予測する機械学習モデルを構築します。2番目のステップでは、これらの予測を一般化線形モデルの制御変数として使用します。
ステップ1:MLモデルのトレーニングとキャリブレーション
すべての望ましい共変量を制御するために、まず関連する共変量を使用して性能指標を予測する機械学習モデルを構築します。
私たちは、風景、動的なエージェント、環境要因など、制御したいすべての特徴量を使用して、バランスの取れたデータセットで人工ニューラルネットワーク(ANN)をトレーニングします。ANNは予測に過度に自信を持つ傾向があるため、等尺性回帰を使用して、性能予測が実際の性能と線形に関連するようにします。このキャリブレーションはステップ2で重要になります。
実際には、トレーニングデータを2つのデータセットにランダムに分割します。同じアーキテクチャを持つ2つの性能予測モデルを、それぞれのデータセットでトレーニングおよびキャリブレーションします。次に、データセット内の各サンプルについて、トレーニングに使用されなかったモデルを使用して性能を予測します。この「クロスフィッティング」という、サンプル外予測を使用する方法は、サンプル内予測を使用した場合に過学習によって生じる可能性のある減衰バイアスを避けるために重要です。
ステップ2:一般化線形モデルを用いたML調整済み処置効果の推定
2番目のステップでは、一般化線形モデルを実行しますが、CUPEDのようにx(線形共変量)を使用する代わりに、MLRATEでMLステップからの予測をどのように組み込むかを示すためにg(X)が使用されます。
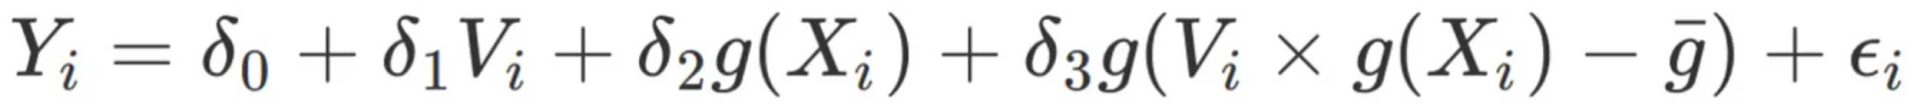
この回帰ステップにより、ニューラルネットワークの予測が不十分であっても、テストの堅牢性が確保されます。実際、ステップ1からの結果予測がどれほど悪くても、MLRATEは通常の差の平均推定量よりも漸近分散が大きくありません。言い換えれば、MLRATEは前のステップからのニューラルネットワーク予測が良好であれば恩恵を受けます。しかし、ニューラルネットワーク予測が不十分な場合でも、分散の増加に対して堅牢です。
重み付けによるモデル比較の調整
Wayveでは、MLRATEの手法をさらに一歩進める必要があります。私たちは、特定の運転シナリオ属性のルートにより適した比較を可能にするために、モデル評価を調整します。
例えば、当社のモデルは主にロンドンのキングスクロス付近の時速20マイル、交通密度の高い道路でテストされているかもしれません。しかし、当社の食料品配送パートナーが使用する典型的なルートでは、時速30マイル、複数車線の交通密度の低い道路が多くあります。したがって、食料品配送ルートの目標分布により良く合わせるために、比較を行う際に時速30マイル、複数車線のシナリオをより高く重み付けして、当社の指標を正規化する必要があります。私たちは、各シナリオを等しく重要であると扱うのではなく、目標分布により良く合わせるためにモデル比較を調整する再重み付けフレームワークを使用します。
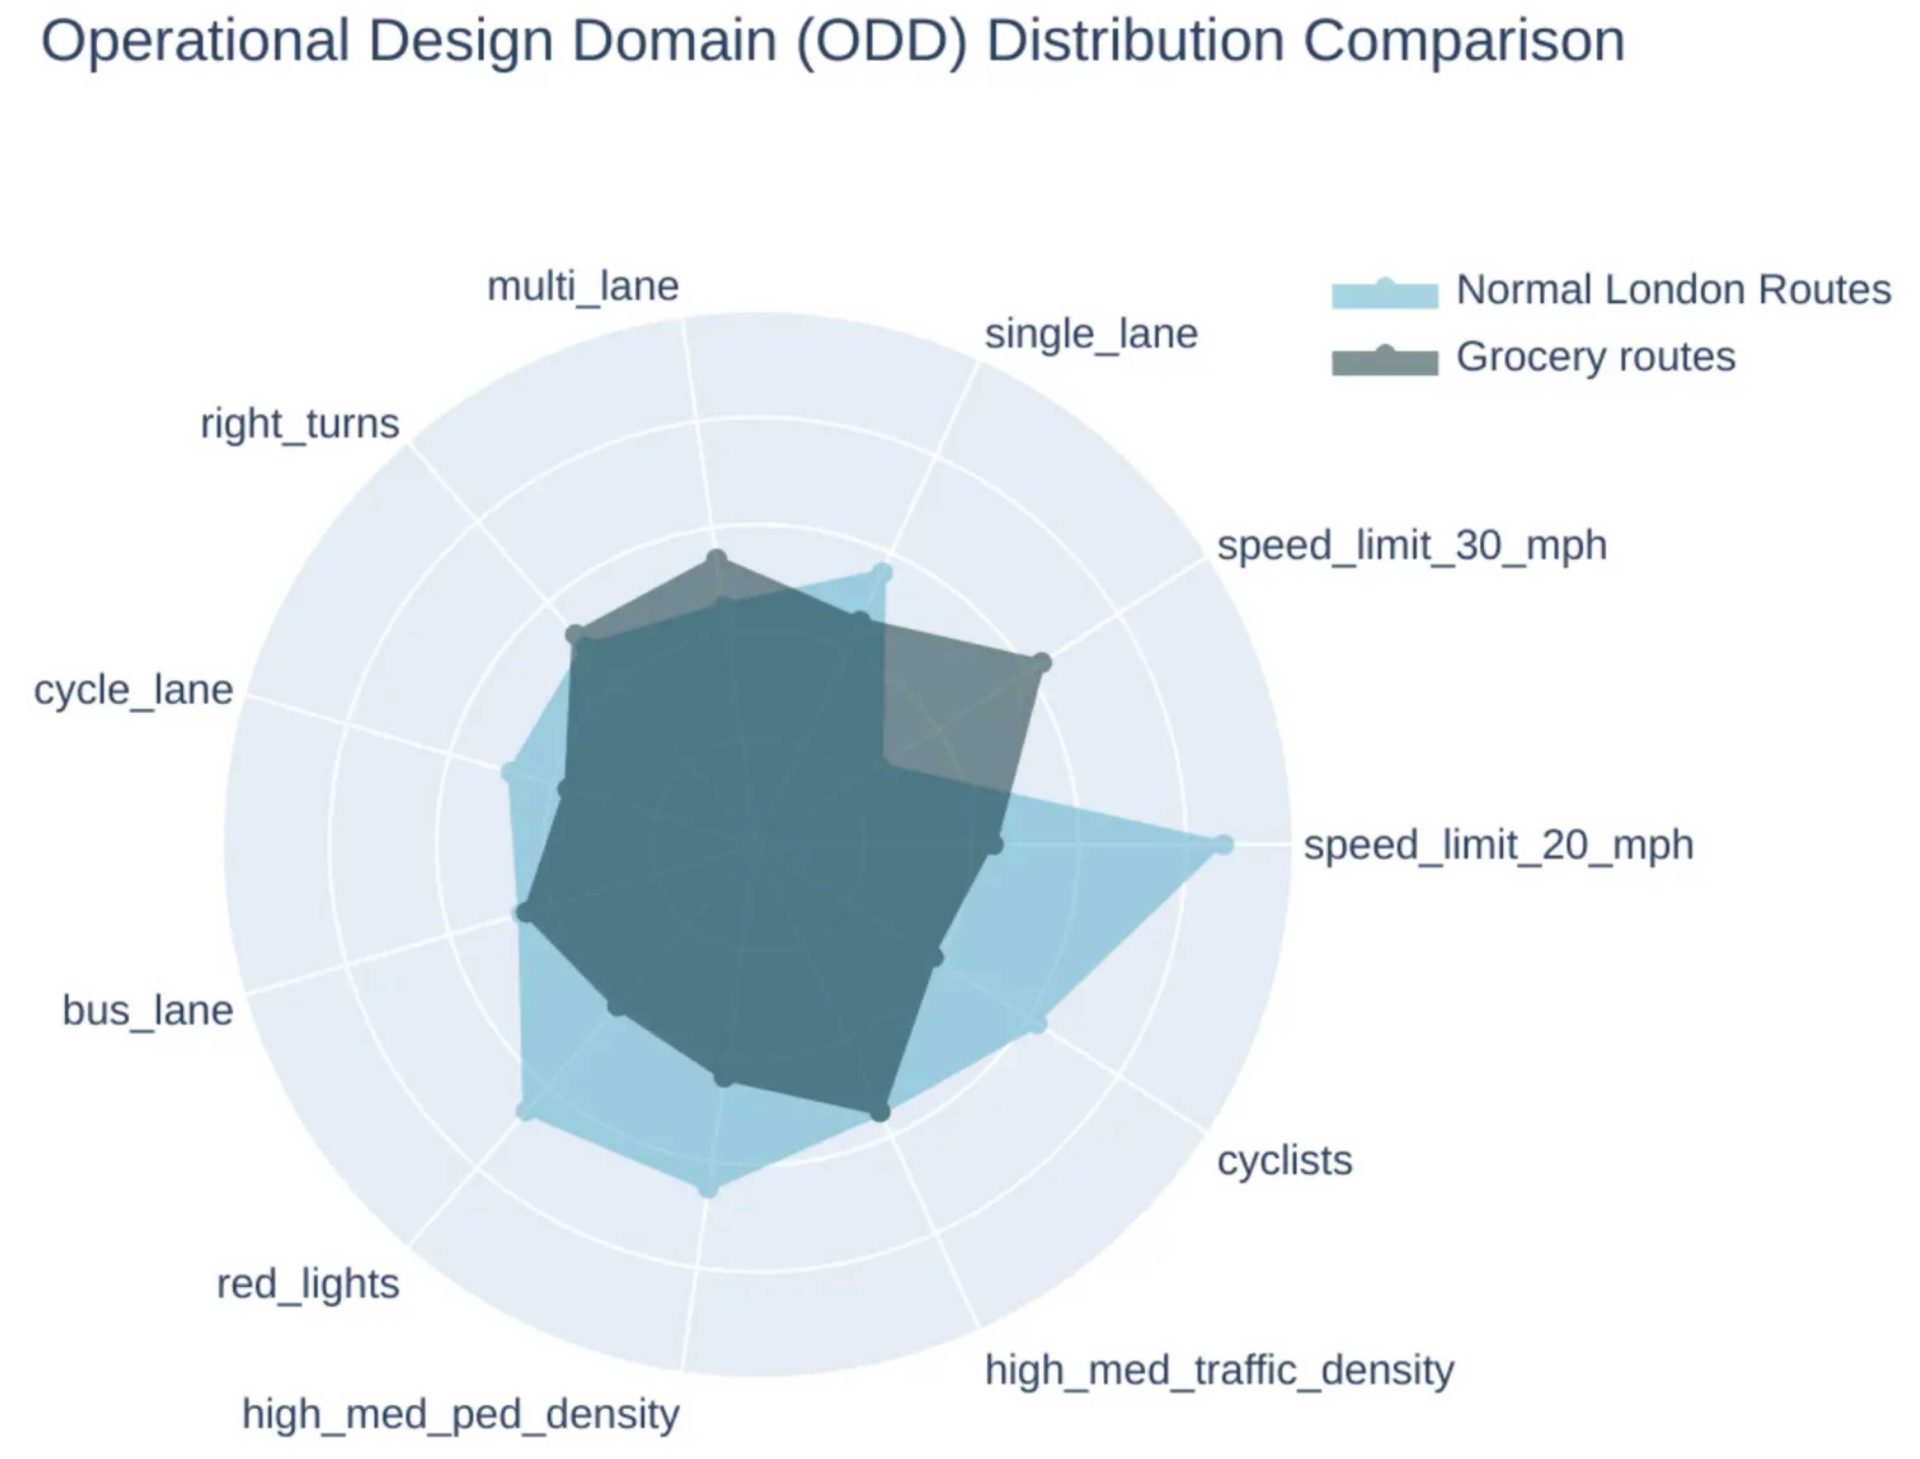
当社の再重み付けフレームワークは、意思決定科学者が調査データに対して一般化線形モデルを実行する方法に触発されました。私たちは、性能を予測するとわかっている特徴量を使用して、すべての試行(調査データにおけるデザインウェイトに類似)に対して重みを作成します。重み付けは、目標分布における関心のある特徴量の同時分布を確保するように設計されています。重みは分散を減らすために切り詰められ、MLRATEの2番目の回帰ステップで自由度が同じままであることを保証するために正規化されます。
この分析を自動化して学習を加速する
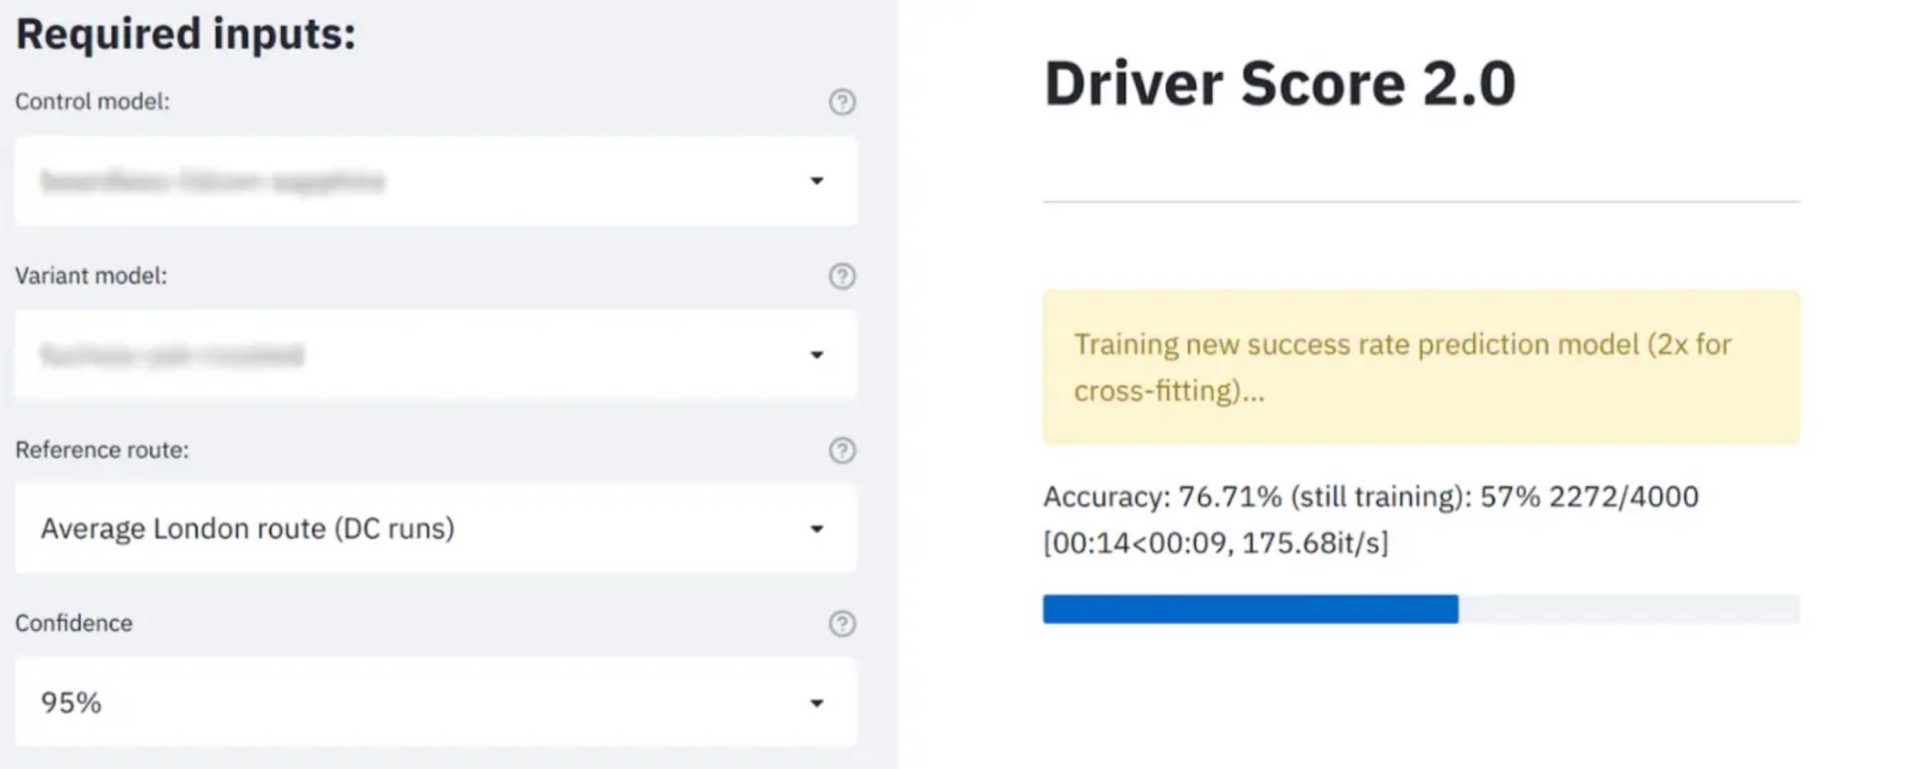
私たちは、このすべての分析をWayveの社内ツール(下の画像参照)で自動化しました。当社のML研究者は、特定のフィルターを提供し、調整したいルートを選択した後、ニューラルネットワークを自動的にトレーニングし、一般化線形モデルをオンザフライで実行できます。このデータサイエンスツールは、数分で詳細なレポートを生成し、任意の2つのモデル間の迅速かつ堅牢な比較を容易にします。これにより、チームは作業を効率化し、走行したすべてのキロメートルから洞察を引き出すことができます。
ドライバー スコア 2.0 の利点
モデル性能指標を正規化することで、モデル性能を比較する際に、より簡単またはより難しいルート間の違いを排除する共通の「基準」を持つことができました。新しい再重み付けフレームワークは、モデル比較を異なる運転ドメインに調整し、「典型的なロンドンでの運転」に対するベースラインモデル性能の経時的な改善を追跡するための、より正確で洞察に満ちた方法を提供します。
さらに、統計的に有意な結果を達成するために必要な実世界での走行量が半分で済むため、堅牢な洞察をより迅速に得ることができます。これらの改善により、より少ない時間でより焦点を絞った実験を実施することで、反復作業を加速させ、AV2.0の性能向上への取り組みを加速させます。
ありがとうございました
お読みいただきありがとうございます。この詳細な議論が、データサイエンスの最新の考え方を適用して自律走行性能を加速させている方法について、より良い理解を提供できたことを願っています。運転の独特な複雑さは、データサイエンティストが解決すべき非常に興味深い課題を提示します。これらの概念に興味があり、私たちと一緒にこれらの問題に取り組みたい場合は、私たちのチームに参加するためのWayveの募集職種がいくつかあります。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む