








22 10月 2020 | エンジニアリング
Microsoft Azureを活用した、ガレージからフリート規模への機械学習のスケーリング
Wayveのフリート学習ループは、「自宅兼オフィス」の寝室にあるサーバーで実行されていたスクリプトから、クラウドで実行されるペタバイト規模のサービスへと進化しました。この記事では、自動運転のための独自の機械学習プラットフォームを構築するにあたり、当社がどのようにMicrosoftと協力しているかをご紹介します。
Microsoft Transformブログ、こちらのWayveとMicrosoftによる声明、またはMicrosoft Igniteでのライブディスカッションで詳細をご覧ください。
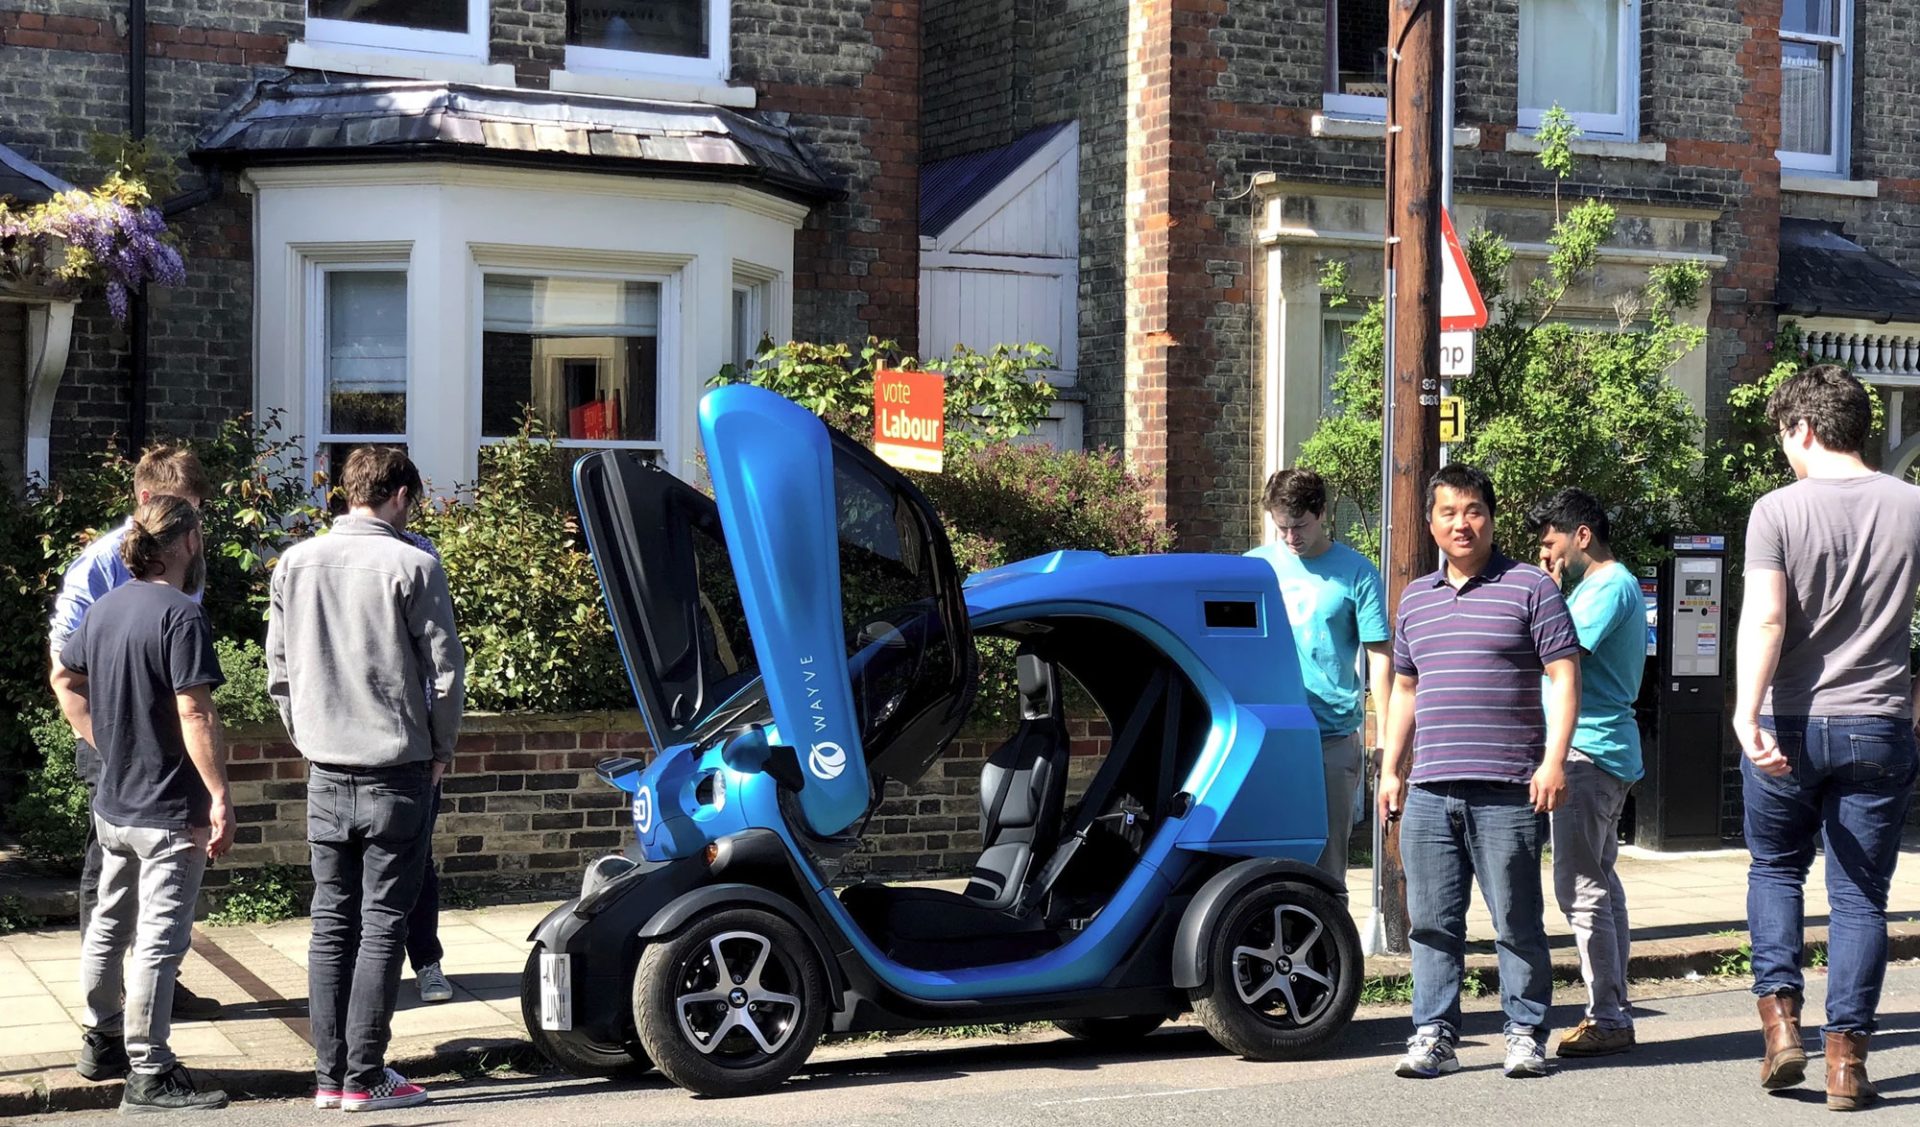
画像:すべての始まり:Wayveの自宅兼オフィス外に停車した最初の自動運転車両。
始まりの物語…
当社の自動運転システムは、あらゆるレイヤーでデータ駆動型となっており、エンドツーエンドのディープラーニングを採用することで、再設計することなく継続的な最適化を可能にしています。当社は、自動運転のための人工知能を開発するために、安全なスタートを切るための「模倣学習(Imitation Learning)」と、ポリシーを洗練させるための「強化学習(Reinforcement Learning)」というトレーニング手法の組み合わせに賭けています。
Wayveはケンブリッジで、自動運転用に改造した1台のルノー・トゥイジーからスタートしました。最初のデモでは、車上で実行される強化学習を用いて、1日で運転を学習する様子を実証しました。セーフティドライバーからのわずかなフィードバック例だけで、リアルタイムでの車線追従を学習したのです。これは、強化学習が現実世界のモバイルロボティクスにおいて十分なデータ効率で学習できることを初めて確認できた、エキサイティングな出来事でした。しかし、すべての機械学習トレーニングを車載コンピューターで行うオンラインデータに依存していたため、拡張性には欠けていました。公道へ展開するためには、より多くのデータが必要でした。
私たちはトゥイジーを使ってデータ収集を開始しました。運転免許を持つ全社員が交代で外出し、ケンブリッジ周辺をランダムに走行しました。収集したデータの時間数を示すリーダーボードまで作成したほどです!最終的に、フィルタリングを経て、約40時間の良質な運転データのデータセットを構築しました。このデータは、オフィスのサーバーにある12台のHDD(RAID構成)に保存しました。
私たちはすぐに、ほとんどの運転データが「道路を直進する」か「渋滞で停止する」かのどちらかで、非常に退屈であることに気づきました。データセットのエポックを順次繰り返すだけではうまくいきませんでした。解決策は、モデルにとって最も興味深いデータをターゲットとしてサンプリングする「運転カリキュラム」を開発することでした。このアプローチにより、最適化すべき全く新しいハイパーパラメータのセットが加わり、最終的なパフォーマンスに大きな影響を与えました。これらのハイパーパラメータの1つを変更するだけでデータセットの完全な再構築が必要となり、非常に時間がかかるため、研究の大きな摩擦となっていました。
これを解決するために、エポックという概念を完全に捨て、トレーニング時に固定ステップ数にわたってデータにランダムアクセスする方式を採用しました。これを処理するために独自のSSDオブジェクトキャッシュを構築しました。これは、中央キャッシュサーバーにホストされた市販のSSD群で構成され、キーのハッシュに基づいてデータをディスク間に分散させるデータロードロジックを備えています。これにより、研究者にとっての柔軟性と、トレーニング時の高速なデータアクセスという、両方の長所を得ることができました。
これは、2019年に2,000万ドルのシリーズA資金調達を成功させるきっかけとなった、ケンブリッジの路上での条件付き模倣学習による市街地走行のデモで結実しました。
データ収集を毎秒500万画像にスケーリング
シリーズAの資金調達完了後、当社は拠点をロンドンに移し、広範な自動運転開発施設を構築しました。そこでは、データ収集と自動運転車両の試走をサポートするために、専任の車両運用チームがフルタイムで稼働しています。現在、当社は3種類のデータを収集しています。
- エキスパート・ポリシー運転データ:プロのシャフドライバーチームが、年間12ペタバイト以上の生運転データを収集しています。
- オンポリシー運転データ:経験豊富な自動運転セーフティドライバーのチームが、当社の自動運転Jaguar I-PACEプラットフォームを使用して、年間6ペタバイト以上の生運転データを収集しています。
- オフポリシー運転データ:これらに加え、当社の自動運転センシングプラットフォームをサードパーティの外部フリートに展開し、外部フリートから数百ペタバイトの運転データを収集しています。これが経済的に可能なのは、当社の無駄のないカメラファーストのアプローチがあるからです。
Wayveのフリート学習ループ(Fleet Learning Loop)
このデータストリームは、当社の「フリート学習ループ」への入力となります。これは、データの収集、キュレーション、モデルのトレーニング、再シミュレーション、そしてフリートへの展開前のモデルのライセンス付与という継続的なサイクルです。このループはWayveの自動車教習所のようなもので、研究者が開発した「脳」を取り込み、大規模にトレーニングとテストを行います。
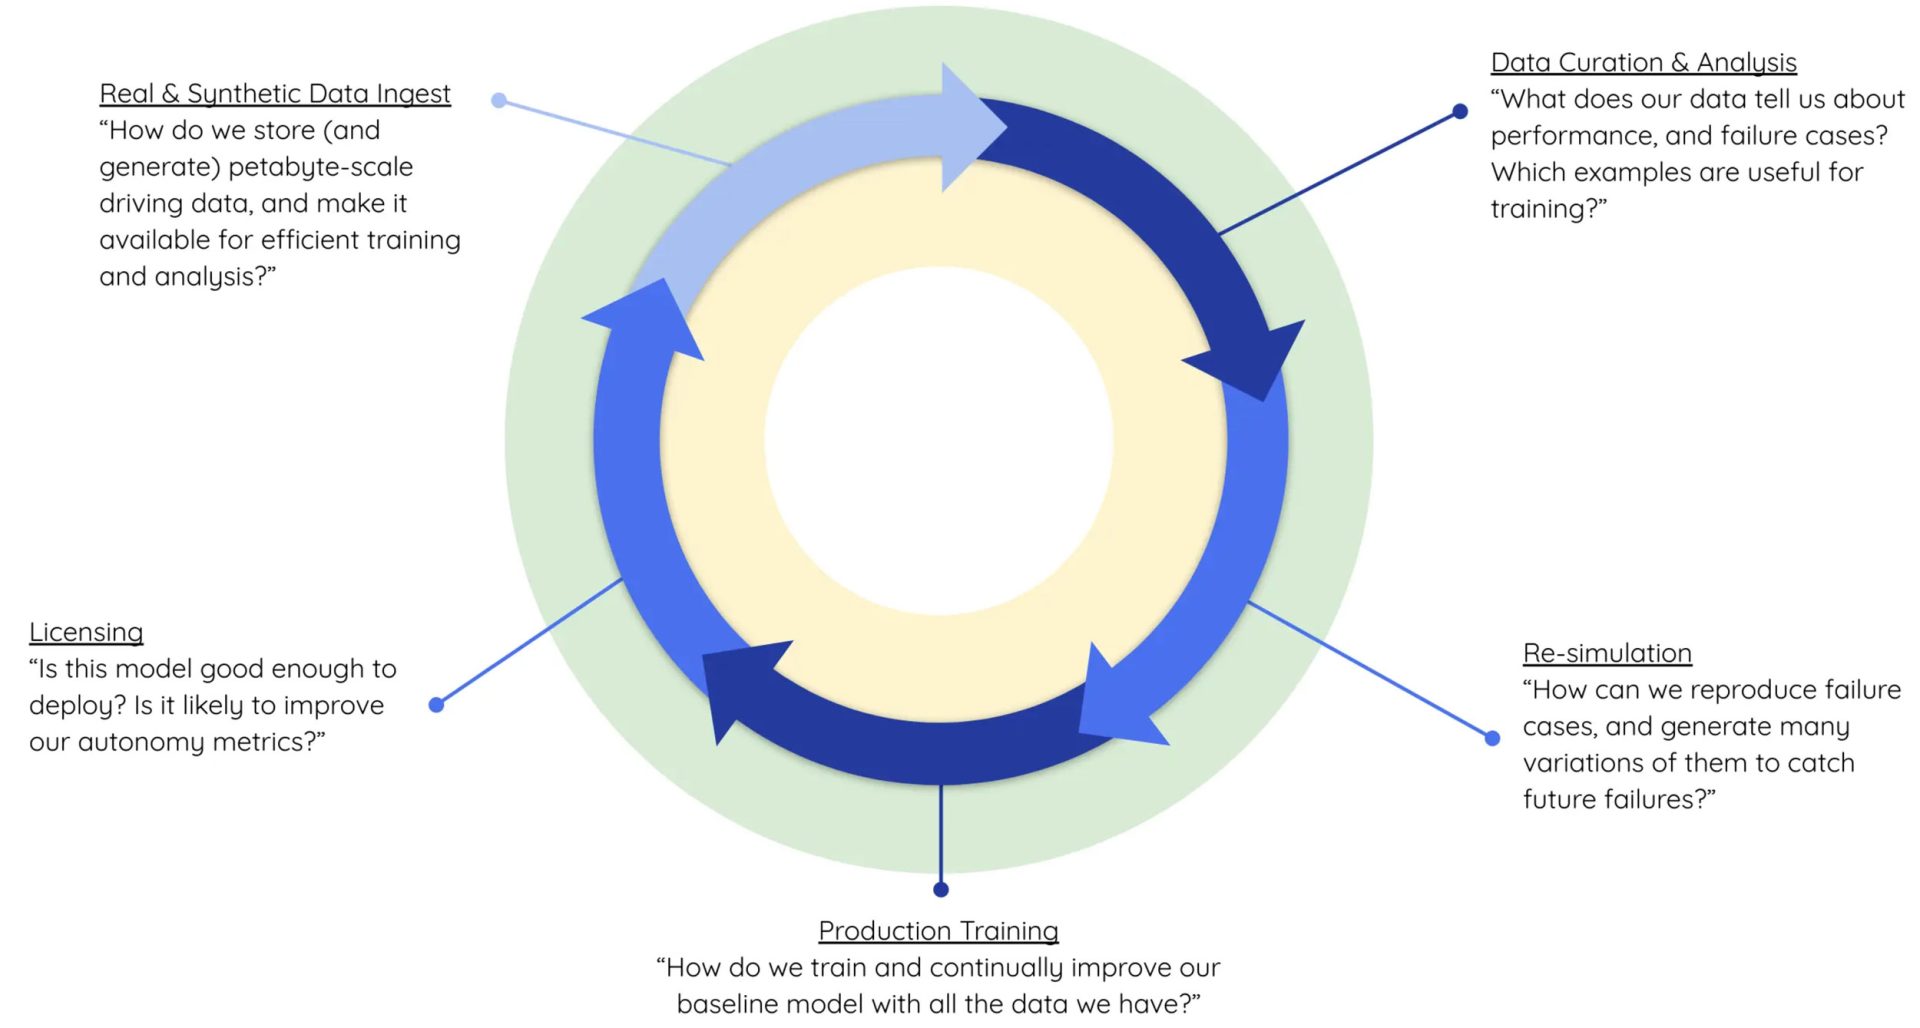
リアルデータと合成データのインジェスト
最初のステップは、車からデータを取り出すことです。ケンブリッジでは、車のコンピューターをLANに接続し、rsync(リモート同期ユーティリティ)でデータを転送していました。しかし、これでは速度が遅く、車のディスク容量が不足することが頻繁にありました。
これをスケーリングするために、独自のインジェストステーションを開発し、車にアクセス可能なSSDキャディを設置しました。これにより、運用チームは走行・テスト終了後にディスクを素早く交換できるようになりました。これにより、本社から離れた他の都市での運用も可能になります。十分なディスク供給があれば、容量不足が問題になることはありません。
サードパーティの外部フリートについては、4G接続とMicrosoft Azure IoTサービスを使用してデータをインジェストしています。
また、Kubernetes上で実行されている社内シミュレーターの複数のインスタンスである「バーチャルフリート」からも、合成データを継続的に収集しています。
データのキュレーションと分析
データの規模が数桁大きくなるにつれ、トレーニング用のデータをクリーニングし、充実させるためのアプローチもスケーリングさせる必要がありました。
ケンブリッジでは、データの事前処理にpandas(データ分析ライブラリ)を使用し、キャッシュを利用して高速化を図っていました。ラベルについては、ルートコマンドに基づく条件付き模倣学習を可能にするため、データに手動でラベルを付ける独自の基本的なUIを使用していました。
I-PACEフリートでの初期の実験を開始すると、さらなるスケーリングが必要なことが明らかになりました。そこで、データ事前処理パイプラインの重労働を担うためにApache Beamを採用し、ラベル付けの自動化のためにサードパーティプロバイダー(HERE MapsおよびScale AI)と連携しました。
この段階の最終目標は、データの分布と多様性を理解し、研究の指針となる洞察を抽出することです。静的および動的な環境に関するメタラベルや、その時のドライバーの意図(現在の「運転タスク」)を付与することで、データを充実させます。この強化プロセスを、自動運転データとエキスパートのデモンストレーションデータの両方に適用します。これにより、パフォーマンスの現状と、改善が必要な箇所を詳細に把握することができます。
エキスパートデータと実際の失敗事例をリンクさせることで、エキスパートデータのカリキュラムにおけるギャップやバイアスを表面化させます。一般的な失敗事例が見つかった場合は、データの中から同様の例を探し、トレーニング時の重みを高めます。十分な例がない場合は、データ収集の取り組みを再調整するか、必要に応じて人間によるラベル付けに追加のデータを送ります。このようにして、パフォーマンスを向上させ、運転におけるエッジケースのロングテール分布に対処するために、データカリキュラムを継続的に洗練させています。
再シミュレーション
システムがどこで、なぜ失敗するのかを理解することは極めて重要です。これにより、信頼性と安全性を向上させることができます。「再シミュレーション」を使用して、システムが何を認識しているかを把握し、その意思決定プロセスを分析する必要があります。
再シミュレーション中、運転モデルはシミュレーション環境に置かれます。現実世界で収集された、あるいは合成的に生成されたセンサーデータの形で入力を与え、モデルがどのような行動を選択するかを確認します。その後、内部情報を調査して、なぜその決定を下したのかを分析できます。例えば、認識出力を確認して、道路上の歩行者や障害物を「見て」いたかどうかを確認できます。
また、再シミュレーションにより、今後開発する運転モデルに対して回帰テストの一種を実行することも可能になります。新しいモデルを同じ再シミュレーションプロセスにかけることで、同じ条件下でどのようなパフォーマンスを発揮するかを比較できます。このプロセスにより、失敗の原因となった環境やシナリオの3D合成ツインを作成することも可能になります。合成環境があれば、合成データの収集や、そのシナリオに関連する回帰テストの多くのバリエーションを実行できるようになります。
プロダクション・トレーニング
Wayveにおけるモデル開発には3つのステージがあります。
- 機能開発:小規模な(開発用)データセットを用いた、個々の機能(例:信号機のインテリジェンス)の高速な反復トレーニングとテスト。
- 製品ベースライン機能統合:マルチタスク学習を用いてすべての機能をエンドツーエンドの学習済み運転ポリシーに統合し、最新かつ最高のモデルを形成。
- プロダクション・トレーニングと、当社の自動運転製品ベースラインの継続学習。
プロダクション・トレーニングとは、全データセットを使用して製品ベースラインを多くのエポックにわたってトレーニングし、フリート学習ループの反復を通じて新しいデータを収集するたびに継続的に再トレーニングすることを意味します。ここに計算予算の大部分を費やすため、新しいモデルはプロダクション・トレーニングを開始する前に、再シミュレーションや小規模なテストでその価値を証明しなければなりません。
現在、トレーニングには最大8枚のV100 GPUと612GBのRAMを搭載したマシン群を使用しています。理論上のスループットが最大400Gbpsになるようにデータを分散させています。この目標に向けたステップの一部として、現在および将来のニーズにより良く適合するよう、インフラをより弾力的なものに変更しています。
運転免許(ライセンス付与)
初期の頃、私たちは管理されたオフロードのサーキットで運転モデルをテストしていました。新しいモデルのテスト準備が整うと、基本的なテストを経てトゥイジーにアップロードされました。オフロードテストではこれで十分でしたが、公道テスト(管理が難しく、より複雑な環境での相互作用)においては、安全性がはるかに大きな懸念事項になることに気づきました。私たちは、人間の場合どのようになされているかを考えました。人間は通常、ルールを学び、理論を学び、監督下で練習を行います。そして最終的に公道に出る準備ができたら、一連の特定のテストを受けてスコア(または一連のスコア)を取得し、基準を超えれば免許が交付されます。これを運転モデルにも適用できないでしょうか?こうして、Wayveにおける「運転免許(Driver Licensing)」の概念が誕生しました。
運転モデルのトレーニングが完了すると、実データと合成データの両方を用いた一連の実技テストを行い、その「新人ドライバー」が公道テストフェーズに進むのにどれだけ適しているかを評価します。テストに合格すると、「新人ドライバー」には、どのような種類の公道テストが許可されるかを示す一連の免許が発行されます。
運転免許プロセスでは、この「新人ドライバー」が過去の他のドライバーと比較して、さまざまなタスクでどの程度のパフォーマンスを発揮したかに関する膨大なメトリクスやその他のデータを取得することもできます。これらはリーダーボードやその他のA-B比較ビューの形式で表示できます。これらのメトリクスにより、トレーニングした運転モデルのパフォーマンスという観点から、私たちの進捗を追跡することも可能になります。
自動運転によるループの完結
フリート学習ループのすべてのステージを通過すると、新しい運転体験とトレーニングデータを収集するために、自動運転モデルを展開する準備が整います。以下は、当社のフリート学習ループによってトレーニングされた、エンドツーエンドのディープラーニングを使用してロンドンの道路を走行する当社のテクノロジーのデモンストレーションです。
こちらは、当社のシステムがロンドンの交通、ラウンドアバウト、そしていくつかの道路工事現場を自律的に走行するビデオです。
この映像は、当社のシステムがロンドンの交通、ラウンドアバウト、そしていくつかの道路工事現場を自律的に走行する様子を示しています。
この映像は、ロンドン中心部の住宅街を走行する当社のシステムを示しています。
Microsoftとの提携
多様で膨大な運転データでトレーニングを行うためのフリート学習プラットフォームを構築するという当社の野望の規模を考えると、クラウドへの移行が必要であることはすぐに明らかになりました。
当社のストレージおよびトレーニング(GPU計算)ワークロードについて、クラウドとオンプレミスを比較するコストモデルを構築し、数年間にわたる総所有コスト(TCO)を比較しました。その結果、適切なアーキテクチャを採用すれば、データ規模が3ペタバイトを超えると、クラウドのコストは実際にオンプレミスと同等になることがわかりました。さらに重要なことに、データ量が増えるほどクラウドの競争力は高まり、規模に応じて節約額が増加します。
そこでクラウドへの移行を決めましたが、どのクラウドを選ぶべきか?コスト、技術、戦略的整合性など、多角的な側面から検討した結果、Microsoft AzureがWayveにとって最良の選択であることは明らかでした。
コスト面では、特にローカル冗長ストレージ(LRS)と予約容量ストレージのオプションにより、Azureが明らかに優れていました。当社は継続的に新しいデータを収集しているため、データの一部が失われてもビジネスに大きな影響を与えないことから、LRSは当社にとって素晴らしい選択肢です。
当社はデータ用に「アーカイブ」と「ホット」の2つのストレージ階層を採用しました。すべてのカメラのフィルタリングされていないフルサイズの画像データはアーカイブストレージに保持し、ホットストレージには最新のトレーニングカリキュラムに関連するデータのみを保存します。トレーニング画像(ホット)ストレージには、GPUにデータを供給し続けるために非常に高いスループットが必要です。PyTorchが提供するパイプライン化されたデータロードのおかげで、レイテンシはそれほど大きな懸念事項ではありません。これによりAzure Blob Storageを使用することができ、インフラを大幅に簡素化できました。
私たちは、GraphcoreのIPUからNVIDIAのA100 GPUに至るまで、最先端の計算技術をクラウドサービスに導入するMicrosoftの革新的なアプローチに特に感銘を受けました。プロダクション・トレーニング用の費用対効果の高いGPU計算を実現するために、予約インスタンスとスポット(プリエンプティブル)インスタンスを組み合わせて使用しています。予約インスタンスにより、強制終了の心配なくベースロードに対応でき、スポットインスタンスはバースト的なワークロードに対する優れたソリューションとなります。
さらに、Azure IoTサービスは、当社がフリート全体に展開するコネクテッドビークルハードウェアをサポートするための多くのインフラを提供しています。
最後に、私たちがMicrosoftとのコラボレーションに意欲的である理由は以下の通りです:
- 自動車業界における既存のパートナーシップを活用して、当社の製品を商業化できる可能性があること。
- 自らその分野で直接競合するのではなく(例:Google/AlphabetとWaymo、AmazonとZoox)、ディープテックのパートナーおよびイネーブラー(実現者)であるという彼らの全体的な戦略。
- Azure Machine Learningのようなサービスや、業界をリードする企業とのパートナーシップを通じて培われた、大規模な機械学習における彼らの経験。
まとめ
創業初期、私たちは少量のデータで市街地走行ポリシーを学習できることを示しました。私たちはこの研究アプローチを継続し、モデルを「フリート学習ループ」へと送り込んでいます。これはMicrosoft Azure上で稼働するWayveの自動車教習所です。ここで、ペタバイト規模のリアルデータと合成データを用いてモデルのトレーニングと評価を行っています。
デモレベルのパフォーマンスでアプローチの有効性を証明する段階から、人間レベルの製品価値のある自動運転へと私たちを導くのは、このフリート学習ループなのです。
このテクノロジーをスケーリングするためにMicrosoftと協力できることを嬉しく思います。詳細はMicrosoft Transformブログをご覧いただくか、こちらからMicrosoft Igniteでのディスカッションをご覧ください。
4 11月 2026 | エンジニアリング
言語はAIドライバーの助手席に座るべきであり、制御ループを停滞させてはならない
学習された安全性へのアプローチを探求するシリーズの最終回では、物理的制御と安全性保証における意味的インテリジェンスの役割について考察します。
続きを読む
4 11月 2026 | エンジニアリング
Wayve AI Driverの検証
学習済み安全性へのアプローチを探るシリーズのパート2では、Validation 2.0が、単なる効率的なスケーリングを超えて、企業が自動運転製品を開発し提供する方法を根本的に再構築する様子を探ります。
続きを読む
4 11月 2026 | エンジニアリング
安全なAIドライバーの構築
学習された安全性へのアプローチを探るシリーズのパート1では、Wayveの学習された安全エンベロープ(LSE)を使用して、AIドライバーがどのように意思決定を行うかの一部として安全評価がどのように行われるかを探ります。
続きを読む